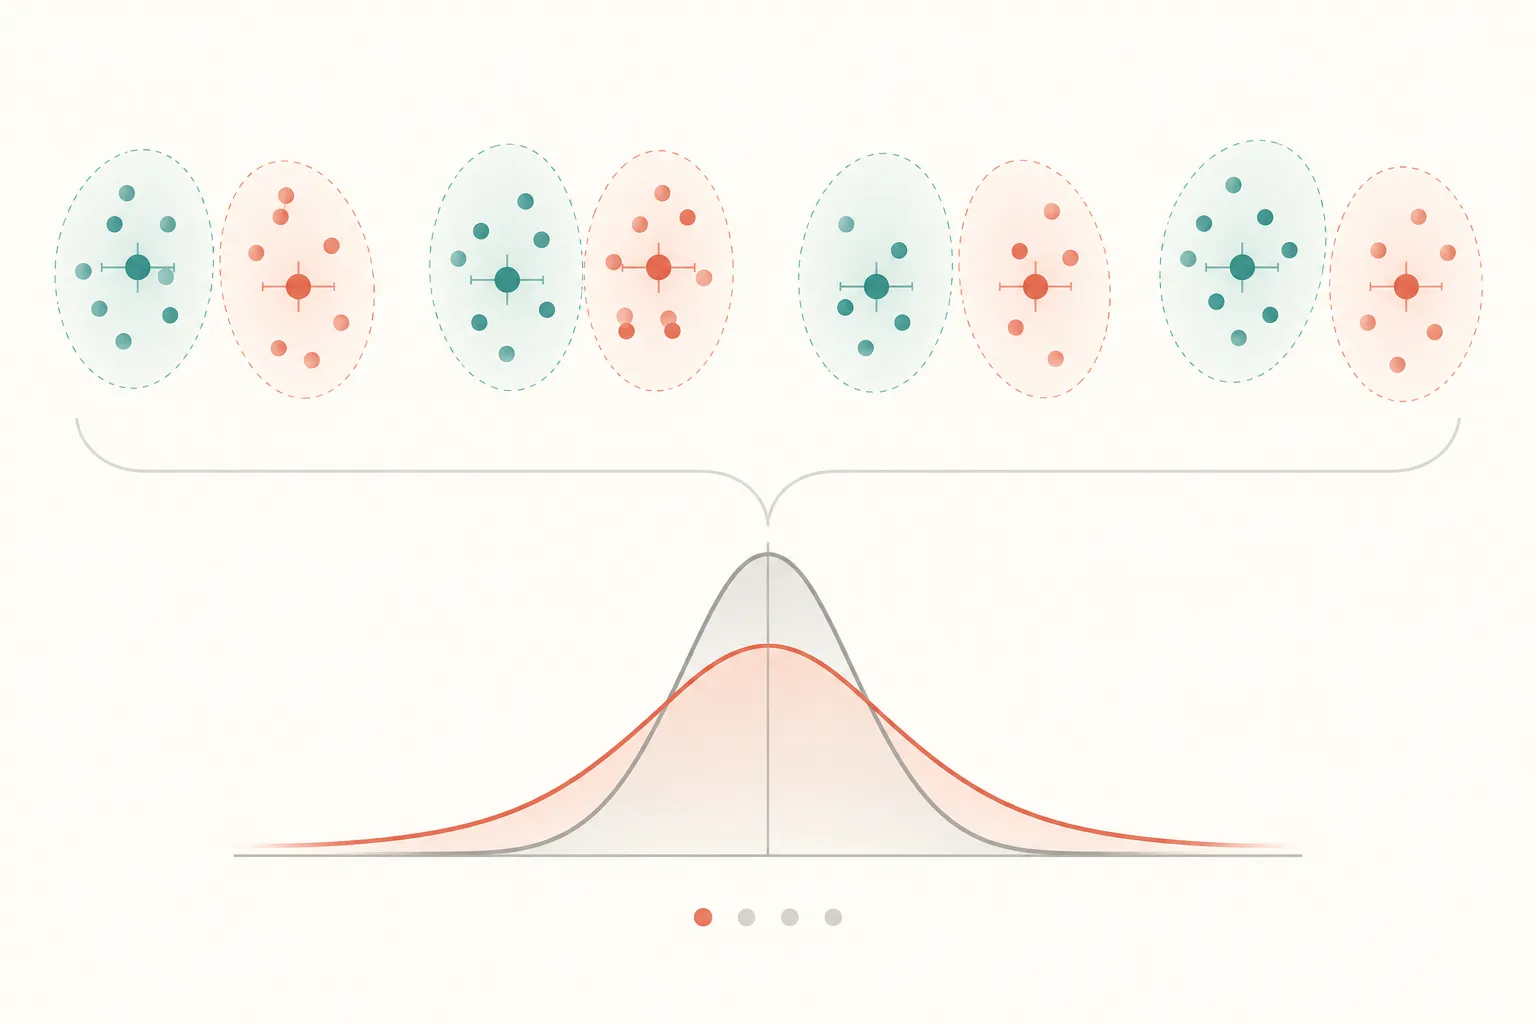
只有 8 家门店,怎样判断实验结果可信?簇随机试验的小样本推断
用户数很大也不等于独立样本很多。用簇级均值、自由度与精确随机化检验,说明小簇数实验怎样报告不确定性。
上一篇从门店成员会互相影响出发,说明了为什么要把门店而不是顾客随机分组,并用组内相关系数估算设计效应。可现在有 8 家门店、每店 500 名顾客:报表里的样本量是 4000,真正被随机分配的独立单位仍只有 8 个。若把 4000 行当作彼此独立,标准误会过小,显著性会显得过于乐观。
本篇只讲一个核心:簇数少时,推断的独立信息和自由度来自簇;先看簇级分析,再用随机化检验检验“每个簇都没有受到影响”这一尖锐零假设。下一篇将从设计阶段继续:若能先把相似门店配成对,再在每对里随机一个处理组,怎样分析这项受限随机化。
01 用户很多,为什么仍然只有几个独立单位?#
簇随机试验(cluster-randomized trial, CRT)把门店、学校或区域整体分到处理臂。对第 j 个簇记录分配 Z_j∈1、人数 n_j 和用户结果 Y_ij。先算簇均值:
i 是簇内用户,j 是独立分配的簇。处理效果可用两臂簇均值之差估计:
J_1、J_0 分别是两臂簇数,J=J_1+J_0。这里让每个簇均值等权,对应“平均门店”的效果;若目标是平均顾客效果,按人数加权可能更贴切,但方差和估计目标也会改变,不能先挑能出显著结果的权重。
上一篇的设计效应处理簇内相关导致的方差膨胀,却没有回答小簇数下的第二个问题:要估计多少个独立簇级误差项?即使每店人数趋向无穷大,被分配的簇数也不会增加。小样本误差分布通常比标准正态更重尾;分母自由度不能用顾客数减二。
flowchart LR
  A[用户级结果 Y_ij] --> B[保留 cluster_id 与分配 Z_j]
  B --> C[聚合成每簇摘要 Ybar_j]
  C --> D[按预设目标估计处理效应]
  D --> E{独立簇数是否足够}
  E -->|较少| F[簇级小样本方法或设计随机化检验]
  E -->|较多| G[簇稳健模型并核对小样本修正]
  F --> H[报告簇数、自由度和推断边界]
G --> H02 手算:每臂 4 家店,自由度不是 3998#
假设处理组四家店的平均转化率(百分点)为 12、14、15、19,对照组四家为 8、10、11、13。各簇等权,处理均值是 15,对照均值是 10.5,效应估计为 4.5 个百分点。两臂簇均值样本方差分别为 9.33 和 4.33。用等方差的经典两样本 t 近似,合并方差为 6.83,标准误为:
因此 t=4.5/1.31≈3.44,自由度是 4+4−2=6,不是 3998。小自由度下的临界值和 p 值与 z 检验明显不同。这个 t 计算还假设簇级误差独立、近似正态、两臂方差相等;只有 8 个簇时这些假设本身难验证,不能把算例当通用解法。
| 独立簇数 | 平衡分组的朴素残差自由度 | 常见误读 |
|---|---|---|
| 8(每臂 4) | 6 | 用顾客行数减 2 |
| 12(每臂 6) | 10 | 用请求数当样本量 |
| 40(每臂 20) | 38 | 以为任意簇稳健标准误已自动可靠 |
若簇级回归再拟合协变量,残差自由度还要减去实际拟合的簇级参数;若随机化受限于区组,分析也应反映区组设计。表格只适用于无协变量的平衡两臂例子。
03 设计已知时:枚举允许的随机分配#
随机化检验(randomization inference)不先假设簇结果服从正态,而是把实验实际允许的每种分配重放一遍。在尖锐零假设(sharp null)下,每个簇的处理潜在结果等于对照潜在结果,因此观察到的结果在所有分配下固定。将每种合法分配的效应差与观察效应比较,就得到精确检验。
设 6 家店的观察均值是 [8, 9, 10, 11, 12, 13],事先规定 3 家处理、3 家对照。观察到最高三家为处理,均值差为 12−9=3。合法分配数是 C(6,3)=20。只有最高三家处理和最低三家处理这两个互为相反的分配,产生绝对值至少为 3 的差,因此双侧 p=2/20=0.10。趋势整齐,证据分辨率仍不足以在 5% 水平拒绝零假设。
from itertools import combinations
from math import comb

def exact_cluster_randomization_p(cluster_means, treated_clusters):
    """完全随机分配、簇等权、双侧绝对差;检验 sharp null。"""
    j = len(cluster_means)
    if not 0 < treated_clusters < j:
        raise ValueError("treated_clusters must be between 1 and J - 1")

    observed_set = set(range(j - treated_clusters, j))

    def difference(indices):
        control = set(range(j)) - indices
        mt = sum(cluster_means[i] for i in indices) / len(indices)
        mc = sum(cluster_means[i] for i in control) / len(control)
        return mt - mc

    observed = difference(observed_set)
    extreme = 0
    total = 0
    for chosen in combinations(range(j), treated_clusters):
        total += 1
        if abs(difference(set(chosen))) >= abs(observed) - 1e-12:
            extreme += 1

    return {
        "effect": observed,
        "extreme_allocations": extreme,
        "valid_allocations": total,
        "p_value": extreme / total,
        "check": comb(j, treated_clusters),
    }

print(exact_cluster_randomization_p([8, 9, 10, 11, 12, 13], 3))
# effect=3.0, extreme_allocations=2, valid_allocations=20, p_value=0.1输入是 J 个簇均值和处理簇数;输出等权效应、极端分配数、合法分配数和精确 p 值。itertools.combinations 枚举固定处理簇数下的集合,复杂度随 C(J,J₁) 增长;簇很多时可按真实设计做蒙特卡洛抽样。math.comb 用来核对空间大小。这里用 Python 标准库而不依赖统计黑盒,展示有限枚举本身。
随机化空间必须和实施方案一致。若按地区分层、先匹配再分配,不能任意重排全部标签;应只重放当时可能出现的分配。代码假定无缺簇、簇结果固定、等簇加权。簇大小变化或目标是平均顾客效果时,应预先选择相应统计量。
04 精确 p 值回答了什么?#
枚举的精确性针对“每个单位都没有任何处理效应”的尖锐零假设。它不自动给出平均处理效果为零这一弱零假设的精确检验,也不自动生成平均效果置信区间。若要检验恒定加性效应,可对一系列候选效应反演检验;若处理效果因簇而异,这个恒定效果假设就未必可信。
| 方法 | 核心依赖 | 适合回答 | 少簇时的主要边界 |
|---|---|---|---|
| 簇级均值 + t | 簇级误差分布与自由度近似 | 平均簇效果 | 正态和方差假设难检查 |
| 精确随机化检验 | 实际分配机制、尖锐零假设 | 零效果下分配有多极端 | p 值离散,功效可能低 |
| GEE / cluster-robust SE | 独立簇渐近近似 | 较多簇下总体平均效果 | 未修正时少簇可能过度拒绝 |
| 混合效应模型 | 随机效应分布与模型结构 | 个体/簇层异质性 | 方差与自由度近似可能不稳 |
少簇连续结果的模拟比较显示,4–8 个簇时各方法的第一类错误和功效差异很大;不能脱离结局分布、簇大小和分配设计,声称某方法总是安全。先列明每臂簇数与分配概率,预设主推断,辅以设计相符的敏感性分析,并说明最小可达到的 p 值。
键盘可展开:为什么 6 个簇的双侧 p 值会跳得很大
固定 3 对 3 一共只有 20 种合法分配。观察到两个最极端分配时,最小双侧 p 值已经是 2/20=0.10。原生 details 可用 Tab 聚焦摘要、Enter 或 Space 展开;窄屏可读且颜色继承站点主题。
05 工程检查:从分析表追溯随机化#
每行结果至少保留 experiment_id、cluster_id、arm、assignment_time、outcome_window 和 metric_version。运行分析前按 cluster_id 聚合并验证同一簇没有多个 arm;列出每臂簇数,不要只输出用户总数。若簇退出或完全没有结果,先判断退出机制并按预注册规则处理;删掉“不好看”的簇会改变分析对象。
调试顺序:从分配日志重建每簇唯一 arm;统计每臂簇数、人数和标签缺失率;重算簇级指标并说明等簇或按人加权;依照真实区组设计构造合法分配集合;最后将模型结果与随机化检验作为不同假设下的证据并列。若空间巨大,固定随机种子、记录抽样次数与 Monte Carlo 误差。
与相近方法的边界#
簇级分析是针对随机化单位的聚合思路;小样本修正 GEE 和混合效应模型仍是模型推断;随机化检验由分配机制定义参照分布。设计效应回答“同簇多招一人增加多少信息”,小样本推断回答“多少独立分配支撑不确定性”。多招同一门店顾客不能代替增加门店。
思考练习#
- 10 个簇按 5 对 5 完全随机,独立随机化单位数是多少?簇级两样本 t 的朴素残差自由度是多少?
- 6 个簇里 3 个处理、3 个对照,精确双侧检验的合法分配数是多少?最小 p 值意味着什么?
- 两家店先配成一对再随机,枚举时可以把它们与其他地区任意重配吗?为什么?
延伸阅读#
- Leyrat et al., Cluster randomised trials with a small number of clusters: which analyses should be used? (2018) ↗ — 比较少簇场景下的簇级分析、混合模型与 GEE。
- Thompson et al., How should a cluster randomized trial be analyzed? (2023) ↗ — 从估计目标、随机化单位与分析方法梳理决策。
- Fisher, The Design of Experiments (1935) ↗ — 随机化与尖锐零假设检验的经典来源。
- Wu & Ding, Randomization Tests for Weak Null Hypotheses in Randomized Experiments (2021) ↗ — 区分尖锐零假设与平均效果零假设推断。