标签逐步到齐时,评估值该怎样更新?延迟标签的成熟窗口与版本快照
将标签成熟、观察窗口和重复查看纳入离线策略评估协议,避免未成熟样本造成虚假的质量变化。
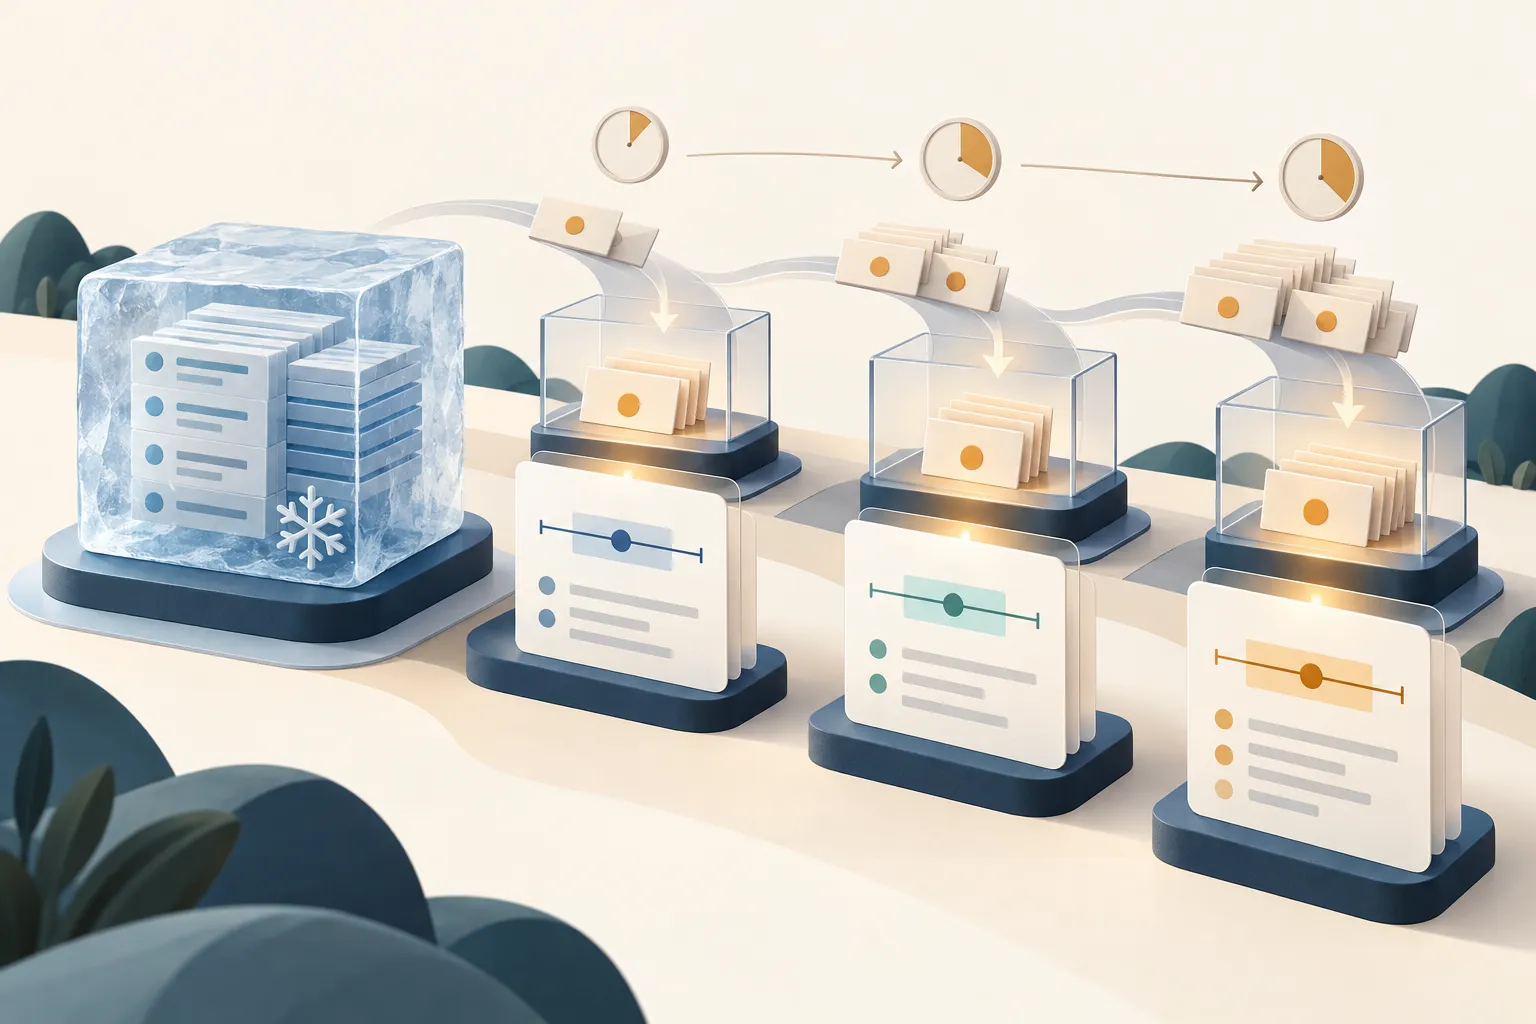
上一篇把策略评估绑定到不可变清单,回答“这次究竟评了什么”。但留存、退款、投诉等结果不会随请求同时到达:今天重跑时,新一批标签可能补齐,昨天的 cohort 看起来便突然变好或变差。若只保存一个不断覆盖的数字,无法区分真实变化、标签成熟和数据修订。
本篇聚焦:**结果延迟到达时,如何定义可比较的评估版本?**核心做法是固定决策 cohort 和策略身份,用成熟窗口判断哪些行可计分,把标签截止时刻和成熟规则写进快照;每次更新创建新快照,不改写旧结果。
01 三只时钟,不能混成一个日期#
一次决策至少有三个时间:事件发生时间 、标签可观测时间 、评估数据截点 。若结果定义为“决策后 7 天是否留存”,在用户决策满 7 天之前, 不是 0,而是尚未知。把未知记作 0 会让最近 cohort 系统性变差;只保留已到标签者又可能引入选择偏差。
还要区分数据修订时间:源事件可能迟到、去重或被纠正。它属于数据快照版本,不能靠改变标签成熟窗口暗中吸收。
flowchart LR
  A[冻结决策 cohort 与策略版本] --> B[等待结果窗口成熟]
  B --> C{标签是否到齐}
  C -->|否| D[未成熟 / 部分可观测,暂不等同失败]
  C -->|是| E[按统一规则构建 outcome]
  E --> F[配对策略分数与区间]
  G[新标签或数据修订] --> H[新评估快照 revision]
  H --> F
F --> I[保留旧版、报告变化来源]对固定的 7 日留存结果,简单成熟规则为 天。若标签管道另有最长 2 天延迟,安全截点可要求 天。实际延迟分布可能有长尾,成熟界限应由数据 SLA 与延迟分布确定,并报告越界补标率。
02 一个快照包含什么?#
定义快照 ,其摘要 。快照至少绑定:决策 cohort 的不可变 ID、入组时间范围、策略和基线版本、结果定义与观察时长、标签 watermark、允许的迟到策略、去重逻辑版本、剔除理由、估计器与切分摘要。运行时间和机器名放入 attempt;新标签截点或 outcome 逻辑改变则建立新 revision。
张量/表格形状可写成请求行 、动作 、结果 、事件时间与标签时间 。Y 应使用三态:1、0、unknown,而不是把未知压成零。筛选后有效行索引为 ,其中 是结果窗口, 是成熟保护延迟。
03 手算:表面下降是标签尚未成熟#
某策略固定处理 100 个请求,目标是 7 日留存,当前只观察到决策后 3 天:
| cohort | 请求数 | 观察年龄 | 已到标签 | 暂见留存 | 是否纳入 7 日分数 |
|---|---|---|---|---|---|
| 周一 | 40 | 12 天 | 40 | 12 | 是 |
| 周四 | 35 | 9 天 | 35 | 10 | 是(满足 7+2 天保护) |
| 周日 | 25 | 3 天 | 8 | 2 | 否,17 条仍未知 |
错误算法把周日剩余 17 条记作未留存,会报告 。按成熟 cohort 计算则是 ,但它代表的是更早的请求期。若要评估当前 cohort,须等待成熟或明确建模标签观测过程,不能把 当作周日结果。分母、cohort 范围和成熟比例都要随数值一起报告。
04 可运行的标准库成熟度计算#
以下实现接收事件时间与标签时间(UTC ISO 8601),返回每行的成熟状态、可计分的固定 cohort 指标,以及迟到率。输入列表长度均为 ,时间需带时区;输出是版本快照的一部分,而不是最终因果推断器。
from datetime import datetime, timedelta


def parse_utc(value):
    dt = datetime.fromisoformat(value.replace("Z", "+00:00"))
    if dt.utcoffset() is None:
        raise ValueError("时间戳必须带时区")
    return dt


def mature_report(event_time, label_time, outcome, as_of, horizon_days=7, lag_days=2):
    n = len(event_time)
    if n == 0 or not (len(label_time) == len(outcome) == n):
        raise ValueError("输入必须是同长度非空序列")
    cutoff = parse_utc(as_of)
    horizon = timedelta(days=horizon_days)
    grace = timedelta(days=lag_days)
    eligible, observed = [], []
    for i, (event, label, y) in enumerate(zip(event_time, label_time, outcome)):
        age = cutoff - parse_utc(event)
        mature = age >= horizon + grace
        if y not in (0, 1, None):
            raise ValueError("outcome 只能为 0、1 或 None")
        if label is not None and parse_utc(label) > cutoff:
            raise ValueError("标签时间晚于快照截点")
        eligible.append(mature)
        observed.append(mature and y is not None)
    n_mature = sum(eligible)
    n_scored = sum(observed)
    positives = sum(y == 1 for y, ok in zip(outcome, observed) if ok)
    return {
        "n_total": n,
        "n_mature": n_mature,
        "n_scored": n_scored,
        "label_completeness": n_scored / n_mature if n_mature else None,
        "rate_on_observed_mature": positives / n_scored if n_scored else None,
        "unmatured": n - n_mature,
    }


report = mature_report(
    ["2026-10-01T00:00:00Z", "2026-10-08T00:00:00Z"],
    ["2026-10-09T00:00:00Z", None],
    [1, None], "2026-10-18T00:00:00Z",
)
print(report)API 输入是 UTC 时间字符串和三态标签,输出成熟数、成熟标签完整率与观察率。生产实现还要处理业务时区的“日”边界、重试、重复事件和撤销标签;最好用 watermark 及不可变源 revision,而不是仅凭本机时钟判定。若成熟 cohort 中仍缺标签,不应静默丢行:先报告完整率,并查明缺失是否与策略动作、用户类型或结果相关。
05 部分观测时不要偷换估计目标#
成熟窗口内只算有标签者,只有在标签缺失可忽略或经建模校正时才有目标解释。若标签到达概率依赖结果或动作,完整案例均值会偏。可选方案包括等待更久、按观测概率加权并做敏感性分析、对未观测结果给上下界;每种选择都应记录在 estimand 与快照中。
对策略比较,应在同一成熟 cohort 上计算候选与基线的配对分数差 。不要拿候选的最近 7 天 cohort 与基线的上月成熟 cohort 相减。区间也应按实际独立单位聚类或按时间区块重抽样;重复用户不能当作独立请求。
06 键盘可用的复核清单#
展开:发现评估数值变化时逐项核对
- cohort ID 与策略、基线摘要是否一致?
- 标签 watermark、结果窗口与成熟保护是否一致?
- 成熟样本数、已观测比例和分群完整率怎样变化?
- 是迟到补标、标签纠正、去重逻辑变更,还是新请求进入?
- 同一批成熟行的策略配对分数是否变化?如果变化,nuisance 模型与折分是否重训?
- 是否保留旧快照并生成新摘要,而非覆盖结果?
HTML details/summary 可由键盘聚焦并用 Enter/Space 展开,窄屏自然换行,颜色继承站点主题;正式产品实现还应给状态提供文本标签,不单靠颜色区分。
07 常见失败与调试#
- **未知被写成 0:**检查 SQL
COALESCE和左连接空值;保留三态并对照成熟比例。 - **标签时间当事件时间:**两者语义不同。固定 observation window 要从决策事件起算,标签时间只说明何时可用。
- **每次重跑都用“最新数据”:**记录 watermark 和源 revision,变化就创建快照版本。
- **只报成功到达的标签:**按动作、时间、地区、设备切片检查完整率;差异提示缺失机制可能有偏。
- **把部分成熟窗口和完整历史混比:**使用固定成熟 cohort,或显式建模成熟度;不跨 cohort 偷换分母。
- **迟到补标悄悄覆盖旧图:**保存历史 revision,比较变化拆分为新行、补标签、修订和估计器变化。
- **把成熟性当作无偏保证:**成熟只解决观察窗口不足,不解决未测混杂、策略适应性选择、重叠差或目标群变化。
08 与相邻方法的边界#
| 做法 | 解决的问题 | 仍需注意 |
|---|---|---|
| 成熟窗口 | 结果尚未有机会发生 | 延迟尾部和非随机缺失仍可能存在 |
| 右删失生存分析 | 事件时间和不同随访长度 | 删失机制、风险集定义和策略因果识别 |
| 逆观测概率加权 | 已观测标签选择偏差 | 观测模型错设、极端权重与未观测混杂 |
| 评估快照 | 哪批数据与协议生成结果 | 不保证数据代表目标或因果假设成立 |
| 线上随机实验 | 在实际环境中形成对照证据 | 仍要处理延迟结果与实验单位依赖 |
09 思考练习#
- 结果窗口为 30 天、管道延迟 4 天。某用户 31 天前完成决策但标签未到,是否成熟?怎样报告?
- 标签缺失率在策略组为 2%,对照组为 12%。完整案例策略差还能代表什么目标?还需要哪些数据?
- 同一快照重跑时,发现 20 条旧标签被纠正。你会如何保存 revision,并把指标变化拆分为补标、修订和数值重算?
相关工作#
- Hernán & Robins, Causal Inference: What If ↗:目标试验、随访和因果估计的系统教材。
- Hernán et al., Specifying a target trial prevents immortal time bias and other self-inflicted injuries ↗:说明时间零点与随访定义错误如何造成偏差。
- Seaman & White, Review of inverse probability weighting for dealing with missing data ↗:回顾缺失数据的逆概率加权条件与限制。
- Robins, Rotnitzky & Zhao, Estimation of regression coefficients when some regressors are not always observed ↗:建立缺失数据加权估计的重要基础。
10 下一篇预告#
成熟标签快照回答“现有证据何时可比”。下一篇转向持续运行:当流量、人群和资源条件变化时,怎样监控冻结策略,避免把策略本身改变造成的反馈误判成模型漂移?