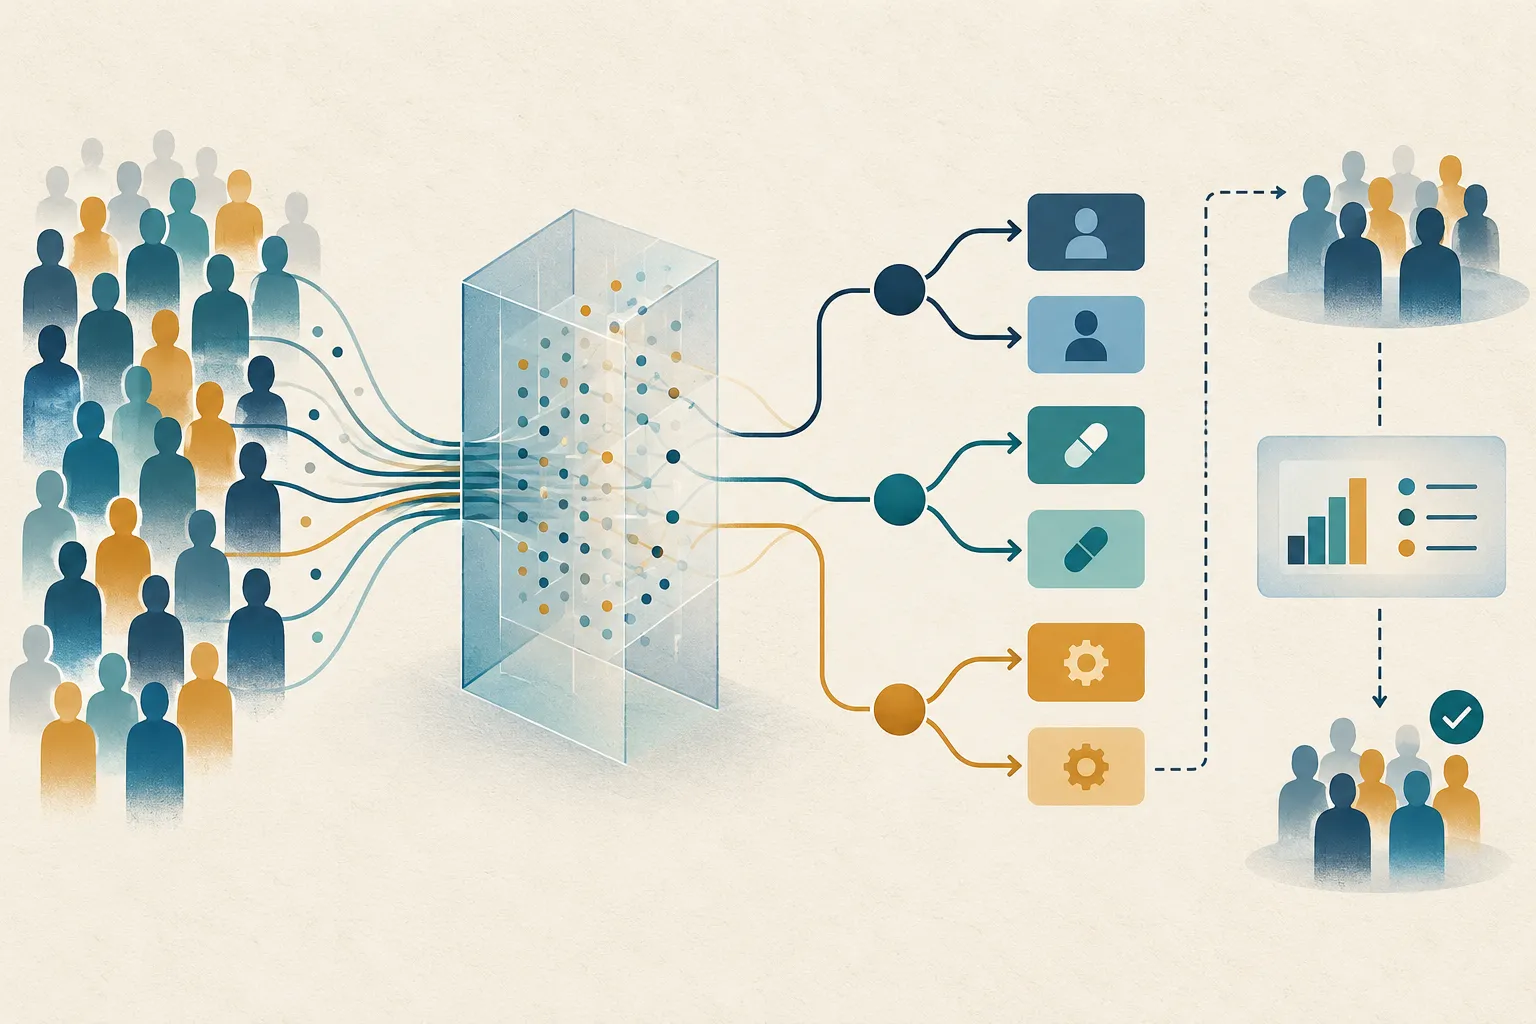
离线评估过关后,怎样从历史日志学出一条可解释的干预规则?双重稳健策略学习
用交叉拟合的双重稳健增益分数训练受限决策规则,并把策略搜索与独立价值审计分开。
上一篇讲线上监控:告警能告诉我们哪里变了,却不能替团队从历史反馈中设计下一条规则。现在假设业务只能观察历史实际采取的动作及其结果,想学一个新策略决定“谁该接受干预”。直接回归结果再选预测均值较高的动作容易受模型错设影响;只按逆倾向加权又会被少数极端权重拖着走。
本篇聚焦一个主题:把交叉拟合的双重稳健增益分数接到一个受限策略类上,直接优化决策规则。策略学习回答“如何选规则”;上一篇的离线评估回答“选出的冻结规则在独立证据上表现怎样”。两步必须分开,不能在同一批样本上反复试规则、再把最好的那一个当作无偏评估结果。
01 从历史动作到可比较的个体增益#
设 个独立决策单位,处理前特征矩阵 ,二元历史动作 ,观测结果 。令 为倾向概率, 为动作 的结果回归。目标规则 只使用决策时可获得的信息。
先用交叉拟合(cross-fitting)按独立单位分折,在不含当前观测单位的训练折上拟合倾向概率(propensity score) 与结果模型(outcome model),再对留出行计算双重稳健增益分数(Doubly Robust Gain Score):
在一致性、条件可交换性(conditional exchangeability)、正值性(positivity)等识别条件下,给定 的条件期望对应条件处理效应。第一项借用结果模型降噪,后两项用真实被分配动作的残差校正;倾向模型或结果模型满足相应正确性条件时,分数仍可一致估计目标增益;这就是双重稳健(doubly robust)的来源,但“二者任意一个正确”并不能补救未测混杂或缺乏重叠。
flowchart LR
  D[历史 X, A, Y 与记录倾向] --> F[按用户/簇/时间切折]
  F --> N[训练折拟合 e 与 q0、q1]
  N --> G[留出折生成 DR 增益 Γ]
  G --> P[受限策略类搜索 πθ]
  P --> V[锁定策略与版本]
  V --> H[独立留出集或新随机实验审计]
H --> R[价值差、区间、重叠与护栏]这些分数是带噪的伪结果(Pseudo-outcome),不是每个人真实可同时观察到的两个潜在结果之差。拟合过程要保留折外分数、折成员、截断规则和数据版本,供复现和诊断。
02 把“预测效果”改成“选择规则”#
若不处理的价值作为基线,对一个受限策略集合(policy class),可优化
是 0/1 动作, 与 同单位, 可表示叶节点数或规则复杂度, 控制可解释性与拟合灵活度之间的取舍。若有每人处理成本 ,改为最大化 ;预算、资格、公平覆盖等约束则要明确写成可行策略集合,不能把目标指标和硬约束混为一项分数。
这里优化的是策略类在样本上的经验目标,不是直接拟合 的回归器。因此可限制为一层决策树、少量临床规则或线性阈值。限制过强会欠拟合;限制过松会利用伪结果噪声挑出“赢家”。
03 四行手算:为什么不用逐人追着噪声走#
假设某折外样本的倾向均为 ,结果模型与观测如下。按上式逐行算出增益:
| 人 | 特征 | |||||
|---|---|---|---|---|---|---|
| 1 | 1 | 1 | 1 | 0.6 | 0.2 | |
| 2 | 2 | 0 | 0 | 0.5 | 0.4 | |
| 3 | 3 | 1 | 0 | 0.4 | 0.3 | |
| 4 | 4 | 0 | 1 | 0.8 | 0.2 |
考虑只允许一条规则“当 时处理”。阈值 的样本增益和分别是 ;全处理则为 ,全不处理为 。在这组数据里 得分最高,但只有四行时选择结果极不稳定;必须用独立数据审计,而不能把 2.1 当作真实总体价值。
04 从伪代码到可运行的阈值搜索器#
先把学习步骤写清楚:
输入:折外增益 Γ、允许的策略类 Π、复杂度惩罚 λ
best ← 空
对每个候选规则 π ∈ Π:
    gain ← mean(π(Xᵢ) × Γᵢ)
    score ← gain − λ × complexity(π)
    若 score 高于 best:保存 π 与 score
输出:冻结的 best 规则下面的纯 Python 示例接收折外增益和一个连续特征,穷举所有中点阈值及全处理/全不处理候选,最大化平均增益减去每条规则的复杂度惩罚。它演示策略搜索,不负责拟合倾向或结果模型,也不输出置信区间。
def fit_stump(x, gain, complexity_penalty=0.0):
    n = len(x)
    if n == 0 or len(gain) != n:
        raise ValueError("x 与 gain 必须等长且非空")
    if any(not isinstance(v, (int, float)) for v in x + gain):
        raise ValueError("示例只接受数值输入")
    if complexity_penalty < 0:
        raise ValueError("复杂度惩罚不能为负")

    candidates = [("none", None), ("all", None)]
    values = sorted(set(x))
    candidates += [("le", (a + b) / 2) for a, b in zip(values, values[1:])]
    best = None
    for mode, threshold in candidates:
        treated = [mode == "all" or (mode == "le" and v <= threshold) for v in x]
        value = sum(float(g) for g, take in zip(gain, treated) if take) / n
        leaves = 1 if mode in ("none", "all") else 2
        objective = value - complexity_penalty * leaves
        if best is None or objective > best[0]:
            best = (objective, value, mode, threshold)

    _, value, mode, threshold = best
    return {"mode": mode, "threshold": threshold, "training_gain": value}


x = [1, 2, 3, 4]
gain = [1.2, 0.9, -0.7, -1.0]
print(fit_stump(x, gain))
# {'mode': 'le', 'threshold': 2.5, 'training_gain': 0.525}输入 x:[n] 与折外 gain:[n],输出可部署的单阈值规则及经验增益(四行和 2.1 除以 4 得 0.525)。实际系统中先按用户/门店等独立单位分组切折;每一折只在训练折拟合特征处理、倾向与结果干扰模型(nuisance models),再给留出折计算 。合并折外分数后搜索策略,再冻结特征模式(feature schema)、阈值和代码摘要。推理时只需读取决策前特征、检查资格与安全护栏,然后应用已冻结的规则,不在请求时重新估计 。
示例实现按 x 的数值排序、阈值候选数为 ( 为不同取值数),逐候选打分为 。生产树可用动态规划、整数规划或策略学习算法处理更多叶子与约束;实现时应限制最大深度、最小叶样本和动作比例,且把等分、缺失值和超出训练范围的行为写入规则协议。
05 训练、选择、评估要分账#
推荐的流程是:
- **定义决策目标:**明确动作、结果方向、时间窗、成本、可用特征、资格和必须满足的约束。
- **生成折外增益:**按重复用户、门店、网络簇或时间依赖选切分单位,训练折拟合 nuisance 模型,留出折只产生分数。
- **搜索受限规则:**在训练/开发分区比较预先登记的候选策略类;记录策略复杂度、动作率、约束可行性和随机种子。
- **锁定唯一候选:**冻结规则、输入 schema、缺失值处理、阈值、成本表和实现摘要。
- **独立审计:**在从未参与拟合或挑选的日志切分上,用双重稳健离线策略评估(Doubly Robust Off-Policy Evaluation, DR-OPE)估计价值差和区间,报告有效样本量(effective sample size, ESS)、权重尾部、重叠和分层效果;高风险场景再做随机试验。
如果一份数据同时负责学习规则、挑选超参数和报告最终性能,搜索越多,赢家偏差越大。普通随机切分也不够:同一用户跨期重复出现时应按用户分组;部署目标是未来流量时应按时间前推验证。最终审计集的标签和摘要要锁定,不能因结果不理想再调规则后仍称其为“独立测试”。
键盘可展开:审计未通过时如何定位
- **价值差区间很宽:**查看有效样本量、独立簇数和支持重叠,优先增加有效证据;不要只加深树。
- **少数规则贡献极大:**按倾向分位数和动作分层查看权重尾部,检查正值性与截断敏感性。
- **整体提升但某群体变差:**先核对预先声明的覆盖约束及分层不确定性,再决定是否重做策略设计。
- **离线提升、线上不兑现:**检查动作是否实际执行、资源成本、干扰、容量饱和和结果成熟度,安排前瞻随机验证。
原生 details/summary 可用键盘展开、窄屏自然换行,并继承站点深浅主题;关键诊断也以文字列出,不依赖颜色。
06 常见失败、调试与方法边界#
- **用同一行拟合 nuisance 再算分数:**会产生乐观的过拟合残差。检查每行是否严格由未见过该单位的模型预测;重复单位要整体留出。
- **极端倾向导致分数爆炸:**打印 分位数、分臂样本量和 尾部。截断可降方差但会改变有限样本目标,应预先规定阈值并做敏感性分析。
- **把双重稳健理解成“因果自动正确”:**它依赖识别假设、正值性和适当 nuisance 收敛率;未记录混杂、动作执行偏差、干扰或错误时间零点仍会破坏结论。
- **直接对 noisy gain 做普通分类:**伪结果可为负且方差不等;分类标签或样本权重变换须对应明确的风险目标,不能把分类准确率当策略价值。
- **只报告训练目标:**它是策略搜索分数,不是泛化价值。用冻结规则在独立数据做双重稳健离线策略评估(Doubly Robust Off-Policy Evaluation, DR-OPE),计算配对价值与区间。
- **新流量超出日志支持:**目标策略在某些特征区几乎总选日志未采取的动作,离线反事实不可识别;停止外推、收窄目标人群或设计探索实验。
- **奖励与成本尺度不一致:**先把收益和成本转换到同一单位或明示多目标约束,记录成本版本和决策时可用信息,避免事后修改成本表改变规则。
| 方法 | 优化/回答什么 | 主要依赖与风险 |
|---|---|---|
| CATE 回归后阈值化 | 估计效果面,再套规则 | 结果模型误设会扭曲排序;阈值与成本要另定 |
| 结果加权学习(Outcome-weighted learning) | 将规则学习转成带权分类 | 权重构造、方差和分类器目标需谨慎 |
| DR 策略学习 | 在候选规则类内直接最大化 DR 增益 | 需识别、重叠、折外 nuisance 与独立审计 |
| DR-OPE | 评估一个已冻结策略的价值 | 不负责从数据搜索新策略;重叠差时不可靠 |
| 在线随机试验 | 在实际执行环境比较策略 | 成本、干扰、实验单位和长期反馈仍需设计 |
策略学习不保证找到所有可能规则中的全局最优解;它只在选定的规则类与样本证据下做优化。复杂策略需要统计正则化、稳定性评估和部署约束共同限制。
07 思考练习#
- 若结果模型正确但倾向模型错设,DR 增益为何仍可能有正确条件均值?哪些识别假设仍不可省略?
- 某阈值策略训练增益最高,但独立审计 ESS 很低且区间跨过零。你会先检查哪些诊断,是否允许部署?
- 策略需同时满足预算上限和至少 20% 的小群体覆盖。如何定义可行策略类,并把规则搜索与约束违反报告分开?
相关工作#
- Athey & Wager, Policy Learning with Observational Data ↗:从双重稳健因果效应分数学习受约束的处理分配规则。
- Dudík, Langford & Li, Doubly Robust Policy Evaluation and Learning ↗:将双重稳健估计用于部分反馈下的策略评估与优化。
- Zhang et al., A Robust Method for Estimating Optimal Treatment Regimes ↗:讨论观察性数据中最优处理规则的稳健估计。
- Zhao et al., Estimating Individualized Treatment Rules Using Outcome Weighted Learning ↗:把个体化处理规则写成加权分类问题。
08 下一篇预告#
策略规则从历史日志中学出之后,还要验证它在不同时间段、不同人群和不同成本条件下是否稳定。下一篇将聚焦策略稳定性:如何用重复切分、扰动与 regret 视角,区分“规则真的稳”与“刚好选中了本次噪声赢家”。