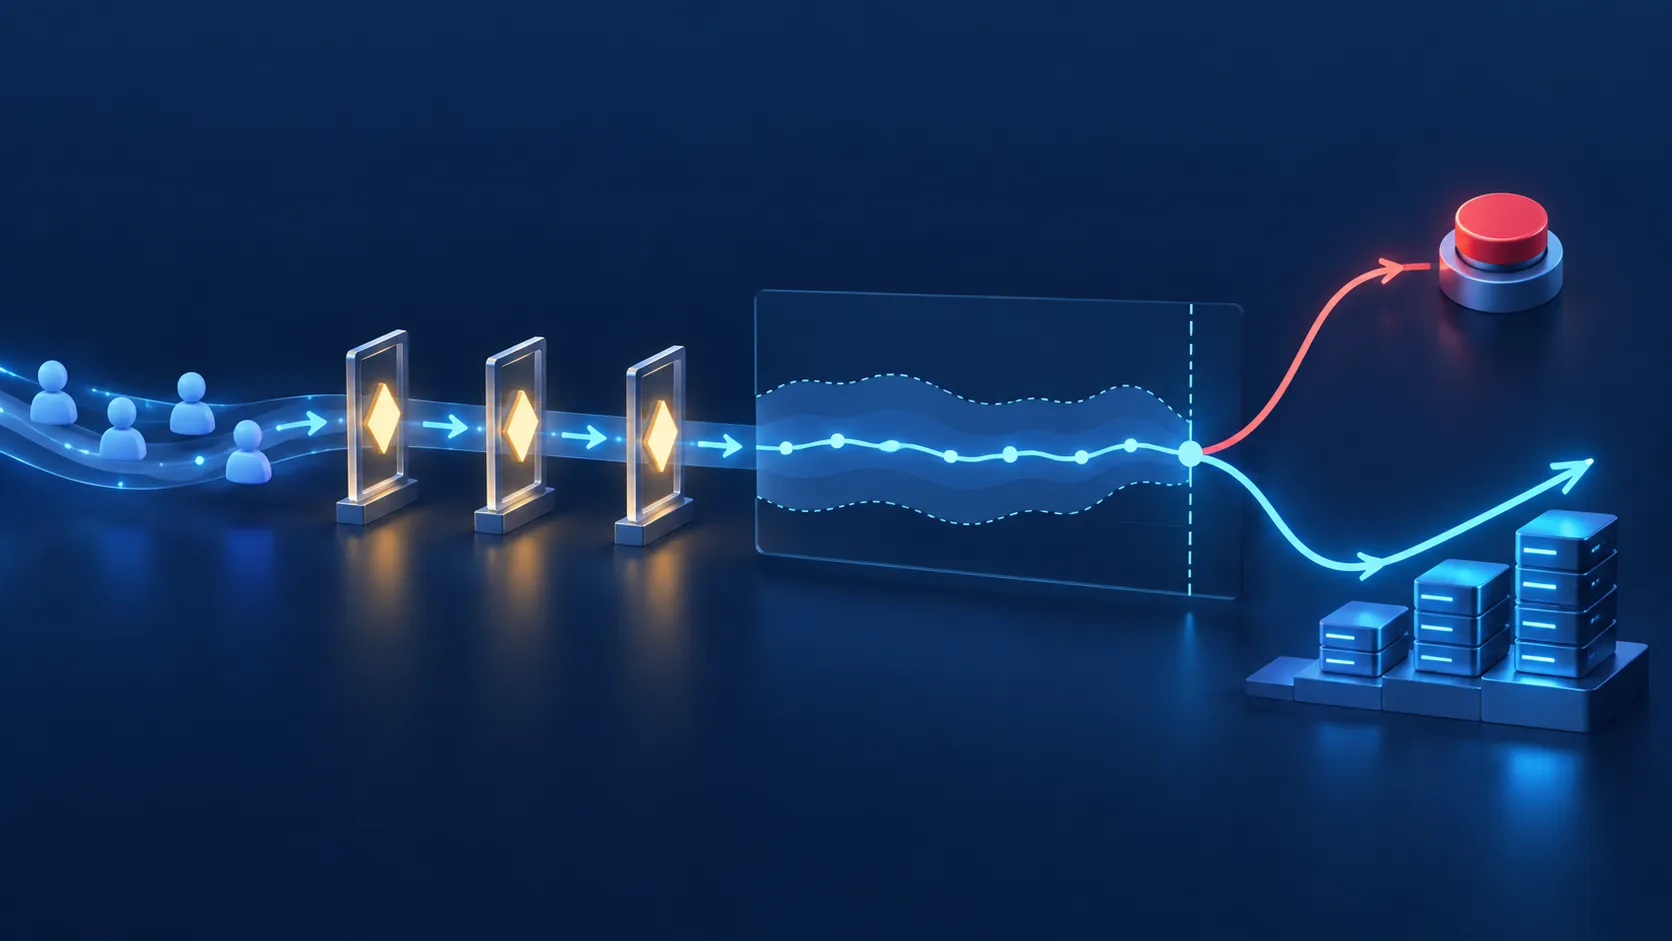
灰度流量到齐后,为何还不能扩量?延迟标签与序贯决策
将 Canary 的即时护栏与成熟标签质量分开,使用预先承诺的检查节奏和置信区间决定停止、保持或扩量。
上一篇将模型、特征、策略和标签口径封为可追溯的部署清单。现在可以准确回答“哪个版本在跑”,但还不能仅凭一小时的点击率回答“能否扩量”:很多业务标签在数天后才成熟,而每分钟反复看一次指标会放大偶然波动。
本篇只解决一个核心问题:怎样把即时安全护栏与 Delayed Label(延迟标签)的质量证据分层,并以预先固定的 Sequential Decision(序贯决策)规则选择停止、保持或扩量。
01 同一份流量有两种时钟#
对请求 ,在时刻 产生版本绑定的预测 ;真实标签 只有在 后才成熟。即时信号如超时、拒绝率、成本可在现在计算;质量指标如 AUC、校准和收益只能在成熟集合 上计算。
flowchart LR
  R[canary request] --> P[manifest-bound prediction]
  P --> I[immediate guardrails]
  P --> W{maturity window}
  L[delayed label] --> W
  W --> Q[mature paired quality]
  I --> G{hard stop}
  Q --> D{scheduled evidence gate}
  G -->|yes| S[stop and rollback manifest]
  G -->|no| D
  D -->|harm supported| S
  D -->|benefit supported| X[expand one step]
D -->|uncertain| H[hold and collect]不能把未到期的样本当负例,也不能用快速代理指标替代质量证据。代理指标能触发紧急停止,却不自动证明模型优劣;成熟标签能评价业务结果,却来得太晚,无法承担唯一的安全职责。
02 极小手算:点估计越界不等于证据够了#
稳定版和 canary 各有 个请求,失败数分别为 。失败率差为 。若预先规定最大容忍增量 ,点估计似乎越界;但近似标准误
其约 95% 下界 ,仍可能没有伤害。若两组各 10,000 条且差仍为 2%,下界会远高于 1%,才是有力的回滚证据。这里假设独立请求;若同一客户连发 100 次,应以客户或会话为聚类单位,而不是把 100 行伪装成 100 个独立样本。
Canary 判定实验室
调整样本量与失败数,观察“点估计变差”和“证据足以回滚”之间的差别。
- 稳定版失败率
- Canary 失败率
- 增量点估计
- 约 95% 下界
03 先写规则,再看数据#
“看到显著就停”会在反复检查中产生过多假阳性。一个可审计的计划至少固定检查时点、最短样本、指标方向、容忍带、切片和动作。它不必复杂,但不能在看到不喜欢的曲线后才改门槛。
experiment: manifest@sha256:ab12
traffic_steps: [1%, 5%, 20%]
immediate_stop: p99 latency over 450ms for 10m OR unsafe rate over 0.1%
maturity_hours: 168
look_after_mature_pairs: [500, 2000, 8000]
harm_rule: upper quality gain bound below -0.003
expand_rule: lower quality gain bound above 0.001 and all critical slices pass
otherwise: hold current traffic; wait for next scheduled look若定义 ,正数代表 challenger 更好,则伤害是 的上界仍小于负容忍值;扩量是下界仍高于实用增益。统一符号可以避免“区间写对了但决策方向反了”。
04 最小实现:把成熟性作为输入检查#
函数接收形状 [N] 的 champion 与 challenger 损失、布尔成熟掩码和预先定义的检查样本数;只在样本数到达检查点时返回决策。它用正态近似说明流程,生产环境应使用与指标、聚类和多次查看相匹配的预注册序贯方法。
import numpy as np

def scheduled_gate(champion_loss, challenger_loss, mature,
                   looks=(500, 2000, 8000), min_gain=.001, max_harm=.003):
    if champion_loss.shape != challenger_loss.shape or mature.shape != champion_loss.shape:
        raise ValueError("all inputs must have shape [N]")
    delta = champion_loss[mature] - challenger_loss[mature]  # positive means better
    n = len(delta)
    if n not in looks:
        return f"hold: {n} mature pairs; wait for next scheduled look"
    mean = float(delta.mean())
    se = float(delta.std(ddof=1) / np.sqrt(n)) if n > 1 else float("inf")
    lower, upper = mean - 1.96 * se, mean + 1.96 * se
    if upper < -max_harm:
        return f"stop: gain CI [{lower:.4f}, {upper:.4f}] supports harm"
    if lower > min_gain:
        return f"expand: gain CI [{lower:.4f}, {upper:.4f}] supports benefit"
    return f"hold: gain CI [{lower:.4f}, {upper:.4f}] is inconclusive"

base = np.array([.10, .20, .30, .20])
candidate = np.array([.08, .17, .28, .19])
print(scheduled_gate(base, candidate, np.ones(4, dtype=bool), looks=(4,)))mature 不只是“标签非空”:它还要满足唯一 Join、冻结的标签 revision 和清单中的成熟时间。输入与输出均为标量决策字符串;日志中应同时保存 manifest_id、检查编号、分子分母与区间,不能只记录“通过”。
05 工程上的停止按钮不能等标签#
即时护栏必须独立于统计门:错误写入、安全策略违反、预算失控、请求超时或特征 schema 不兼容应立即停止并回到前一 manifest。不要因为“样本还不够”继续造成确定性损害。
| 信号 | 时钟 | 正确动作 |
|---|---|---|
| 5xx、p99 延迟、费用、协议违规 | 秒到分钟 | 硬停止、隔离、保全请求证据 |
| 成熟覆盖率下降 | 天级 | 修 Join/标签链路,质量结论标不可用 |
| 成熟质量区间支持伤害 | 成熟窗口后 | 回滚该 manifest,做分诊与复盘 |
| 区间不确定 | 任意检查点 | 保持流量,等待下一次预定检查 |
常见错误是把缺失标签填 0、按行而非用户聚类、只看总体均值、每个小时换一次停止线、把多次试验的 p 值当成固定一次的 p 值,以及把灰度入口流量变化误称为模型提升。调试时先比对两组的 manifest、分流键、成熟规则和样本重叠;再从一个关键切片复算分子分母。
思考练习#
- 若负例在 30 天后才完整,7 天内哪些护栏可以支持停止,哪些结论必须等成熟?
- 业务损失按客户高度相关。如何修改函数,使标准误按客户聚类计算?
- 某关键切片只有 40 个成熟样本但风险极高;为什么“总体通过”不能自动扩量?