CATE 排序更高就值得干预吗?用双重稳健离线评估个体化策略
承接因果森林的条件处理效应,推导个体化策略价值的双重稳健分数,用手算例和可运行 Python 代码比较策略与基线。
上一篇用诚实因果森林估计条件平均处理效应(Conditional Average Treatment Effect,CATE),回答“哪些特征人群平均更可能受益”。但预测效果较高不等于策略值得上线:治疗可能昂贵,估计会有噪声,而且旧数据里的处理分配未必遵循新策略。我们不能把森林在训练数据上的高分直接当成新规则的收益。
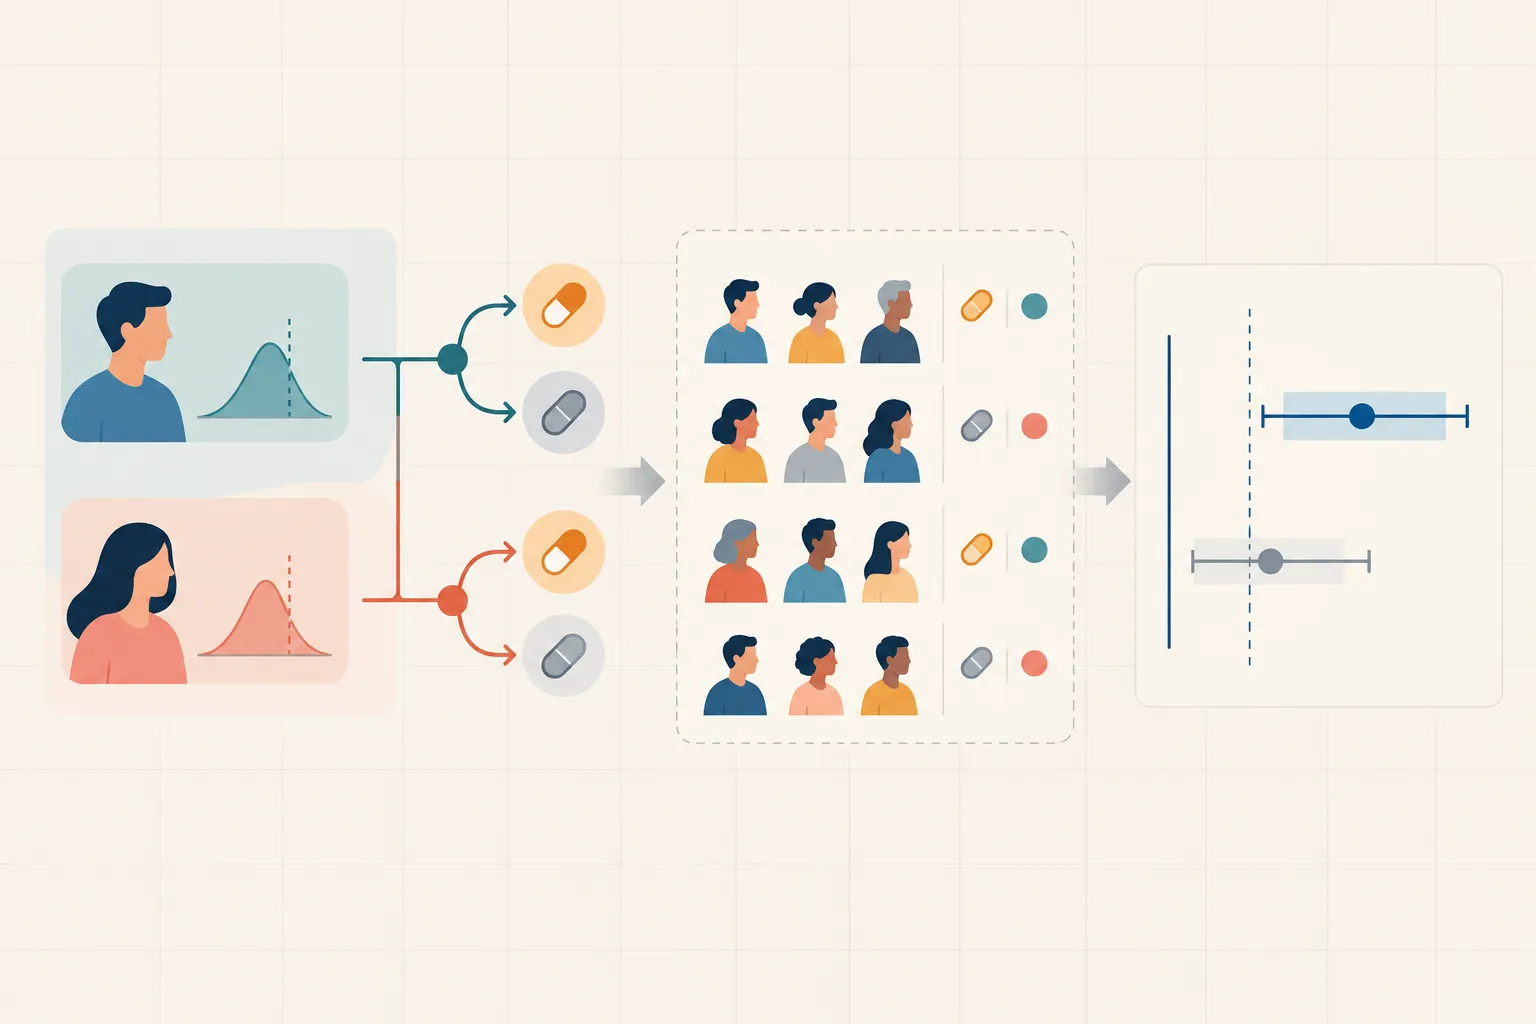
本篇只解决一个问题:**怎样用一份没有参与规则挑选的数据,估计个体化策略(treatment policy)的平均结果,并与“全部处理”和“都不处理”比较?**核心工具是双重稳健离线评估(Doubly Robust Off-policy Evaluation,DR-OPE)。
01 先把预测规则与评估样本隔开#
设 是处理前特征, 是日志中实际收到的处理, 是观测结果。目标规则 读入特征后决定是否处理。一次策略只给每个人分配一个动作,但离线日志只记录其中一个动作的结果;没发生的那个结果是反事实。
flowchart LR
  D[历史数据 X T Y] --> S[按对象或随机化簇切分]
  S --> A[训练区:拟合 CATE 与候选规则 π]
  S --> B[评估区:冻结规则,不再调阈值]
  B --> N[折外估计倾向 e 与结果模型 μ₀ μ₁]
  A --> C[对评估区 X 生成 π(X)]
  N --> E[逐行 DR 策略分数 Γ]
  C --> E
E --> V[均值、标准误、与基线差值]评估区里的每个对象形状为 ,而 均为长度 的向量。对于有门店、医院或用户网络相关性的实验,切分单位必须是实际分配单位;把同一门店拆到两边会让评估集泄漏门店冲击。若目标是未来流量,还要按时间切分。
策略应在训练区确定,包括 CATE 模型、筛选特征、阈值和候选规则。不能看过评估结果后反复改规则,再把同一份评估区称作“独立测试集”。比较很多候选策略时,要么预留最终未触碰的确认集,要么使用诚实的多重比较/策略选择推断。
02 直接预测、逆概率加权与双重稳健#
令 是倾向得分(propensity score), 是动作 下的结果回归。目标人群中的策略价值(policy value)是
这里 是潜在结果,实际只看到 。识别需要一致性、给定处理前协变量后的无未测混杂,以及重叠性 。数据若来自已知随机实验,日志分配概率可直接作为 ;观察性数据则需要估计它,并承认假设无法仅靠模型检验。
最简单的直接法(Direct Method,DM)用结果模型填补没看到的结果:
它不利用评估行的实际 修正预测误差。逆概率加权(Inverse Propensity Weighting,IPW)只使用与目标策略动作相同的日志行:
当目标动作在日志里很少出现时, 会很大,少数行就能主宰均值。双重稳健(Doubly Robust,DR)分数先用结果模型给出基线,再只用匹配动作的残差校正:
直观上,未匹配动作没有已观测残差,只能保留模型预测;匹配动作则由 IPW 放大的预测残差纠偏。在常见识别条件下,倾向模型或结果模型至少一个正确时,DR 估计仍可一致;这不意味着两者都错、缺少重叠或存在未测混杂时也可靠。估计模型要在其他折训练、对当前评估行折外预测,避免同一行既拟合自己又校正自己。
伪代码:
  将日志按随机化单位/时间拆成训练区 D_train 与评估区 D_eval
  只用 D_train 拟合 CATE 候选规则 π,以及交叉拟合的 e、μ0、μ1
  冻结 π;对每条 D_eval 计算 pi=π(X)、p_pi 和 Γ(pi)
报告 mean(Γ)、标准误,以及相对预设基线的逐行分数差这里规则、倾向模型和结果模型的验证不能偷看最终评估区。若必须用同一份历史数据选策略又报告价值,应使用嵌套样本切分,最外层评估样本只负责最终报告。
03 四个人的手算策略比较#
下表是为解释公式设计的教学数字。倾向概率均为 ,每个人事先冻结的规则 已由训练区生成。列 是评估区的折外结果预测。
| 人 | 日志 | 结果 | 策略 | |||
|---|---|---|---|---|---|---|
| A | 1 | 8 | 7 | 4 | 1 | |
| B | 0 | 5 | 3 | 5 | 0 | |
| C | 1 | 4 | 4 | 3 | 0 | (动作不匹配) |
| D | 0 | 1 | 5 | 2 | 1 | (动作不匹配) |
新规则的 DR 价值是 。对“全部处理”重算各行会得到 ,均值 ;对“都不处理”得到 ,均值 。这个微小样本中规则看起来胜过两个基线,但单个 DR 分数可超出实际结果范围,四行也不足以支持显著性判断。策略差异应逐行配对计算,再报告其不确定性,而不是只比较三个独立均值。
展开:为什么动作不匹配的行没有残差项?
若规则给 A 处理而日志中的 A 没有处理,我们没有 ,因此无法用该行动下的实际结果残差修正 。该行仍为策略价值的基线预测。匹配动作的行才观察到目标行动的结果,但要按日志选择该行动的概率加权,纠正“被观察到的同动作人群”与目标人群比例不同的问题。原生 details 可用键盘聚焦并以 Enter/空格展开,窄屏会自动换行且沿用站点深浅主题。
04 可运行的 Python 评估器#
下面的函数只负责计算分数,刻意不假装替你拟合因果模型。输入是评估区的 T[M]、Y[M]、e[M]、mu0[M]、mu1[M] 和冻结规则 policy[M];输出是逐行分数 [M]、均值和均值标准误。所有输入必须按同一行顺序对齐。
from math import sqrt
from statistics import mean


def dr_policy_value(t, y, propensity, mu0, mu1, policy):
    """评估二元动作规则;各输入是评估集长度 M 的一维序列。"""
    arrays = [t, y, propensity, mu0, mu1, policy]
    n = len(y)
    if n == 0 or any(len(a) != n for a in arrays):
        raise ValueError("所有输入须为相同的非零长度")

    scores = []
    for ti, yi, ei, m0, m1, pi in zip(*arrays):
        if ti not in (0, 1) or pi not in (0, 1):
            raise ValueError("t 和 policy 只能取 0 或 1")
        if not 0.0 < ei < 1.0:
            raise ValueError("倾向概率必须严格位于 (0, 1)")

        mu_pi = m1 if pi == 1 else m0
        p_logged_action = ei if pi == 1 else 1.0 - ei
        correction = 0.0
        if ti == pi:
            correction = (yi - (m1 if ti == 1 else m0)) / p_logged_action
        scores.append(mu_pi + correction)

    value = mean(scores)
    if n < 2:
        standard_error = float("nan")
    else:
        sample_var = sum((s - value) ** 2 for s in scores) / (n - 1)
        standard_error = sqrt(sample_var / n)
    return scores, value, standard_error


# 形状均为 [M];用上表四行复算规则 π
scores, value, se = dr_policy_value(
    t=[1, 0, 1, 0], y=[8, 5, 4, 1], propensity=[.5] * 4,
    mu0=[4, 5, 3, 2], mu1=[7, 3, 4, 5], policy=[1, 0, 0, 1],
)
print(scores)  # [9.0, 5.0, 3, 5]
print(value, se) # 5.5, 小样本标准误,仅用于演示生产流程中,若日志已知随机概率,则 propensity 用每行真实分配概率;否则倾向模型和两个结果模型都只能使用处理前协变量。为减少过拟合偏差,可先把训练区做 折交叉拟合(cross-fitting):每折模型在其余 折训练,在留出折生成 ;策略训练和最后的价值报告还要各自遵守预先声明的数据边界。
对同一评估样本上的两个规则 ,用成对分数差 ,标准误为 。这保留了两策略共享对象带来的协方差。若数据按簇分配,则应先在簇层面汇总 ,用簇数而非行数估不确定性。若试验按时间或网络块随机化,照搬独立同分布标准误会过窄。
用 scikit-learn 划分独立同分布示例数据时,可先划行索引并固定随机种子:
from sklearn.model_selection import train_test_split

indices = list(range(len(y)))
train_idx, eval_idx = train_test_split(
    indices, test_size=0.30, random_state=42, stratify=t,
)此 API 接受对齐的数组并返回训练/测试索引;stratify=t 只维持处理比例,不会自动处理门店聚类、时间漂移或因果泄漏。分层后仍要分别检查两侧每种处理样本数。参数含义以 scikit-learn 官方 train_test_split 文档 ↗ 为准。
05 结果该看什么,何时不该用#
| 检查 | 具体做法 | 失败信号 |
|---|---|---|
| 支持度 | 按目标策略动作列出倾向分布与样本数 | 某些特征区几乎没有策略所需动作 |
| 权重稳定性 | 查看 的分位数和最大值 | 少数行主宰策略价值 |
| 分数方差 | 查看 DR 分数与成对差值的分布 | 均值由重尾分数驱动,区间很宽 |
| 规则选择 | 锁定策略版本、阈值、成本和评估集 | 根据评估集反复改策略 |
| 外推目标 | 对比训练与评估期的人群、处理及结果定义 | 线上目标人群已离开日志支持范围 |
极端权重可提示重叠不足;截断权重会引入偏差,需把截断阈值作为敏感性分析报告,不能仅保留“好看”的版本。估计值减去处理成本时,要先定义清楚 是否已是净结果;若每人成本不同,可在结果中按同一会计口径扣除,且成本模型也应避免使用处理后信息。
以下情况不适合把单个 DR 均值当上线许可:评估集太小、倾向概率接近 0/1、策略由同一评估集反复筛选、存在未测混杂、日志动作概率记录错误、处理版本不一致、结果延迟或目标人群变化。DR 是估计器,不是随机试验,也不保证有限样本无偏或置信区间覆盖正确。若上线可小流量随机验证,应把安全护栏、伦理约束和真实随机化作为新证据。
06 与 CATE 排序和 IPW 有何区别?#
| 方法 | 回答的问题 | 数据使用 | 主要风险 |
|---|---|---|---|
| CATE 模型 | 条件平均处理效应随 如何变化? | 学习异质性 | 训练集排序过拟合;不等于决策价值 |
| 直接法 DM | 结果模型预测的规则均值是多少? | 预测 | 结果模型错会留下偏差 |
| IPW / IPS | 日志里匹配规则动作的结果均值是多少? | 匹配行加权 | 小概率动作造成高方差 |
| DR-OPE | 用预测基线加权残差评估规则 | 模型 + 匹配动作残差 | 仍需要识别、重叠和独立评估 |
先按 CATE 最大值分组只是建候选规则的办法;DR-OPE 检验的是冻结规则在目标人群的平均结果。若不同人群处理成本、容量和公平约束不同,价值最大策略未必符合资源分配目标。策略学习还需明确优化的效用、约束和治理规则。
07 思考练习#
- 对上表的四行策略
policy=[1,0,0,1],为什么 B 的模型残差不进入分数?若 B 的倾向概率从 0.5 降到 0.1,哪类行的权重会变大? - 两个策略在同一 400 人评估集上的 DR 均值分别为 4.2 和 4.0。你会如何构造成对标准误?若这 400 人来自 8 家随机化门店,样本单位要怎样调整?
- 研究者先看评估集,调了 30 个 CATE 阈值后报告最大价值。怎样重设计数据流,才能给最终阈值一个诚实的确认评估?
相关工作#
- Dudík et al., Doubly Robust Policy Evaluation and Learning ↗:将双重稳健思想用于部分反馈下的策略评估与学习。
- Athey & Wager, Policy Learning with Observational Data ↗:用双重稳健效应估计学习满足约束的处理分配策略。
- Wang, Agarwal & Dudík, Optimal and Adaptive Off-policy Evaluation in Contextual Bandits ↗:比较 IPS、DR 与 SWITCH 的离线评估误差。
- Swaminathan & Joachims, Counterfactual Risk Minimization: Learning from Logged Bandit Feedback ↗:用反事实风险最小化约束日志反馈策略学习。
08 下一篇预告#
离线价值估计回答了“这条规则在日志支持范围内看起来有多好”,却没有回答“如何把规则放进有限预算、容量或公平约束”。下一篇将从不受限的逐人规则走向预算约束策略,推导影子价格、排序阈值和策略价值之间的关系。