历史上只复核难例,怎样学出复核增益?随机路径探索与折外学习
把人工转交当作有已知概率的路径分配,在两条路径都可行的人群中保留探索,用折外双重稳健分数学习复核增益,并在独立入口队列审计预算规则。
上一篇按复核增量价值分配有限分钟,把净收益写成 。分配器可以直接消费这列分数,但数据从哪里来?旧系统只把区间最宽的案例转给人工,简单训练“人工处理后结果”的模型,很可能把难例的低结果学成人工无效,也可能把容易完成的工单学成人工擅长。
本篇解决怎样获得足以学习复核增益的路径反馈。从允许比较的边界人群开始,保留已知概率的随机路径探索,再把折外校正分数变成可推理的增益模型。已有的逆概率加权与双重稳健方法继续使用;这次需要重新核对的是路径、探索支持、结果观测和容量协议。
01 只见过一种路径,数据就没有告诉你另一种会怎样#
令 表示分配人工复核, 表示分配冻结基线。它与人工最终执行的动作 不同:人工既可能发邀请,也可能不发,超时后还可能执行默认规则。定义
是路径分配前可用特征, 是进入人工或基线协议后的潜在结果,包含事先约定的等待与超时处理。目标人群限定为两条路径都可接受的资格集合 ;所有后续估计都在这个集合内进行。
如果旧规则规定“宽度大于 5 必须复核,其余永不复核”,则窄区间人群的 。这里没有关于人工路径的直接证据。给 加一个很小常数只是在计算上避免除零,不能创造未发生的反事实。
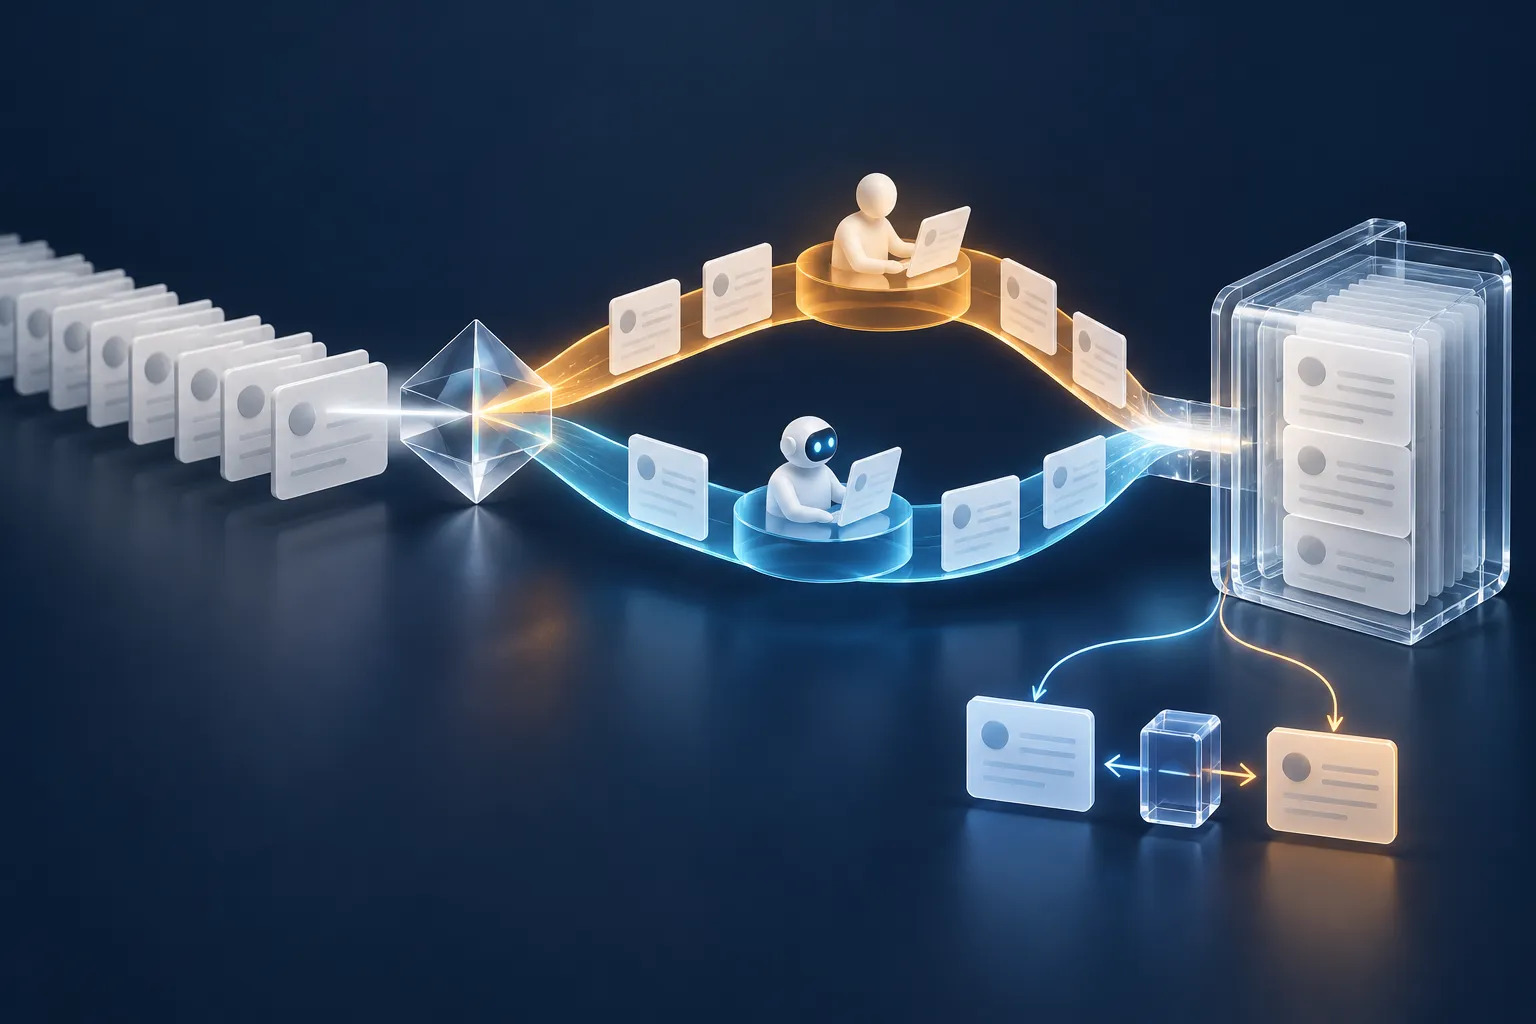
随机探索(randomized exploration)给这个缺口补数据:在 中,按照预先保存的概率分配两条路径,例如 。以分配时的概率为准,不能用事后人工完成比例替代。实验必须预留容量;若随机到人工后又因排队被筛掉,仍按原分配路径保留该人,并把超时作为协议的一部分。
预定义资格 E、两条协议、独立结果采集、容量预留
                          |
                  随机 Z;记录 e(X)
                    /             \
               基线路径          人工路径
                    \             /
             全入口成熟结果 X,Z,Y,e
                          |
             开发区:折外结果预测 -> 增益分数
                          |
                学习并冻结 g(X) 预测器
                          |
独立审计区:按固定预算选名单、估计价值差这里的随机探索是在合格案例上实际比较两条协议;只让人工离线写一份建议,却仍让所有人执行基线,只能研究建议质量,不能直接识别“进入人工路径后的结果”。
02 两条路径的结果模型,外加一份观测残差#
设 为路径结果均值模型。对某个留出折,用其他折训练的模型给每个人预测 、,计算双重稳健增益分数(doubly robust gain score):
是日志中的分配概率。前两项模型预测给出初始差值;后两项只对实际被分配的路径使用观测残差。只要路径随机化真实执行、结果定义一致、每个待估路径有正概率,且结果被正确观测,已知的正确 就允许残差校正结果模型的偏差。结果模型仍能影响方差,过度外推会让分数很吵。
为什么校正有用?例如在人工路径项,给定 与独立训练的预测器,
它补回人工均值模型的误差,基线残差同理,合起来得到 。对观察性日志还要额外要求给定记录特征后的可交换性(conditional exchangeability),人工私下看到而未记录的信息会破坏这一条件。本篇优先使用真实随机探索,避免把“估计一列倾向”当作自动去混杂。
交叉拟合(cross-fitting)使每行残差来自没见过该行的结果模型;它不能替代路径随机化,也不能把开发区变成最终测试集。示例每人只出现一次,故使用普通随机切折;重复用户需按用户分组,评估未来部署时需按时间前推,防止同一单位或未来信息穿过切分边界。
对 个对象,;z、y、e、gamma 都是 [n];m0,m1 并排为 [n,2]。gamma 可以超出 的范围,也可以为负,它是带噪的校正分数,不是每个人已知的真实增益。
03 四行手算:残差校正的是均值误差#
下面用效用点作结果单位,探索概率均为 。数字仅用于核对计算。
| 行 | |||||
|---|---|---|---|---|---|
| 1 | 1 | 13 | 10 | 12 | |
| 2 | 0 | 9 | 10 | 11 | |
| 3 | 1 | 10 | 10 | 12 | |
| 4 | 0 | 12 | 10 | 11 |
模型预测差均值为 ,校正分数均值为 。第二行只观测基线路径,它也能贡献增益信息:真实基线比模型预测低,人工相对基线的差值应向上修正。第四行则反过来。
若直接把前两行的正分数当成“这两个人确定受益”,就会追逐残差噪声。下一步需要用许多样本学习条件平均规律,并在独立数据上检查最终规则。
04 先学增益,再冻结名单生成规则#
用折外分数训练回归器 ,最小化
表示开发区;输出 是条件复核增益的预测。浅树把特征空间分成少数叶子,每个叶子的最优常数是该叶 的平均数,因为对常数 求导得到 。例如一个叶子只有分数 4、3,预测为 3.5;如此小的叶子方差很大,因此实现里设置最小叶样本数。
选择特征、树深和其他超参数只能使用开发区及其内部验证。最终审计区保留完整入口队列,既不负责拟合结果模型,也不负责挑选树深。对审计案例只按已冻结的预测分数、直接成本、预算和并列规则生成名单。
开发区内切折:
    训练折分别拟合基线和人工结果模型
    留出折预测两条路径,使用真实 Z,Y,e 构造 Gamma
合并开发区折外 Gamma,拟合浅增益树
冻结增益树、路径结果模型、直接成本与资源协议
独立审计区:
    只用 X 与冻结增益树生成预算名单
再用审计日志 Z,Y,e 计算名单相对全基线的价值差05 可运行 scikit-learn:把训练、推理和审计分开#
示例模拟 600 个独立用户,每人都有完整成熟的效用结果。第一列特征代表一种处理前资料特征,第二列决定基线结果。低第一特征人群的真实复核增益是 2.2,其余为 0.1;这些真值只在模拟器中存在,学习器只见实际分配路径上的结果。直接复核成本统一为 0.2 点,每单固定预约 4 分钟。
代码使用已核实的当前官方接口:DecisionTreeRegressor ↗ 的平方误差树回归与 KFold ↗ 的切折索引。fit 负责在训练行学习分裂及叶均值;predict 沿已冻结分裂进入叶子并返回均值。两路径模型、折外校正和最终增益树都显式写出,分配器不依赖一个黑盒效果分数。
from random import Random
import numpy as np
import sklearn
from sklearn.model_selection import KFold
from sklearn.tree import DecisionTreeRegressor


def fit_paths(X, z, y, indices):
    models = []
    for arm in (0, 1):
        ids = indices[z[indices] == arm]
        if len(ids) < 20:
            raise ValueError("某路径训练样本不足")
        model = DecisionTreeRegressor(max_depth=2, min_samples_leaf=20,
                                      random_state=7)
        model.fit(X[ids], y[ids])
        models.append(model)
    return models


def dr_gain(X, z, y, e, models):
    n = len(y)
    if X.ndim != 2 or any(a.shape != (n,) for a in (z, e, y)):
        raise ValueError("要求 X:[n,p],z/y/e:[n]")
    if not np.all(np.isin(z, [0, 1])) or not np.all((e > 0) & (e < 1)):
        raise ValueError("路径或探索概率无效")
    if not all(np.isfinite(a).all() for a in (X, y, e)):
        raise ValueError("示例要求成熟、完整且有限的输入")
    m0, m1 = [model.predict(X) for model in models]
    return m1 - m0 + z * (y - m1) / e - (1-z) * (y - m0) / (1-e)


# 合成探索实验:每行是不同用户;容量预先预留,互不拖慢。
rng = Random(42)
X = np.array([[rng.random(), rng.random()] for _ in range(600)])
e = np.full(600, 0.5)
z = np.array([int(rng.random() < p) for p in e])
base = 10 + 2 * X[:, 1]
true_gain = np.where(X[:, 0] < 0.5, 2.2, 0.1)
y = base + z * true_gain + np.array([rng.uniform(-0.3, 0.3) for _ in z])

# 预先固定前 400 行开发、后 200 行最终审计;此处合成行独立同分布。
dev = np.arange(400)
audit = np.arange(400, 600)
gamma = np.full(400, np.nan)
folds = KFold(n_splits=2, shuffle=True, random_state=7)
for train, held in folds.split(X[dev]):
    paths = fit_paths(X, z, y, dev[train])
    ids = dev[held]
    gamma[held] = dr_gain(X[ids], z[ids], y[ids], e[ids], paths)
assert np.isfinite(gamma).all()

gain_model = DecisionTreeRegressor(max_depth=1, min_samples_leaf=40,
                                  random_state=7)
gain_model.fit(X[dev], gamma)
# 审计所用结果模型也只能见开发区。
frozen_paths = fit_paths(X, z, y, dev)
audit_gamma = dr_gain(X[audit], z[audit], y[audit], e[audit], frozen_paths)
predicted = gain_model.predict(X[audit])
direct_cost, minutes, budget = 0.2, 4, 80
ranked = sorted(range(len(audit)), key=lambda j: (-predicted[j], int(audit[j])))
chosen = [j for j in ranked if predicted[j] > direct_cost][:budget // minutes]
score = sum(audit_gamma[j] - direct_cost for j in chosen) / len(audit)
print("versions", np.__version__, sklearn.__version__)
print("audit_entered", len(audit), "selected", len(chosen), "minutes", len(chosen)*minutes)
print("audit_gain_per_entrant", round(float(score), 4))
# 仅用于模拟器核验,真实日志无法观察逐人的 true_gain。
oracle = sum(true_gain[audit[j]] - direct_cost for j in chosen) / len(audit)
print("synthetic_truth_per_entrant", round(float(oracle), 4))NumPy 的 isfinite ↗ 检查有限值,isin ↗ 检查路径枚举;它们只做输入校验,不检验因果识别条件。
两次随机化各做不同的事:Random(42) 只负责复现合成数据;KFold(..., shuffle=True, random_state=7) 负责开发区交叉拟合。真实生产的路径概率必须来自线上分配器日志,不应从一个训练随机种子倒推。
fit_paths 只在指定训练行的各路径中拟合结果回归;dr_gain 保留输入形状、有限值、概率与路径枚举检查;gamma[held] 保证每行只写入折外分数。max_depth=1 的最终增益树只有一个分裂,便于检查分配依赖哪个处理前特征。代码示例在 NumPy 2.5.4、scikit-learn 1.9.1 上执行,具体输出见下面的运行核验。
versions 2.5.4 1.9.1
audit_entered 200 selected 20 minutes 80
audit_gain_per_entrant 0.1928
synthetic_truth_per_entrant 0.2代码输出的审计增益以全部 200 名入口用户为分母。20 名被选中者只占 10%,不能把他们的平均增益误报为全系统提升。synthetic_truth_per_entrant 只用于检查模拟器是否合理,真实日志中无法直接观察,禁止把它混入训练或挑选规则。
chosen 只依赖审计区 和冻结增益树,不依赖该区的实际路径或结果。审计分数为
其中 是候选名单的选择指示,与历史随机分配 区分。它估计当前这批协变量下,候选路由相对全基线的平均净增量;每单固定 4 分钟,预算 80 分钟,最多取 20 个正预测净增益案例。相同效用点上的直接成本只在这里扣一次。
训练时需要 ;推理时只需要合格对象的 、冻结增益模型、成本、分钟和当前预算。没有必要为了在线预测增益而等待这个人的结果。审计与再训练才会在未来重新接入成熟结果。
06 看到正数后,还需要哪些证据?#
这个示例给出点估计,没有输出上线判定或有效置信区间。正式审计应预先声明目标是某一批入口的条件价值,还是未来随机批次的平均价值,并按独立用户、簇或完整预算批次构造相应不确定性。每批名单共同依赖该批的排名与预算,重抽样若用于未来批次目标,需要保留整批并在每个重抽样批次重新执行冻结分配器;不能只对被选者随意抽行。
随机探索还不能修复以下问题:
| 故障 | 为什么公式无效或目标改变 | 调试时看什么 |
|---|---|---|
| 只给人工组采集结果 | 基线结果缺失,路径随机也没有完整 | 全入口结果成熟度与缺失机制 |
| 人工没完成就删行 | 按处理后状态筛样本,破坏分配比较 | 原始分配人数、超时与执行交叉 |
| 硬容量下临时裁掉人工组 | 实际路径及负载协议改变 | 预留容量、分配概率、实际路径与完整回执 |
| 训练后才加入人工新资料作为 | 部署时不可得,且可能受路径影响 | 路由时间点与特征可用时间 |
| 同一用户在训练和留出折出现 | 折外残差仍带有单位泄漏 | 用户键、服务单元与时间分组 |
| 日志概率来自“最终发邀请率” | 分母描述了另一个动作 | Z 的路径概率与 A 的动作概率分别保存 |
若两路径的结果采集本来就有选择性,需额外设计独立结果采集,或明确缺失识别条件与校正方法;把缺失标签补成零会同时污染模型和残差。若探索在某些群体完全禁止,则本篇结论限定于 ,不能向那些群体外推。
此外,复核员之间可能能力不同,负载可能改变等待,向人工展示模型分数也可能改变其判断。更换这些条件就更换了 所对应的协议。训练后增加复核量时应检查系统是否仍处于探索实验覆盖的容量范围。
诊断自测:把所有 e=0 的行直接删掉,就能评估全人群吗?
删掉以后可以重新定义有重叠的目标人群,并明确报告覆盖范围与排除比例;结果不再对应原来的全人群。把零改成 0.01 则只改变计算,没有获得这些人进入人工路径后的信息。若需要拓宽适用范围,应先确定可接受的探索设计与容量。
07 与已有方法的关系#
双重稳健处理效应估计的代数在这里仍然成立,变化在于“处理”现在是完整人工路径,不是最终邀请动作。普通人工结果回归只学习 ,不能给出相对基线的增量;直接训练两个结果模型相减可以作为基线方法,但缺少观测残差校正;拒绝规则按证据强度筛出对象,也不会自动知道谁能从人工中受益。
选择性标签(selective labels)问题研究只有部分决策才产生或揭示结果的场景。本篇的代码另外假设两条路径都有独立采集的成熟结果,因此只面对每人缺少一条反事实路径反馈的问题;真实业务若连事实结果都选择性缺失,必须先补上结果采集与识别设计。区分这两个缺口,才知道下一步应当增加随机探索,还是修复标签来源。
思考练习#
- 手算表第二行的探索概率若为 ,其分数是多少?为什么基线路径残差应除以 而非 ?
- 某类案例旧规则永不复核。模型仍预测出很高的人工收益,你会要求哪些支持与探索证据,才允许把这列预测用于转交?
- 把示例的最终树深从 1 改为 8,并在同一审计区反复挑选效果最好的深度。哪一步失去了独立性?怎样重新划分开发、选择与最终审计?
相关工作#
- Dudík, Langford & Li (2011), Doubly Robust Policy Evaluation and Learning ↗:用预测与日志概率残差校正结合,估计部分反馈下的策略价值。
- Athey & Wager (2021), Policy Learning with Observational Data ↗:以因果分数为基础学习策略,并研究策略复杂度与约束。
- Mozannar & Sontag (2020), Consistent Estimators for Learning to Defer to an Expert ↗:研究预测器与专家协作的学习目标;其分类转交设定与这里的路径结果因果效应需要区分。
- Wei (2021), Decision-Making Under Selective Labels: Optimal Finite-Domain Policies and Beyond ↗:讨论决策影响标签可见性时,当前效用与后续学习之间的权衡。
下一篇预告#
这次探索把人工路径当作一个固定协议,但同一份案例交给不同复核员,增益与耗时可能不同。下一篇将研究多专家转交:怎样同时记录专家身份、资格、容量和相对基线的增量,避免把“进入人工队列”误当成唯一处理动作。