实验中途能不能停?用预先分配的显著性预算设计序贯检验
把固定样本量和多次查看放进同一设计,用两次手算查看与纯 Python z 检验说明何时可以提前停止。
上一篇说明,MDE(最小可检测效应)和功效先决定最多要多少样本;“刚好显著就停”不能替代样本计划。线上团队却经常每天看一次仪表盘:指标刚越线就扩量,隔天回落又回滚。问题不在于查看数据本身,而在于固定样本检验的 只为预先约定的一次查看提供错误率保证。
本篇只讲固定两臂均值实验里,怎样在设计阶段安排有限次中期查看并保留总体假阳性预算。先用保守但容易审计的 Bonferroni 分配做两次查看,再说明它与 O’Brien–Fleming、Pocock 和持续有效推断的边界。下一篇转向另一种独立性问题:当同组成员彼此相关时,实验应该在哪一层随机化。
01 每次 ,不等于整场实验只错 5%#
第一类错误概率(Type I error)是零效果时错误宣布成功的概率。显著性水平 表示若按预设规则重复做实验,长期约 5% 的零效果实验会被错误判成功。若在查看 200 人、400 人、600 人时都运行同一个固定样本 z 检验,并且每次都用 0.05 门槛,整个决策规则不再是原先那次固定样本检验。多看几次就多了几次越线机会,不能继续声称总错误率仍是 5%。
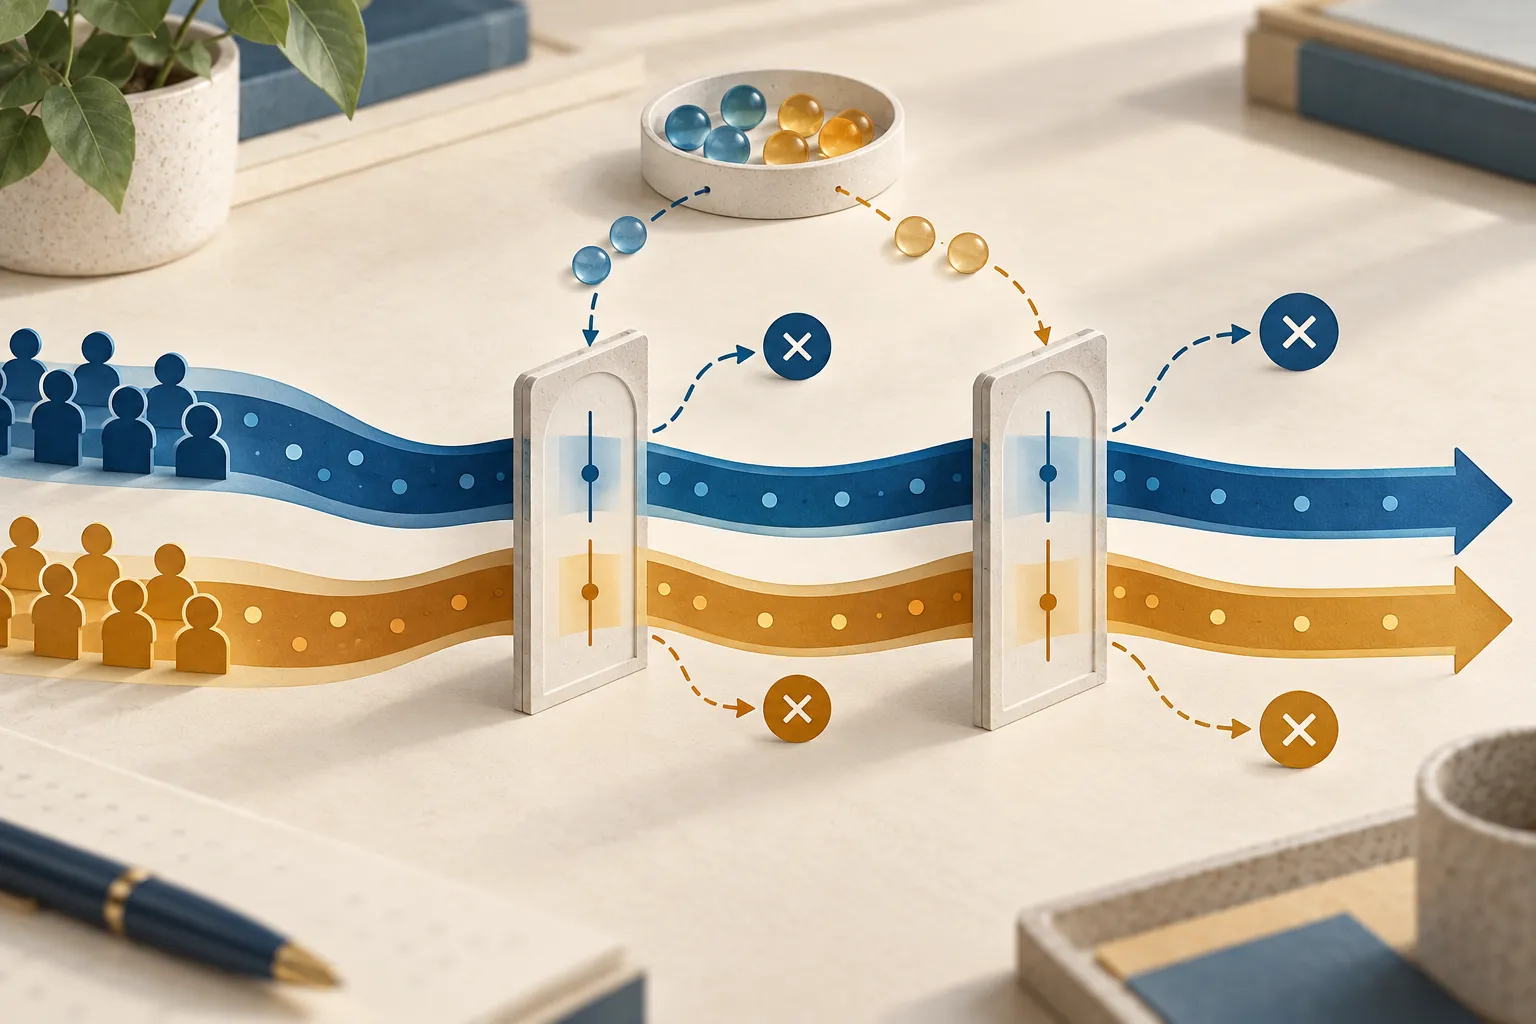
序贯设计(sequential design)在实验前定义查看时点、最多查看次数、每次可用的错误率预算、每次查看的数据边界和最终动作。若第 次查看的局部显著性预算为 ,并令 ,则对任何各次查看间的相关结构,Bonferroni 上界(Bonferroni inequality)给出
它的价值是规则清晰、可审计;代价是往往比专门考虑累计统计量相关性的组序贯边界保守。
flowchart LR
  D[预先固定最大样本与指标] --> P[固定查看次数与样本时点]
  P --> A[把总体 α 分配到每次查看]
  A --> L1{第 1 次:越过门槛?}
  L1 -->|是| S[按预注册规则停止]
  L1 -->|否| N[继续收集至下个时点]
  N --> L2{最终查看:越过门槛?}
  L2 -->|是| W[报告有证据支持的效果]
L2 -->|否| U[报告不确定或未检出]成功、伤害、无望的收益和即时安全事故是不同决策。显著性预算示例只控制“是否宣布主要指标有效”的一侧规则;安全护栏可以另行设工程阈值,但不能伪装成已做过统计功效控制。
02 两次查看,显著性预算怎样分?#
假设双侧总体 ,在每臂 名、最多 名可分析用户时查看。最简方案平均分配:。每次是双侧检验,所以单侧尾面积各为 ,临界值约为 。两次查看都必须达到 才能拒绝零效果;不是先用 0.05,没显著后第二次又拿一个新的 0.05。
| 查看 | 每臂可分析样本 | 局部双侧 | 双侧临界值(约) | 未越线时 |
|---|---|---|---|---|
| 1 | 200 | 0.025 | $ | z |
| 2 | 400(累计) | 0.025 | $ | z |
,其中 是两臂均值, 是事先从历史或盲态数据固定的单位级标准差, 是每臂累计独立单位数。在第一查看点若观察均值差为 2.5、,则标准误 ,,双侧 ,按这项主要指标的规则可以提前停止并报告效果。
这个例子假设连续指标近似正态、方差已知、两臂独立、样本均衡、无聚类且两次查看时点固定。若多个主要指标共享同一决策,还要在指标维度另行控制错误率;不能把“时间预算”误当成“指标预算”。
03 纯 Python 逐次计算:先看门槛,再作动作#
下方函数输入两个长度为 的用户结果列表(按入组先后排列)、历史标准差 sigma、递增的每臂累计检查点 looks 和各次局部双侧 alpha_spend。在每个检查点,它只取前 个处理组和对照组结果,计算均值差、标准误、z 值、双侧 p 值,再和该次门槛比较。列表中的每个元素必须代表一个独立随机化用户,不是请求。
from math import erfc, sqrt
from typing import Sequence

def sequential_z_test(
    control: Sequence[float],
    treatment: Sequence[float],
    sigma: float,
    looks: Sequence[int],
    alpha_spend: Sequence[float],
) -> list[dict[str, float | int | bool]]:
    if sigma <= 0:
        raise ValueError("sigma must be positive")
    if len(looks) == 0 or len(looks) != len(alpha_spend):
        raise ValueError("provide one alpha budget for every look")
    if any(n <= 0 for n in looks):
        raise ValueError("look sizes must be positive")
    if any(a <= 0 or a >= 1 for a in alpha_spend):
        raise ValueError("each alpha spend must be in (0, 1)")
    if sum(alpha_spend) > 0.05 + 1e-12:
        raise ValueError("spending exceeds the registered total alpha=0.05")
    if any(left >= right for left, right in zip(looks, looks[1:])):
        raise ValueError("looks must be strictly increasing")
    if len(control) < looks[-1] or len(treatment) < looks[-1]:
        raise ValueError("data must reach the final planned look")

    results = []
    for look_number, (n, alpha_k) in enumerate(zip(looks, alpha_spend), start=1):
        mean_c = sum(control[:n]) / n
        mean_t = sum(treatment[:n]) / n
        difference = mean_t - mean_c
        se = sigma * sqrt(2.0 / n)
        z = difference / se
        p_value = erfc(abs(z) / sqrt(2.0))
        results.append({
            "look": look_number,
            "n_per_arm": n,
            "difference": difference,
            "se": se,
            "z": z,
            "p_value": p_value,
            "reject_at_this_look": p_value <= alpha_k,
        })
        if p_value <= alpha_k:
            break
    return results

control = [50.0] * 400
candidate = [52.5] * 200 + [50.0] * 200
print(sequential_z_test(control, candidate, sigma=10,
                        looks=[200, 400], alpha_spend=[0.025, 0.025]))
# First look: difference=2.5, SE=1.0, z=2.5,
# p≈0.0124, reject_at_this_look=True如果第一眼未越线,代码按预设规则继续。实际系统不应等待所有数据齐了才调用函数:应在 n=200 事件成熟时只提交当时冻结的前 200 个单位;下一个查看点用累计到 400 个单位的数据。每次保存 experiment_id、数据截止时间、单位 ID 集、指标版本、方差来源、检查编号、alpha_k 和计算结果,才能审计相同决策。
伪代码表示线上状态转换:
if immediate_safety_guard_fails:
    rollback_and_preserve_evidence()  # 不等统计样本成熟
elif current_n == next_preregistered_look:
    result = analyze_frozen_units(current_n)
    if result.p_value <= alpha_spend[next_look]:
        stop_and_report_primary_result()
    elif current_n == maximum_n:
        stop_and_report_no_detection_or_uncertainty()
    else:
keep_assignment_fixed_and_wait_for_next_look()04 三种规则为什么不能混称“序贯检验”?#
- Bonferroni 分次预算:把总体 分成局部 ;实现简单、联合界容易说明,代价是保守,未充分利用累计统计量在查看间的相关性。
- O’Brien–Fleming 组序贯边界:早期门槛很严格,接近最终查看时更接近固定样本门槛;适合极早期只有极强证据才停止的策略。边界应由预设查看信息比例和总体错误率计算,不能照搬另一实验的 z 值。
- Pocock 型边界:各次查看使用相近的显著门槛,较容易中途停止,但最终门槛通常比固定样本法更严格。具体数值依查看次数与统计设计而变。
- Always-valid p-value / confidence sequence(始终有效 p 值 / 置信序列):允许数据每到一条就查看,而不是仅在有限预设时点查看;必须使用该方法实际提供的时序有效量,不能把普通 p 值改名。
组序贯方案会考虑累计 z 统计量的协方差结构,所以其局部边界通常不等于 Bonferroni 的统一门槛。若需要精确的 O’Brien–Fleming 或 Pocock 边界、功效和预期样本量,应使用已验证的序贯设计实现或统计顾问复核;本篇 Python 函数不是这些边界的替代品。
05 工程故障与调试顺序#
- 检查点随结果改变:固定
looks和最多样本量;日志中如果出现未注册查看,标记协议偏离。 - 误把重复请求当独立样本:先聚合到随机化用户;多轮会话或门店簇要按对应单位估计方差。
- 只记录胜负:保存估计差、标准误、局部阈值和成熟样本数,才能重放停止决定。
- 结果尚未成熟就当作没转化:延迟标签缺失不等于负例;信息时间按成熟单位而不是请求时间计。
- 功效只按最终样本算:不同的停止边界改变总体停时与功效,应在设计阶段模拟整个决策过程。
- 途中改变主指标或方向:要么保持原预注册问题,要么把改动定义为新的探索性分析并独立验证。
当 p 值恰好压线,先确认实验单位、结果成熟窗口、重复曝光去重、样本集合和方差估计;再用保存的冻结数据复算。若抽样比例失配,先解决 SRM;显著性门槛不会修复错误分流、缺失标签或处理泄漏。
06 与相近方法的边界#
| 方法 | 什么时候能看 | 保证依赖什么 | 常见用途 |
|---|---|---|---|
| 固定样本检验 | 到预定最大样本时一次 | 样本计划与假设成立 | 成本低、实验周期稳定 |
| Bonferroni 多次查看 | 预定有限检查点 | 局部错误预算总和不超过 | 简单审计的分阶段实验 |
| 组序贯边界 | 预定中期与最终信息点 | 检查时点、协方差和边界预先确定 | 允许提前停止、想提高效率 |
| Always-valid inference | 持续到达数据时随时查看 | 使用时序有效的统计量 | 高频在线实验监控 |
| Holm 多重检验 | 同一决策下多个假设 | 输入 p 值各自有效、假设家族完整 | 多指标/多变体控制误报 |
Holm 解决“同一时间看多个假设”的家族误报;序贯规则解决“随时间重复看同一或多个假设”的误报。若两个维度同时存在,需联合设计或使用序贯多重检验,不能把任意一个校正重复套一遍便宣称总体水平受控。
键盘可展开:手算两次查看的错误率预算
总预算 0.05 分给两次查看,每次双侧 α 为 0.025;每次 p 值都必须低于 0.025。无论两次累计统计量如何相关,至少一次错误拒绝的概率不超过 0.025 + 0.025 = 0.05。
思考练习#
- 预设三次查看,总体双侧 。若采用平均 Bonferroni 预算,每次局部 是多少?每次阈值为什么不是 0.05?
- 在第二个计划检查点没有越线,但仍未到最大样本量。为何不能临时添加每天检查?
- 安全护栏显示模型持续输出违法内容,但主要指标置信区间仍跨零。系统应该等待下一次统计查看吗?
延伸阅读#
- Pocock, Group Sequential Methods in the Design and Analysis of Clinical Trials (1977) ↗
- O’Brien & Fleming, A Multiple Testing Procedure for Clinical Trials (1979) ↗
- Lan & DeMets, Discrete Sequential Boundaries for Clinical Trials (1983) ↗
- Johari et al., Always Valid Inference: Continuous Monitoring of A/B Tests (2022) ↗