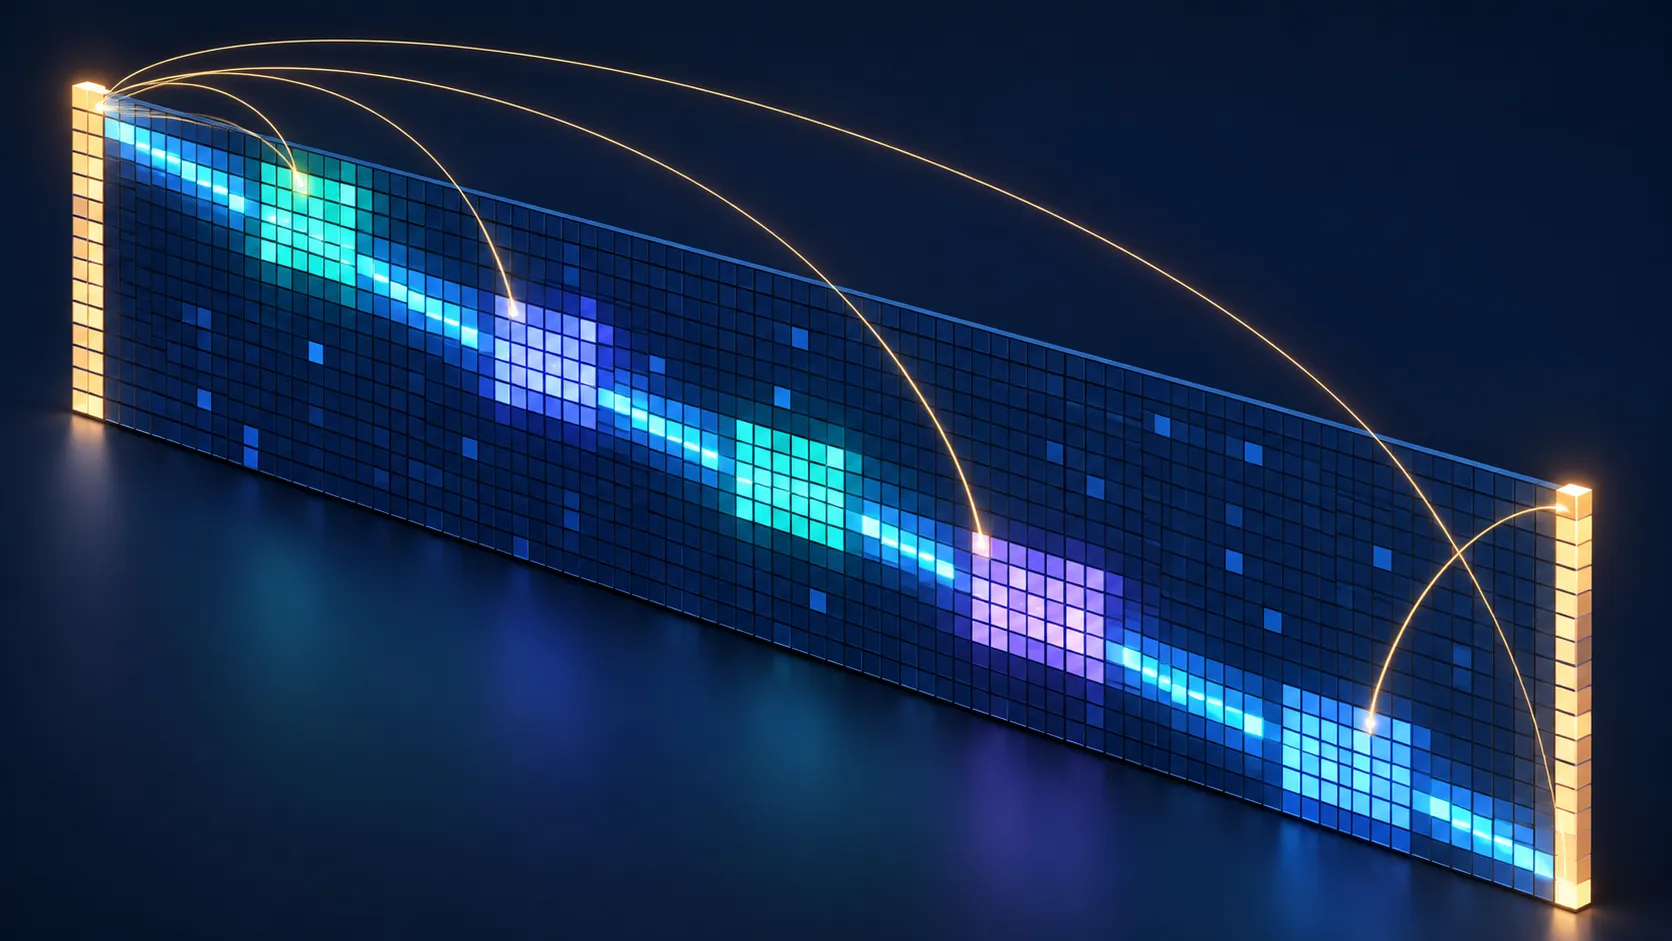
长序列为何不必让每个 token 看见全部历史?滑动窗口、块稀疏与全局 token
从全注意力的平方成本出发,手算稀疏可见图,拆解局部窗口、块布局和全局 token,并用 PyTorch 2.14 验证掩码语义与输出。
上一篇把 RoPE 模型的名义窗口扩到了训练外,并强调“能放进 32K token”不等于“能用好 32K token”。即便位置外推可靠,标准自注意力还要为长度为 的序列生成 个 Query–Key 分数:长度扩大 8 倍,分数矩阵扩大 64 倍。
稀疏注意力(Sparse Attention)不再让每个 Query 读取所有 Key,而是预先规定一张可见图。本文只讲三种紧密相连的边:滑动窗口保留邻近上下文,块稀疏让布局贴合硬件,全局 token 提供远距离中转站。核心问题不是“怎样把矩阵画得更空”,而是:哪些信息路径可以删除,仍不破坏任务真正需要的通信?
01 全注意力的瓶颈究竟在哪里?#
设 Query、Key、Value 的形状分别为:
Q [N,H,L,d] ─┐
K [N,H,L,d] ─┼─► scores [N,H,L,L] ─► softmax ─► output [N,H,L,d]
V [N,H,L,d] ─┘是 batch 大小, 是头数, 是序列长度, 是每头维度。每个头的分数为:
计算 约需 次运算;若显式保存分数或概率,则激活占用为 。FlashAttention 能通过分块重算减少显存读写,却没有把任意一个 从数学上删除;序列足够长时,平方级计算仍在。
| 方法 | 允许的 Q–K 边 | 理论边数 | 主要作用 | | ----------- | -------------: | ---------: | ------------------ | ------------ | -------- | | 全注意力 | 所有 | | 任意两点一步通信 | | 滑动窗口 | | 约 | 局部依赖 | | 块稀疏 | 选中的块对 | 取决于布局 | 高效执行结构稀疏 | | 局部 + 全局 | 窗口边与全局边 | 约 | 局部计算与远程汇聚 |
02 稀疏注意力其实是一张有向图#
定义布尔邻接矩阵 。若 Query 允许读取 Key ,则 。注意力变为:
实现时通常先把不可见位置加上 ,再做 softmax。每一行必须至少有一个可见 Key,否则全为 的 softmax 会产生 NaN。
token 是节点;“Query i 能读 Key j”是一条 j ─► i 的信息边。

全注意力:每对节点直接相连
局部窗口:0 ─ 1 ─ 2 ─ 3 ─ 4 ─ 5
局部+全局:0 ════════════════════╗
└─ 1 ─ 2 ─ 3 ─ 4 ─ 5 ╝ (0 是全局中转站)稀疏化改变的不只是速度,也改变归纳偏置(Inductive Bias):一层能传播到哪里、多层后信息要走几跳、哪个位置承担压缩远程信息的责任,都会变化。
03 滑动窗口怎样把平方边数降成线性?#
双向窗口半径为 时,。因果语言模型还必须满足 ,所以:
每个 Query 最多读取 个 Key,总边数约为 。若 固定,复杂度随 线性增长。
但“一层只能看 个历史 token”不等于“模型永远只能利用 个”。堆叠 层时,理论感受野可扩展到约 。代价是远程证据要经过多个非线性中间状态,路径更长,也可能被压缩或遗忘。
04 用 8 个 token 手算可见图#
令 、因果窗口 ,token 0 为全局 token。普通 token 能读取合法的全局 Key;全局 Query 仍遵守因果性。
列是 Key j →   0 1 2 3 4 5 6 7
Query i
0               ● · · · · · · ·
1               ● ● · · · · · ·
2               ● ● ● · · · · ·
3               ● ● ● ● · · · ·
4               ● · ● ● ● · · ·
5               ● · · ● ● ● · ·
6               ● · · · ● ● ● ·
7 ● · · · · ● ● ●第 7 行只计算 Key 0、5、6、7,共 4 个分数,而不是 8 个。若全局 token 位于因果序列开头,它不能读取未来,因此只能充当后续位置共享的锚点;双向编码器中的全局 token 才能同时读全序列并被全序列读取。
05 为什么还要从 token 稀疏改成块稀疏?#
逐元素掩码很灵活,却不保证更快。GPU 擅长对连续矩形做矩阵乘法;若先算完整 分数再把大部分设为 ,计算量仍是全注意力。
块稀疏注意力(Block-Sparse Attention)把 Query 与 Key 轴切成大小为 的块。只有被选中的块对才进入内核:
Key blocks →   K0 K1 K2 K3
Query blocks
Q0              ■  ·  ·  ·
Q1              ■  ■  ·  ·
Q2              ■  ■  ■  ·
Q3              ■  ·  ■  ■

■:执行连续的小矩阵乘法;·:整块跳过块边界会引入粒度误差:块中只要存在少数有效 token,内核可能仍需计算整块,再在块内应用细粒度 mask。块越大,矩阵乘效率通常越好,但多算的无效位置也可能越多。布局应根据长度、窗口和硬件实测,而不是只看理论稀疏率。
06 三种边怎样组合成可用模式?#
常见组合可写成 :
local保留语法、局部视觉纹理或相邻时间步;global让少量摘要、问题或特殊 token 与所有位置通信;task由文档段落、图边、检索结果或成对字段决定。
随机边也能缩短图直径,但可重复性、解释和硬件调度更复杂。设计时先问“任务中的远距离信息通过哪条路径到达”,比先照搬某篇论文的图案可靠。
07 先用稠密掩码验证语义#
下面构造 [L,L] 布尔矩阵。它适合单元测试,不是长序列性能方案。
import torch

def causal_local_global_mask(
    length: int,
    window: int,
    global_tokens: tuple[int, ...] = (0,),
    *,
    device: torch.device | str | None = None,
) -> torch.Tensor:
    assert length > 0 and window >= 0
    q = torch.arange(length, device=device)[:, None]  # [L,1]
    k = torch.arange(length, device=device)[None, :]  # [1,L]
    causal_local = (k <= q) & ((q - k) <= window)     # [L,L]

    is_global_k = torch.zeros(length, dtype=torch.bool, device=device)
    is_global_k[list(global_tokens)] = True
    mask = causal_local | (is_global_k[None, :] & (k <= q))

    for g in global_tokens:       # 全局 Query 也不能读未来
        mask[g] = k[0] <= g
    return mask                    # True = 允许参与 SDPA

mask = causal_local_global_mask(8, 2)
assert mask[7].nonzero().flatten().tolist() == [0, 5, 6, 7]
assert not mask[3, 4]
assert mask.any(dim=-1).all()这里特意先写稠密“真值版本”。生产稀疏内核的输出、梯度与可见边都应和它在小尺寸上对齐。
08 用 PyTorch 2.14 SDPA 做正确性基线#
PyTorch 2.14 当前官方 torch.nn.functional.scaled_dot_product_attention ↗ 接受 [N,H,L,d],其布尔 attn_mask 中 True 表示允许参与;这与 nn.MultiheadAttention 的 key_padding_mask 语义相反。
import torch.nn.functional as F

def dense_reference(q: torch.Tensor, k: torch.Tensor, v: torch.Tensor):
    # q/k/v: [N,H,L,d]
    length = q.size(-2)
    mask = causal_local_global_mask(length, 128, device=q.device)
    return F.scaled_dot_product_attention(
        q, k, v,
        attn_mask=mask[None, None, :, :],  # [1,1,L,L] 广播
        dropout_p=0.0,
) # [N,H,L,d]应在一个可测试的 mask 中明确合并因果与稀疏条件。模块训练时若启用 dropout,还要显式传 dropout_p=self.p if self.training else 0.0,因为 SDPA 会按传入值执行 dropout。
09 用 FlexAttention 表达真正的块布局#
PyTorch 2.14 当前官方 FlexAttention API ↗ 中,mask_mod 接收 batch、head、Query 索引和 Key/Value 索引。create_block_mask 把 token 条件压成 BlockMask,让内核跳过完整不可见块。
from torch.nn.attention.flex_attention import create_block_mask, flex_attention

WINDOW = 128
GLOBAL = 0

def causal_local_global(b, h, q_idx, kv_idx):
    local = (kv_idx <= q_idx) & ((q_idx - kv_idx) <= WINDOW)
    read_global = (kv_idx == GLOBAL) & (kv_idx <= q_idx)
    global_query = (q_idx == GLOBAL) & (kv_idx <= q_idx)
    return local | read_global | global_query

def sparse_forward(q: torch.Tensor, k: torch.Tensor, v: torch.Tensor):
    n, heads, q_len, _ = q.shape       # [N,H,L,d]
    kv_len = k.size(-2)
    block_mask = create_block_mask(
        causal_local_global,
        B=n, H=heads, Q_LEN=q_len, KV_LEN=kv_len,
        device=q.device,
    )
return flex_attention(q, k, v, block_mask=block_mask), block_maskBlockMask 描述“哪些块可能含有效元素”,块内仍由 mask_mod 保证精确语义。固定长度与布局时应复用 mask,避免每个 step 重建;变长 batch 要把 padding 边界并入条件,或按长度分桶。
10 怎样证明稀疏实现没有算错?#
最短验证路径是让 :
- 逐行打印稠密 mask,人工核对因果方向、窗口端点与全局边;
- 用相同 Q/K/V 比较稠密基线和稀疏内核的前向输出;
- 分别反传同一个标量,比较 Q/K/V 梯度;
- 把被屏蔽 Key 的 Value 改成极大值,确认对应 Query 输出不变;
- 最后才测长序列的峰值显存、tokens/s 与任务质量。
mask = causal_local_global_mask(8, 2)
out1 = F.scaled_dot_product_attention(q, k, v, attn_mask=mask)
v2 = v.clone()
assert not mask[7, 3]
v2[..., 3, :] += 10_000
out2 = F.scaled_dot_product_attention(q, k, v2, attn_mask=mask)
torch.testing.assert_close(out1[..., 7, :], out2[..., 7, :])11 训练与增量推理的数据流有什么不同?#
训练时通常一次输入完整 [N,H,L,d]。带 KV Cache 的解码步只有 Q_LEN=1,而 KV_LEN=P+1:
新 Query [N,H,1,d] ─────────┐
缓存+新 Key [N,H,P+1,d] ───┼─► 最近 w 个 Key + 合法全局 Key
缓存+新 Value [N,H,P+1,d] ─┘窗口注意力并不自动让 KV Cache 有界。若还允许读取开头的全局 token,需要保留“全局槽 + 最近 个槽”,并维护真实全局位置供 RoPE 使用。截断缓存后把位置重新编号为 0,会破坏前文建立的位置契约。
12 常见错误与最短调试路径#
| 症状 | 常见原因 | 最短检查 |
|---|---|---|
| loss 异常低 | 因果不等号写反,读到未来 | 所有允许边是否满足 |
| 输出 NaN | 某 Query 没有合法 Key | 检查 mask.any(-1) |
| 显存没下降 | 构造了完整分数或稠密 mask | profiler 中找 [L,L] 分配 |
| 稀疏内核更慢 | 序列短、块碎或反复建 mask | 分离编译、建 mask 与稳态计时 |
| 长依赖骤降 | 窗口小且没有远程路径 | 画多层可达图,按证据距离分桶 |
| 推理训练不一致 | cache、位置或全局边不同 | 同前缀逐 token 对齐 logits |
性能比较必须固定 dtype、batch、头宽、序列长度和反向设置;先 warm-up,再同步设备计时。只报告“稀疏率 90%”不能说明端到端更快。
13 失败场景与相近方法#
- 精确复制远处字符串、代码符号解析或跨文档引用时,局部路径可能太长;
- 全局 token 太少会形成信息瓶颈,太多又把成本拉回 ;
- 固定窗口与语义边界不一致,可能在段落交界处删掉关键边;
- 不规则稀疏在通用硬件上利用率低,理论 FLOPs 减少不等于延迟下降。
还要区分:FlashAttention 精确计算全注意力,主要优化 IO;线性注意力通过核分解或状态递推改变计算顺序,不一定定义稀疏图;检索增强先从外部语料选内容;KV Cache 复用历史 K/V。这些方法可以组合,却不回答同一个问题。
14 今天真正需要记住什么?#
- 稀疏注意力先定义信息可达性,再谈加速;mask 是模型结构的一部分。
- 滑动窗口把边数从 降到约 ,全局 token 用 条边补充远程中转。
- 逐元素 mask 只验证语义;真正省计算需要能跳过整块的内核。
- 正确性用小尺寸稠密真值、梯度和隔离测试证明,效率用稳态端到端基准证明。
15 思考题与小练习#
- 对 的因果窗口,列出第 0、1、5、9 个 Query 的可见 Key,再求总边数。边界处为何少于 ?
- 两层窗口半径为 1 的注意力中,位置 5 最早能间接接收位置几的信息?加入全局 token 后路径如何改变?
- 实现稠密 reference 和块稀疏版本,测 的显存与耗时,找出开始获益的交叉点。
相关工作#
- Child et al., Generating Long Sequences with Sparse Transformers ↗,系统探索固定与分步稀疏模式。
- Beltagy et al., Longformer ↗,组合局部窗口与任务相关全局注意力。
- Zaheer et al., Big Bird ↗,结合局部、随机与全局边并分析表达能力。
- Dao et al., FlashAttention ↗,展示精确全注意力的 IO 优化边界。
- FlexAttention 团队,FlexAttention ↗,介绍可编程 mask 与块稀疏执行。
16 下一篇预告#
到这里,Transformer 已能在可控成本下读取长前缀,但模型为什么会学会生成下一个 token 还没有被完整展开。下一篇将从文本切片开始,追踪输入与标签怎样错开一位,推导因果语言模型的 next-token cross-entropy,并解释 padding、文档边界和 loss mask 如何决定模型究竟在学什么。