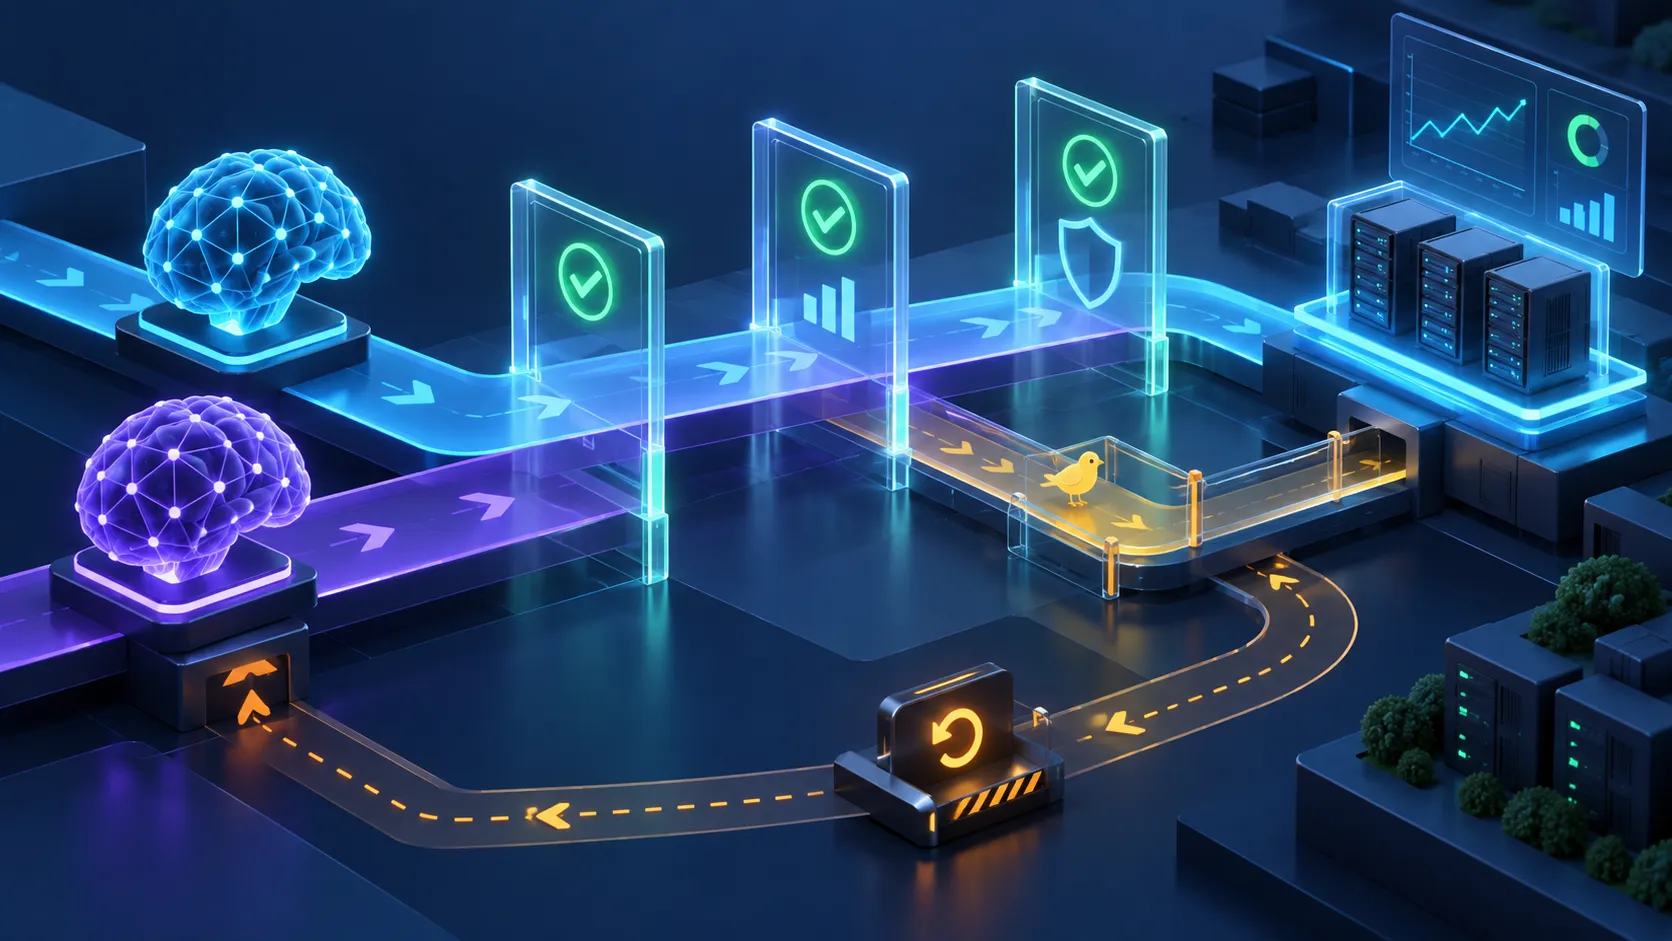
新模型总体更好,为何仍不能上线?Champion–Challenger 发布门
从“重训完成”到可回滚上线,拆解时间切分、冻结比较集、最差切片护栏与影子—灰度决策;附最小 NumPy 发布门实现。
上一篇把告警分成输入、标签证据和成熟质量三条链路。即使证据表明需要新模型,“离线 AUC 更高”也不是发布许可:训练集可能偷看未来,平均分可能掩盖关键切片退化,服务成本或延迟也可能越过 SLO。真正要比较的是已部署的 Champion(冠军模型)和新训练的 Challenger(挑战者)在同一可追溯问题上的净风险。
本篇只解决一个核心问题:怎样把 challenger 的离线结果变成一组可审计、可回滚的 Promotion Gate(晋升发布门),并决定它最多先进入多少流量。 下一篇将继续把这些门接入版本化部署与持续评估。
01 训练完成不等于回答了线上问题#
对第 条评测记录,保存时间正确的输入 、成熟标签 、模型版本与业务切片 。冠军和挑战者分别给出分数 。配对比较比“本月 AUC 对上月 AUC”更强:两者面对相同 ,随机噪声和样本构成变化被大幅抵消。
flowchart LR
  S[immutable snapshot + mature labels] --> T[time-respecting holdout]
  T --> C[Champion inference\nsC: N]
  T --> H[Challenger inference\nsH: N]
  C --> G[paired metrics by slice]
  H --> G
  G --> P{promotion gates}
  P -->|pass| SH[shadow → small canary]
  P -->|fail| R[retain champion + diagnosis]
SH --> O[online guardrails + rollback]如果标签有两周延迟,Holdout(留出集)也必须只包含已成熟且按上一篇规则连接成功的样本。训练期间临时得知的修正数据、当前的特征词表和“最新”标签都要有 revision;否则 challenger 可能赢在冠军上线当时根本不可见的信息上。
02 极小手算:总体提升可以掩盖关键切片失败#
设 100 个普通请求占 90%,10 个高风险请求占 10%。挑战者在普通请求上使损失从 降至 ,在高风险请求上却从 升至 。总体平均损失由
降至 ,表面更好;但高风险切片恶化 。若这个切片对应安全、合规或昂贵人工审核,平均提升绝不应抵消它。发布门需要同时写下:总体最小实用增益、每个关键切片的最大允许退化、样本量、置信度、延迟/成本上限及明确 rollback(回滚)动作。
Champion–Challenger 发布门
用键盘或按钮改变候选模型的增益与最差切片,观察“总体更好”何时仍应拦截。
03 一份候选比较集应冻结什么?#
Evaluation Manifest(评测清单)至少固定 dataset_snapshot、feature_revision、label_revision、成熟窗口、model_digest、阈值政策、切片字典、随机种子与代码 digest。对表格模型,输入批量 的形状为 [B,D],输出概率为 [B];对多分类,输出通常为 [B,C],其中 是类别数,门禁必须明确比较哪个类别、哪个阈值和哪种业务损失。
manifest@e17
  data: snapshot@r42, as_of=2026-09-15, mature_window=14d
  features: fraud_view@a91c, X dtype=float32, columns=[D]
  labels: chargeback@v7, one label per prediction_id
  champion: sha256:..., challenger: sha256:...
  policy: min_delta_auc=0.005; worst_slice_delta >= -0.003
operation: shadow 5% → canary 1% → rollback by model digest按时间切分比随机切分更贴近发布:例如用 1–6 月训练、7 月调参、8 月作为冻结测试。若随机打散,来自同一活动、同一用户或相邻时段的模式会同时出现在训练与测试,离线结果会虚高。再训练不是寻找“最漂亮的一次跑分”,而是在一次次候选间保留可复查的选择记录。
04 用最小代码实现“政策”,而不是把判断藏在笔记里#
下面的函数输入 champion_loss、challenger_loss,均为 [N];critical_mask 也是 [N] 的布尔数组,标识预先定义的关键切片。返回每条门的结果和数值证据。这里把损失下降定义为正向增益 ,不同业务可替换为收益、校准误差或约束优化的目标,但符号与阈值必须固定。
from dataclasses import dataclass
import numpy as np

@dataclass(frozen=True)
class GateResult:
    overall_gain: float; critical_gain: float; promote: bool; reason: str

def promotion_gate(champion_loss: np.ndarray, challenger_loss: np.ndarray,
                   critical_mask: np.ndarray, min_overall_gain: float = 0.005,
                   min_critical_gain: float = -0.003) -> GateResult:
    if champion_loss.shape != challenger_loss.shape or champion_loss.ndim != 1:
        raise ValueError('loss arrays must both have shape [N]')
    if critical_mask.shape != champion_loss.shape or not critical_mask.any():
        raise ValueError('critical_mask must be [N] and select at least one row')
    delta = champion_loss - challenger_loss  # [N], positive means challenger is better
    overall, critical = float(delta.mean()), float(delta[critical_mask].mean())
    if overall < min_overall_gain:
        return GateResult(overall, critical, False, 'overall gain below practical threshold')
    if critical < min_critical_gain:
        return GateResult(overall, critical, False, 'critical slice breached guardrail')
    return GateResult(overall, critical, True, 'offline gates passed; begin reversible shadow')

champion = np.array([.20, .20, .10, .10], dtype=np.float32)
challenger = np.array([.18, .18, .25, .25], dtype=np.float32)
print(promotion_gate(champion, challenger, np.array([False, False, True, True])))
# promote=False: critical slice lost despite an average gain这不是可直接替代统计检验的“黑盒上线按钮”。生产门还应给出 bootstrap(自助法)置信区间或预注册的序贯试验规则,并拒绝样本不足的比较。若请求天然按用户、商户或会话聚类,重采样单元也应是该聚类,而不是假装每一行独立。
05 离线通过后,为什么仍要影子和灰度?#
离线评测回答“在冻结历史上是否值得试”;Shadow Evaluation(影子评测)让 challenger 接收真实请求却不影响用户;Canary(灰度)才把小部分可见决策交给它。每一步都需要选择性地扩大,而不是把“通过”理解成全量绿灯。
| 阶段 | 用户是否看到 challenger 输出 | 要核对的信号 | 失败动作 |
|---|---|---|---|
| 离线冻结集 | 否 | 成熟质量、关键切片、置信区间 | 保留 champion,定位数据/训练假设 |
| 影子 | 否 | 特征回放一致、延迟、成本、输出契约 | 停 shadow,修服务或版本绑定 |
| 1% 灰度 | 是,受护栏限制 | 业务损失、拒绝率、安全切片、SLO | 按 digest 回滚并保全证据 |
| 扩量 | 是 | 序贯门、容量、长期标签 | 暂停扩量,不将短期代理信号当真值 |
06 常见误判与调试路径#
典型失误包括:反复调参后才看测试集、每次失败就更换切片或阈值、将不同标签定义混入同一 AUC、只记录平均数而不保存分子分母、忽略 shadow 的副作用隔离,以及用不同硬件/批大小比较延迟。调试从 manifest 开始:检查每行的 as_of、特征列顺序、模型 digest 和 label revision;然后复算一个切片的原始聚合;最后再审计门限是谁、何时、为何修改。
Champion–Challenger 也不能证明因果收益:流量分配、反馈回路和用户行为会在灰度中改变。高风险系统还需要人工审核、政策约束、可解释证据和独立安全评测。它提供的是一条可撤销的学习路径,而不是一次“永远正确”的模型认证。
思考练习#
- 若高风险切片每周仅有 30 个成熟样本,怎样设定最小样本、置信区间和人工审核,而不把它从门禁中删除?
- 为什么同一用户的多次预测不应简单地按行 bootstrap?应按什么单位重采样?
- 一个 challenger 的 AUC 上升但 ECE 恶化,且业务靠概率排序做额度分配;你会增加哪条发布门?