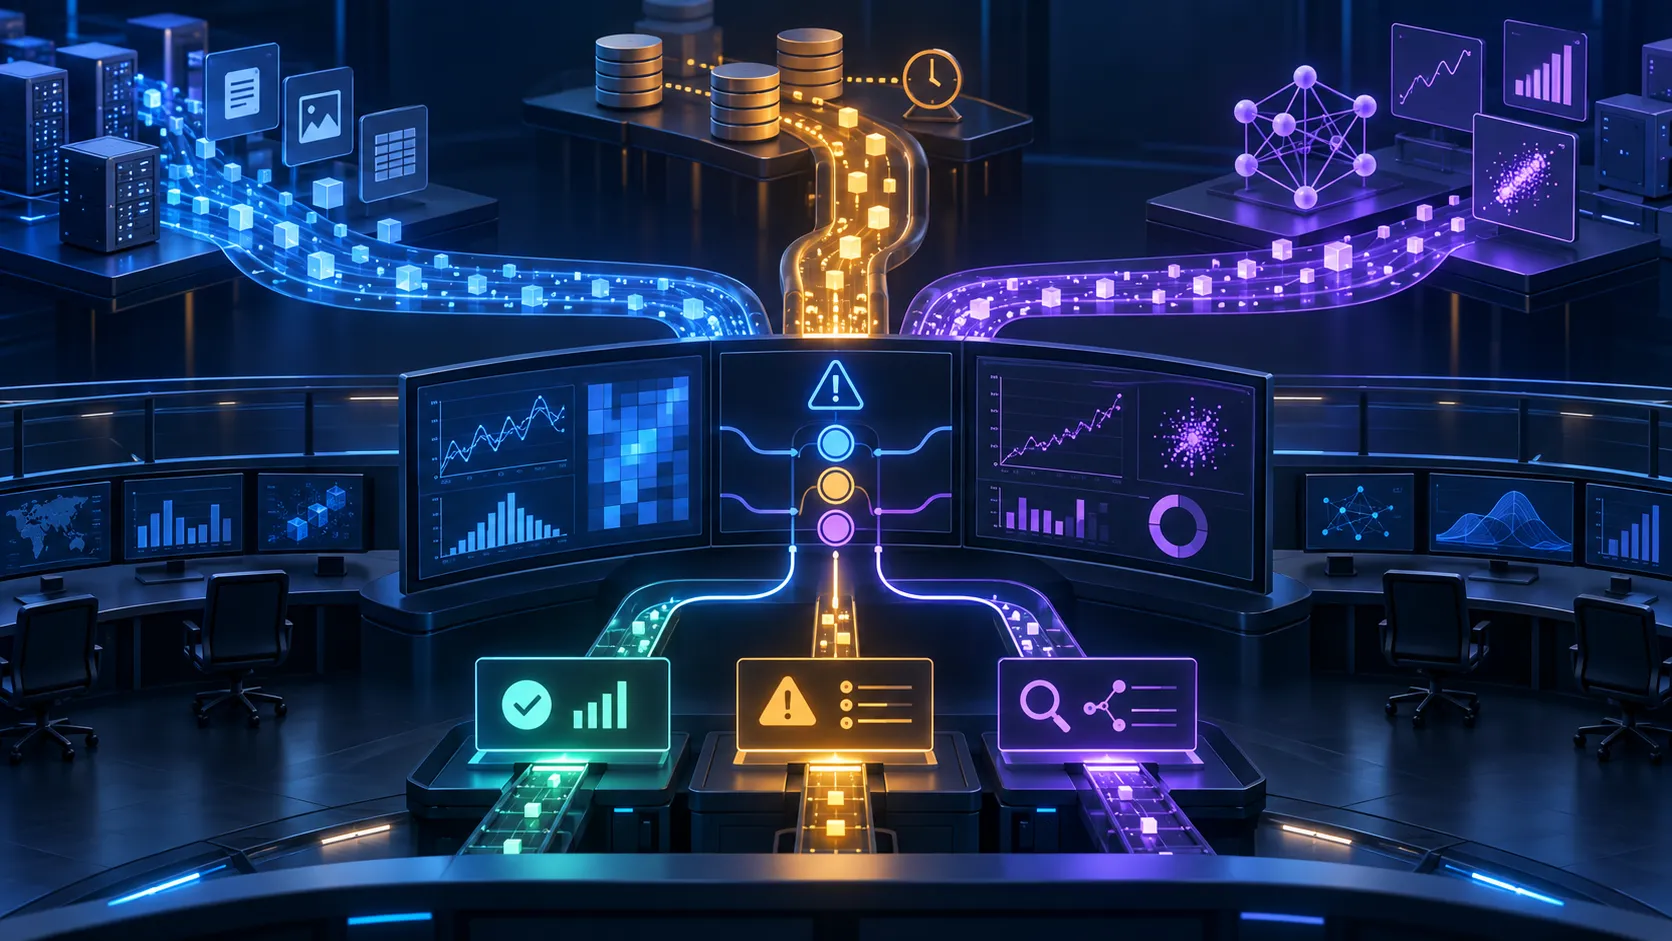
告警后先查哪里?分辨输入漂移、标签断流与模型失效
把“指标变了”拆成可证伪的三条链路:输入分布、延迟标签证据和成熟质量;用极小例子、PSI 与分诊伪代码避免盲目重训。
上一篇把 challenger 的离线比较变成了可回滚的发布门;它回答“值得不值得试”,却不能保证上线后的每一次告警都代表模型本身失效。没有成熟标签时,不能把“未知”偷偷当成负例;同样,看见某个分布或 AUC 变动,也不能立即重训。上游字段改名、标签流水线中断、流量策略改变和真正的 Model Decay(模型失效)会留下相似的总体曲线,处置却完全不同。
本篇只解决一个核心问题:怎样把一次模型告警分诊为 Input Drift(输入漂移)、Label Observability Failure(标签可观测性故障)或成熟质量变化,并让每一步都能被反证。 下一篇将进入发布后的版本绑定与持续评估:让已经通过门的模型仍保持可追溯、可停止。
01 不要从一个红灯直接跳到“重训”#
一次线上窗口的记录可写成输入 、模型分数 和成熟后才可得到的标签 。这里 是全部请求数, 是特征数, 是已成熟且一对一连接成功的请求数。若有人只展示“本周 AUC”,却没有给出 、模型 revision 与标签 revision,就无法判断它是在测模型,还是在测数据管道。
flowchart LR
  R[request + feature vector X: N × D] --> I[input checks\nmissing / PSI / OOV]
  R --> P[predictions\nscore s: N]
  P --> W{maturity window Δ passed?}
  L[label events] --> W
  W -->|mature + unique| Q[quality join\ny, s: M]
  W -->|pending or missing| O[label observability]
  I --> T[triage evidence]
  O --> T
  Q --> T
T --> A[contract fix / label repair / rollback or challenger]三条链路不是互斥的:字段缺失会导致分数分布改变,标签团队也可能恰好发布了新定义。但分诊的目标不是替根因猜谜,而是缩小下一条可检验的假设。
02 极小手算:同样“正例率下降”,含义完全不同#
某天 8 个请求的基线正例率为 50%。其中 4 条已过成熟窗口:p1,p2,p3,p4。今天连接到的标签是 ,另外两条成熟样本没有标签;其余 4 条仍在窗口内。若只看已连上的两条,正例率是 ;若把所有缺失补 0,便成 ,仿佛业务突然变好。
id      mature?      label state       score
p1      yes          confirmed 1       0.90
p2      yes          confirmed 0       0.70
p3      yes          missing           0.88  ← 评测链路问题候选
p4      yes          missing           0.15
p5-p8 no pending ... ← 尚不能评价正确的两个数字是成熟标签覆盖率 ,以及在已连接样本上的质量指标。覆盖率下跌先指向 Join、去重、成熟期或标签生产;它不能证明模型改善或恶化。反过来,若覆盖率稳定、模型和标签 revision 不变、多个成熟窗口中校准误差持续升高,才有更强证据怀疑概念或输入—目标关系改变。
漂移分诊台
切换观察到的信号,先决定该查输入、评测链路还是模型语义。
03 输入分布变了,怎么量化且不被总体平均骗过?#
Population Stability Index(总体稳定性指数,PSI)把冻结的基线桶与当前桶逐一比较。对第 个桶,基线占比 、当前占比 ,常用描述量为:
它回答“分布是否不同”,不回答“性能是否下降”或“哪个业务动作导致不同”。桶边界必须由健康窗口冻结;每个桶再加极小平滑 ,避免零比例使对数未定义。对类别特征,重点还包括 Unknown Token(未知词元)率、缺失率与新类别;对向量特征,先监控范数、每维摘要或经过版本固定的投影,不能把 [N, 768] 直接揉成一个无意义总数。
下面函数的输入都是形状 [N] 的一维数值特征;baseline_edges 是长度 [K+1] 的冻结边界。输出标量 PSI,同时返回每桶比例,便于排查“哪一段变了”。
import numpy as np

def psi(reference: np.ndarray, current: np.ndarray, baseline_edges: np.ndarray) -> tuple[float, np.ndarray, np.ndarray]:
    if reference.ndim != current.ndim or reference.ndim != 1:
        raise ValueError('reference and current must both have shape [N]')
    if len(baseline_edges) < 2 or not np.all(np.diff(baseline_edges) > 0):
        raise ValueError('edges must be strictly increasing')
    ref, _ = np.histogram(reference, bins=baseline_edges)
    cur, _ = np.histogram(current, bins=baseline_edges)
    eps = 1e-6
    p = (ref + eps) / (ref.sum() + eps * len(ref))
    q = (cur + eps) / (cur.sum() + eps * len(cur))
    return float(np.sum((q - p) * np.log(q / p))), p, q

edges = np.array([0., 10., 20., 30.])
value, p, q = psi(np.array([2., 5., 12., 19.]), np.array([22., 23., 25., 28.]), edges)
print(round(value, 3), p.round(2), q.round(2)) # 13.816 [0.5 0.5 0. ] [0. 0. 1.]实践中不要把 13.816 当通用阈值。先用历史健康窗口估计每个特征、每个切片的自然波动与样本量,再以业务风险设告警政策。较小样本的桶比例本身会抖动;先报告计数与置信区间,不能把采样噪声说成漂移。
04 用固定顺序把“观察”变成证据链#
分诊的输入不是裸指标,而是一份 Evidence Bundle(证据包):window、model_digest、feature_revision、label_revision、成熟规则、样本数和允许的切片。这样同一个告警可被复跑,而不是靠某张实时图回忆。
triage(window, baseline):
  pin model, feature, label revisions and time zone
  assert mature_coverage(window) >= coverage_floor or return repair_label_path
  check schema, null/OOV rates, and feature PSI by slice
  join only mature, unique labels; compare ECE/AUC with uncertainty
  correlate first change with deploys, source snapshots, and policy changes
return smallest supported hypothesis + reversible next action这里 repair_label_path 不等于忽略模型:它意味着在标签证据不足时,质量结论必须标记为 unavailable(不可用),同时继续监控输入、延迟和业务护栏。ECE、AUC 或业务损失的比较也必须按同一模型、同一标签定义、同一成熟政策进行;模型切换后把不同 revision 混成一个基线,是最难察觉的伪漂移。
| 先观察到什么 | 优先验证 | 不应立刻做什么 |
|---|---|---|
| 单列缺失率、OOV、PSI 跳变 | 数据契约、上游部署、回放首个差异列 | 直接重训以“适应”坏数据 |
| 成熟 coverage 跌落 | prediction_id Join、成熟期、标签 revision | 将缺失标签补 0 算 AUC |
| 覆盖稳定而成熟质量持续下跌 | 时间切片、策略/产品改动、候选回放 | 只凭总体平均全量回滚 |
05 调试时先找“第一处不一致”#
常见失败是:用滚动分位数重新分桶(让 PSI 看起来稳定)、UTC 与本地日界混用、特征 revision 已更新但模型签名未更新、标签定义改变却继续比较旧 AUC,以及只聚合总体隐藏受影响小群体。调试顺序应是:
- 固定时区、时间窗和所有 revision,确认样本数、成熟数、唯一 Join 数。
- 抽一个异常切片,沿 raw event → feature view → request → prediction → label 打印键与时间,不打印敏感原文。
- 找到第一个变化的列、规则或 revision,再用健康窗口复放最小反例。
- 选择可逆动作:隔离坏字段、修标签管道、扩大人工审核,或让 challenger 进入影子流量。
PSI 与质量漂移也有天然盲点:协变量分布不变时,用户偏好或对抗行为仍可能改变;有些输入改变反而提高表现。它们是排查的触发器,不是因果证明。下一篇将把这份证据接入发布后的版本绑定与持续评估,确保已经进入灰度的模型仍有明确的停止与回滚条件。
思考练习#
- 某地区的
income缺失率上升,但该字段在当前模型中未使用;还应怎样处理这条数据契约告警? - 标签覆盖率从 95% 降到 70%,且缺失集中于高分样本;为何不能只在“已标注”样本上比较 AUC?
- 若一次产品策略切换让流量人群改变,怎样设计影子评测来分开输入组成变化与模型失效?