预填充为何会拖慢正在生成的请求?Disaggregated Prefill/Decode 的 KV 传输与资源隔离
从 Prefill–Decode 干扰出发,追踪请求跨 P/D 实例的数据流,手算 KV 体积与传输下限,说清分离为何改善尾延迟却不自动提升吞吐。
上一篇的 Automatic Prefix Caching(自动前缀缓存)避免了重复 prompt 的计算;但首次出现的长 prompt 仍必须做 Prefill(预填充)。若 Prefill 与正在逐 token 输出的 Decode(解码)共用同一个 GPU worker,一个长 prompt 就可能让许多流式回答同时卡顿。
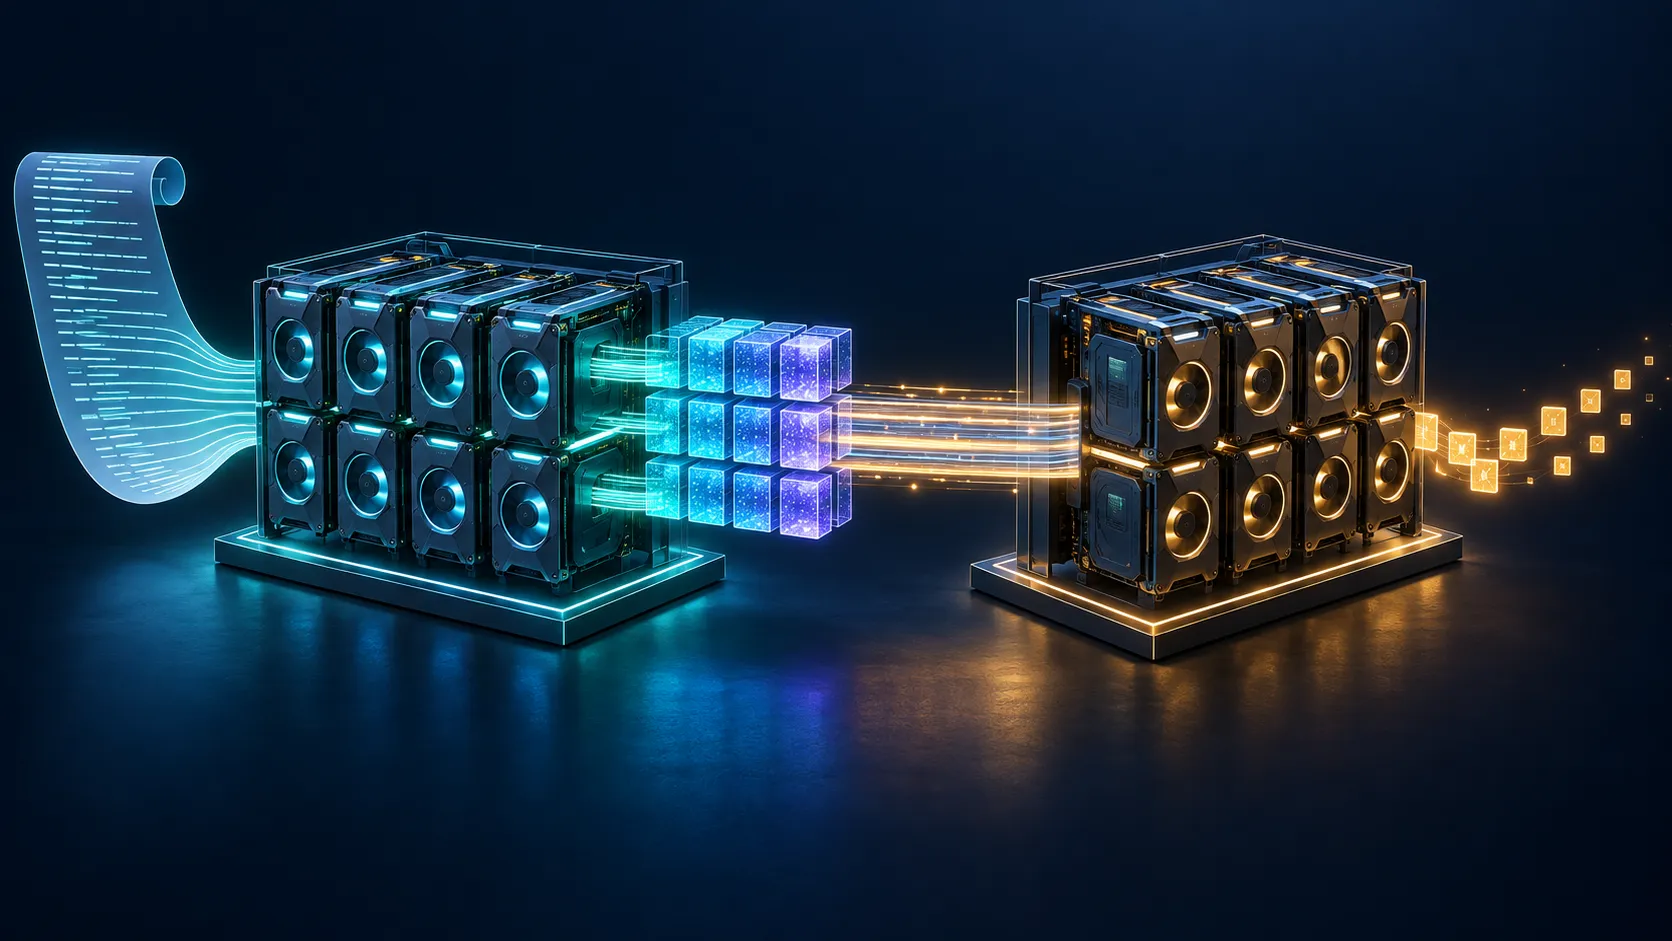
Disaggregated Prefill/Decode(预填充—解码分离,简称 P/D 分离)把两个阶段放到不同实例。Prefill worker 生成首 token 所需的模型状态,再把 KV Cache 交给 Decode worker。它主要解决资源干扰和独立扩容,不是把一次推理凭空变少。
01 Prefill 与 Decode 为何会互相干扰?#
Prefill 一次处理 个 prompt tokens,矩阵乘法有较大的 token 维,更容易利用 GPU 算力。Decode 每条活跃序列每轮只产生一个 token,却要读取模型权重与历史 KV,通常更敏感于内存带宽。
合并 worker 的某些轮次

时间  0       1               2       3
      [decode][长 prompt prefill][decode][decode]
^ 已在生成的请求等待Continuous Batching 可以插入 Prefill,Chunked Prefill 可以把它切小,但两类工作仍在争抢同一组 SM、HBM 带宽和 KV blocks。当我们紧盯 Time To First Token(首 token 延迟,TTFT)和 Inter-Token Latency(token 间延迟,ITL,也常称 TPOT)的高分位数时,平均吞吐相同并不代表用户体感相同。
02 分离后的完整数据流#
flowchart LR
  C[客户端 messages] --> R[路由层]
  R -->|prompt + request id| P[Prefill 实例]
  P -->|tokenize| T[token ids]
  T -->|forward| K[KV blocks + 首 token]
  K -->|KV Connector| D[Decode 实例]
  R -->|decode 请求 + transfer params| D
D -->|stream tokens| C这里有两条不能搞混的通道:
- 控制面传递 request ID、匹配键、模型版本、块列表与“KV 已可读”状态;
- 数据面传递每层 Key/Value tensors,数量远大于元数据。
Decode 不能在 KV 未到达时把请求当作普通 cache miss 直接续算;否则可能读到未完成的 block。传输失败策略也要明确:是 fail request,还是在 Decode 端重算 Prefill。
03 KV 到底有多大?#
设模型有 层,共享前缀长度为 ,KV heads 数为 ,每个 head 的维度为 ,元素字节数为 。单请求 KV 的理论体积为
最前的 分别对应 Key 和 Value。它使用 而不是 query heads;在 Grouped-Query Attention(分组查询注意力,GQA)中两者并不相等。
例如 ,则
若实测有效带宽为 ,仅数据搬运的下限约为 ,还未包含排队、块查找、同步和小包开销。
04 用 96 字节手算一次交接#
构造一个极小模型:2 层、2 个 KV heads、head dim 为 2、prompt 长度为 3,用 FP16:
逻辑形状可记为 [layer, K/V, token, kv_head, head_dim] = [2,2,3,2,2]。真实 PagedAttention 不会保证 tokens 在物理上连续,因此连接器传递的还必须是请求的逻辑块与目标端物理块之间的映射,不是把一整段显存地址直接复制。
05 传输与计算能否重叠?#
若每层完成后就异步发送该层 KV,而不是等所有层结束才发送,部分传输可被后续层计算隐藏。粗略下界是
而串行实现接近 。但“异步 API 已返回”不等于数据已可被 Decode kernel 读取;必须有 stream event、completion queue 或等价的完成契约。
# 伪代码:控制面和数据面的最小契约
ticket = connector.reserve(request_id, block_table, model_revision)

for layer_id, (key, value) in enumerate(prefill_forward(prompt_ids)):
    connector.send_layer_async(ticket, layer_id, key, value)

connector.commit(ticket)       # 不可在任一层失败时提前可见
decoder.wait_ready(ticket)
decoder.attach_blocks(ticket)
decoder.generate(first_sampled_token)06 为什么分离不自动提高吞吐?#
同一请求仍要运行完整 Prefill 和 Decode,还新增了 KV 搬运、两个副本的模型权重以及路由协调。分离的直接收益是:
- Prefill 不再抬高 Decode 的尾部 ITL;
- P 池和 D 池可独立选择 Tensor/Pipeline Parallel 与批大小;
- 长 prompt 流量与长输出流量可独立扩容。
当传输过慢、请求很短或合并调度已能良好隔离干扰时,P/D 分离可能更慢。vLLM 当前官方文档也明确将其定位为分别调优 TTFT/ITL 与控制尾 ITL,而不是吞吐优化开关。
07 当前 vLLM 如何表达这个契约?#
当前 vLLM 将 Disaggregated Prefilling 标记为 experimental(实验性),实现放在 vllm.distributed.kv_transfer。生产者和消费者通过 KV Connector 协调;NIXL 连接器的当前配置形状是:
# Prefill 实例
vllm serve your-org/your-model \
  --port 8100 \
  --kv-transfer-config '{
    "kv_connector":"NixlConnector",
    "kv_role":"kv_producer"
  }'

# Decode 实例
vllm serve your-org/your-model \
  --port 8200 \
  --kv-transfer-config '{
    "kv_connector":"NixlConnector",
    "kv_role":"kv_consumer"
}'路由层还需将 Prefill 返回的 kv_transfer_params 与请求绑定后交给 Decode。对 chat endpoint,当前实验性路径还可用 return_token_ids 把 Prefill 已产生的 prompt_token_ids 传给 Decode,避免再次模板渲染与 tokenization。
08 传输失败时必须保证什么?#
一次交接应该像事务而不是零散 memcpy:
- request ID 与 model/tokenizer revision 必须一致;
- 只有全部必需 layers/blocks 到达后才可 commit;
- 请求取消要释放 P、D 两端的临时块;
- 超时后重试不能把旧 ticket 误配给新请求;
- 若选择 recompute fallback,必须统计它,否则“成功率 100%”会掩盖传输故障。
09 如何证明输出没有改变?#
最强的小测试是在固定模型、dtype、tokenizer 和 greedy decoding 下做 A/B:
A: 同一实例内 Prefill + Decode
B: Prefill 实例 -> KV transfer -> Decode 实例

断言:prompt token IDs 相同
断言:每层已传输 KV 的 shape/dtype 相同
断言:首 token logits 在选定容差内一致
断言:最终 token IDs 完全一致再加入 block 边界、左侧 padding、GQA、LoRA、请求取消、中途断网和目标端 KV 紧张的故障注入。不只要比较最终文本;文本巧合相同可能掩盖了中间 logits 或位置索引错误。
10 性能实验怎样拆出真正收益?#
至少对比三组:合并 Continuous Batching、合并 + Chunked Prefill、P/D 分离。对每组扫描 prompt/output 长度、到达率和 burstiness,记录:
- TTFT p50/p95/p99,ITL/TPOT p50/p95/p99;
- Prefill 排队、Decode 排队和交接等待;
- KV bytes、有效 GB/s、传输失败与重算数;
- P/D 利用率、等待请求、KV usage 与 preemptions;
- 同时满足 TTFT 和 TPOT 约束的请求率。
网络拓扑必须写进结果。同机 NVLink/PCIe、同 rack RDMA 与跨 rack 的传输下限不在同一量级,只报“P/D 分离更快”无法复现。
11 常见错误与最短调试路径#
| 症状 | 常见原因 | 最短检查 |
|---|---|---|
| Decode 偶发输出乱码 | 块表/request ID 误配 | 记录 ticket、逻辑块和目标物理块 |
| TTFT 反而升高 | KV 传输超过干扰收益 | 拆分 prefill、xfer、sync、queue 时间 |
| ITL 仍有长尾 | Decode 池过载或有重算 fallback | 看 D 等待队列与 recompute 计数 |
| 两端显存泄漏 | 取消/超时没有对称释放 | 注入 cancel,对账 block ref counts |
| 精度不稳定 | KV dtype/layout 或位置契约不同 | 逐层校验 shape、dtype、position |
| P 空闲、D 排队 | P/D 实例比例不匹配输出长度 | 分别量 prompt/output token service rate |
12 它与相近方法有什么不同?#
Chunked Prefill 留在同一 worker 内,通过 token budget 切小干扰;P/D 分离用物理资源边界隔离干扰,代价是 KV 传输。Automatic Prefix Caching 避免重复 Prefill,并不决定 Prefill 在哪里执行。KV Offloading 把 KV 移向 CPU/外存以扩大容量,而 P/D 交接是为了让另一个模型实例继续计算。
13 失败场景与局限#
- prompt 和 output 都很短,路由与传输成为主成本;
- 网络过订阅或 P/D 跨越低带宽拓扑;
- P 池和 D 池比例固定,但流量的 prompt/output 分布持续变化;
- 多轮对话的 KV 一直在 D 端,下一轮却需回到 P 端继续 Prefill;
- 模型、adapter、tokenizer 或 KV layout 在两池中漂移;
- 隔离了计算干扰,却把故障面扩大到路由、网络与两组副本。
14 今天真正需要记住什么?#
- Prefill 和 Decode 的并行形状、瓶颈与延迟目标不同,共享 worker 会形成尾延迟干扰。
- P/D 分离必须传递完整且可验证的 KV blocks;传输成本与 prompt 长度成正比。
- 分离使 TTFT 和 ITL 可独立调优,但不保证总吞吐上升。
- 正确性来自 ticket、revision、block mapping、commit 与 failure policy 的完整契约,不只是网络带宽。
15 思考题与小练习#
- 对 的 BF16 KV,计算单请求体积;再估算 25 GB/s 有效带宽下的理论传输下限。
- 为伪代码增加 cancel 和 timeout,保证任何失败路径都不会留下可见的半成品 ticket。
- 设计一组 prompt 长度为 128/2K/16K、output 长度为 32/512 的实验,判断哪些桶最可能从 P/D 分离受益。
相关工作#
- Zhong et al., DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving ↗,系统分析 P/D 干扰、放置与 Goodput。
- Patel et al., Splitwise: Efficient Generative LLM Inference Using Phase Splitting ↗,研究按阶段拆分推理与异构硬件配置。
- Qin et al., Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving ↗,从 KVCache 中心架构讨论分离式服务。
- vLLM, Disaggregated Prefilling 官方文档 ↗,说明当前实验性设计、Connector 与使用边界。
- vLLM, NIXL Connector Usage Guide ↗,给出当前 NIXL 角色配置与双向 KV 传输选项。
16 下一篇预告#
P/D 分离让两类资源可以独立扩容,但“Prefill 两张卡、Decode 两张卡”只是猜测。下一篇将用 SLO Goodput(满足服务目标的有效吞吐)给 P/D 池做容量规划,看清平均吞吐为何会掩盖 TTFT/TPOT 违约。