-
 事故已经恢复,怎样避免下次再来?无责复盘的因果时间线、屏障分析与行动项
从一场模型发布事故出发,把事件清单还原为因果链,用 Five Whys 与屏障分析识别系统条件,并把结论写成可验证、可追踪的改进项。
14 分钟 中文 -
 模型告警后先查根因还是先回滚?ML Incident Response 的分级、止血与证据保全
从一次 LLM 质量事故出发,用影响面、严重度与可逆性完成分级,设计冻结变更、降级、回滚、证据保全和受控恢复的事故响应闭环。
20 分钟 中文 -
 线上回答没有报错,为何质量仍在下滑?LLM Drift Monitoring 的切片、参考窗口与 CUSUM
从无即时真值的线上回答出发,区分输入、模型与评测器漂移,手算单侧 CUSUM,用分层代理指标、延迟标签和可执行门槛发现渐进回退。
17 分钟 中文 -
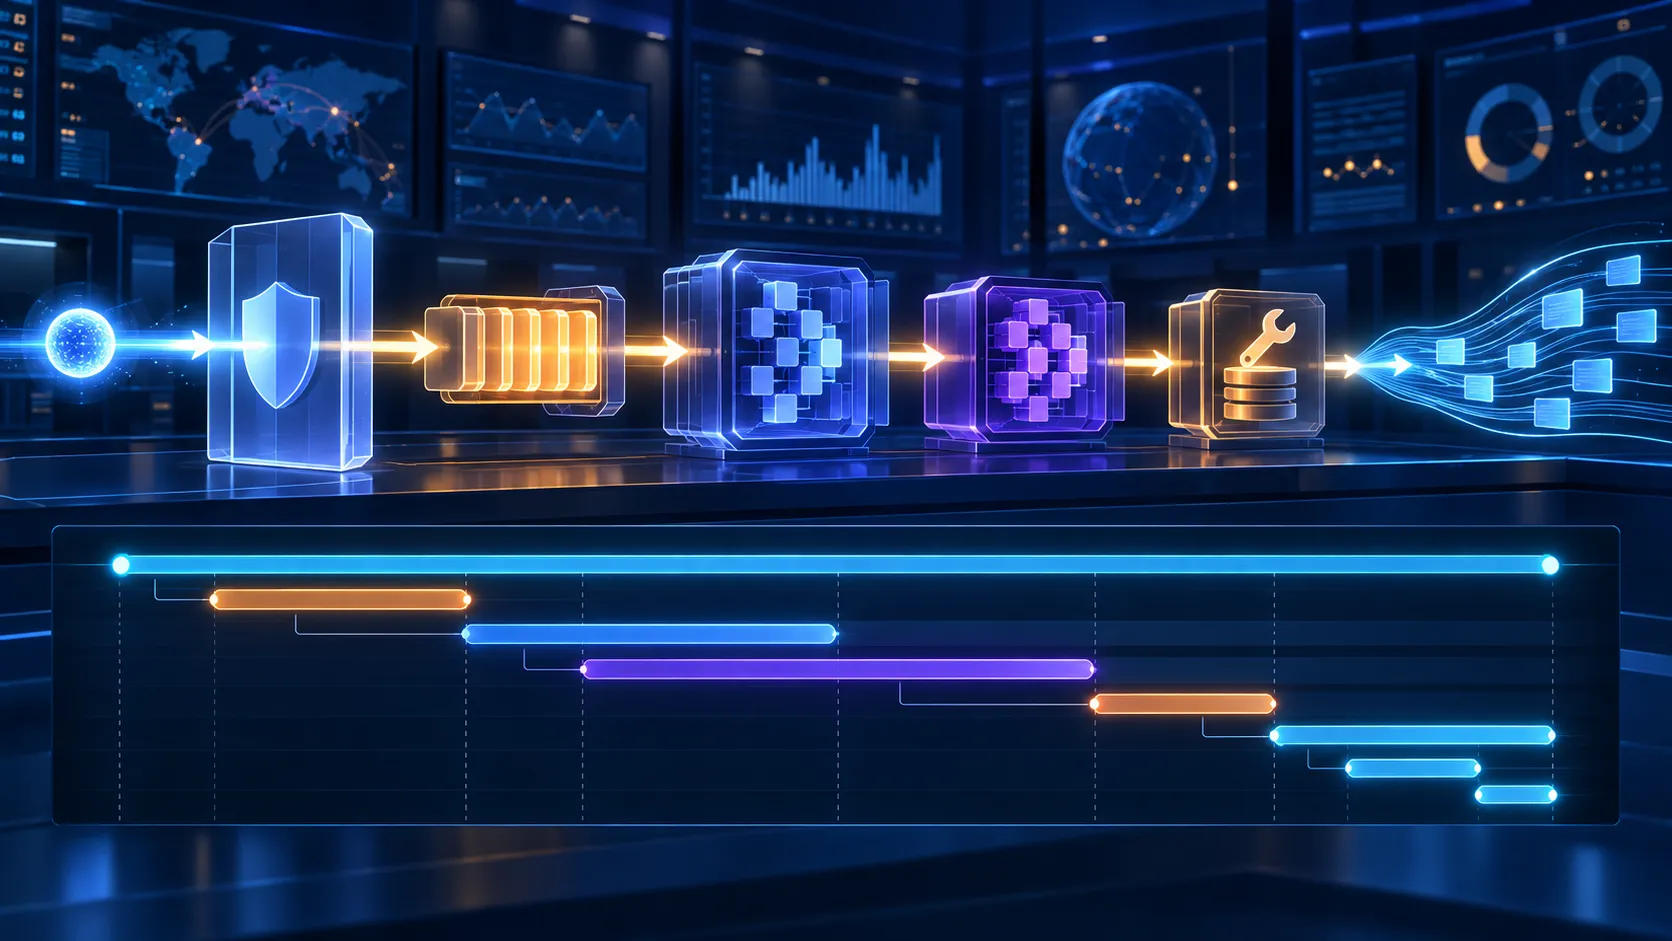 一次回答慢了 2 秒,时间究竟丢在哪?LLM Request Tracing 的 Span、关键路径与采样
从一个端到端慢请求出发,构造跨网关、排队、Prefill、Decode、工具与流式传输的时间线,手算关键路径并用 OpenTelemetry 落地安全采样。
14 分钟 中文 -
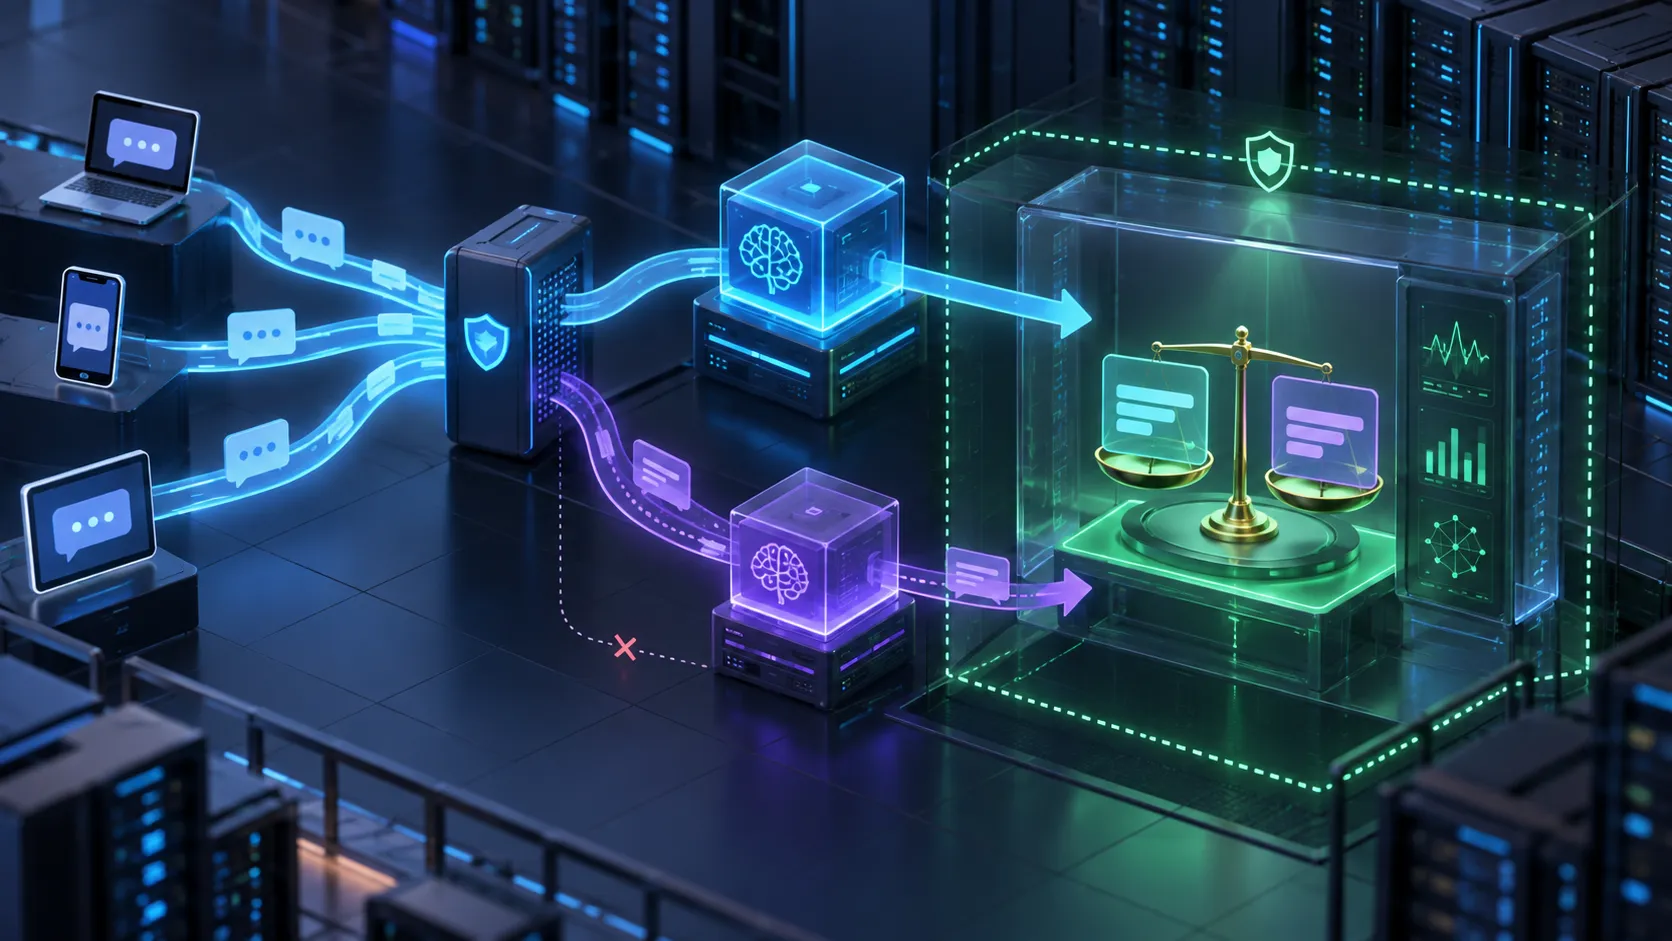 不让用户看见新版回答,怎样用真实流量先验收?LLM Shadow Evaluation 的镜像、配对与副作用隔离
从离线集与线上分布错位出发,设计隐私安全的请求镜像、确定性重放、逐请求配对比较、容量预算与副作用隔离。
19 分钟 中文 -
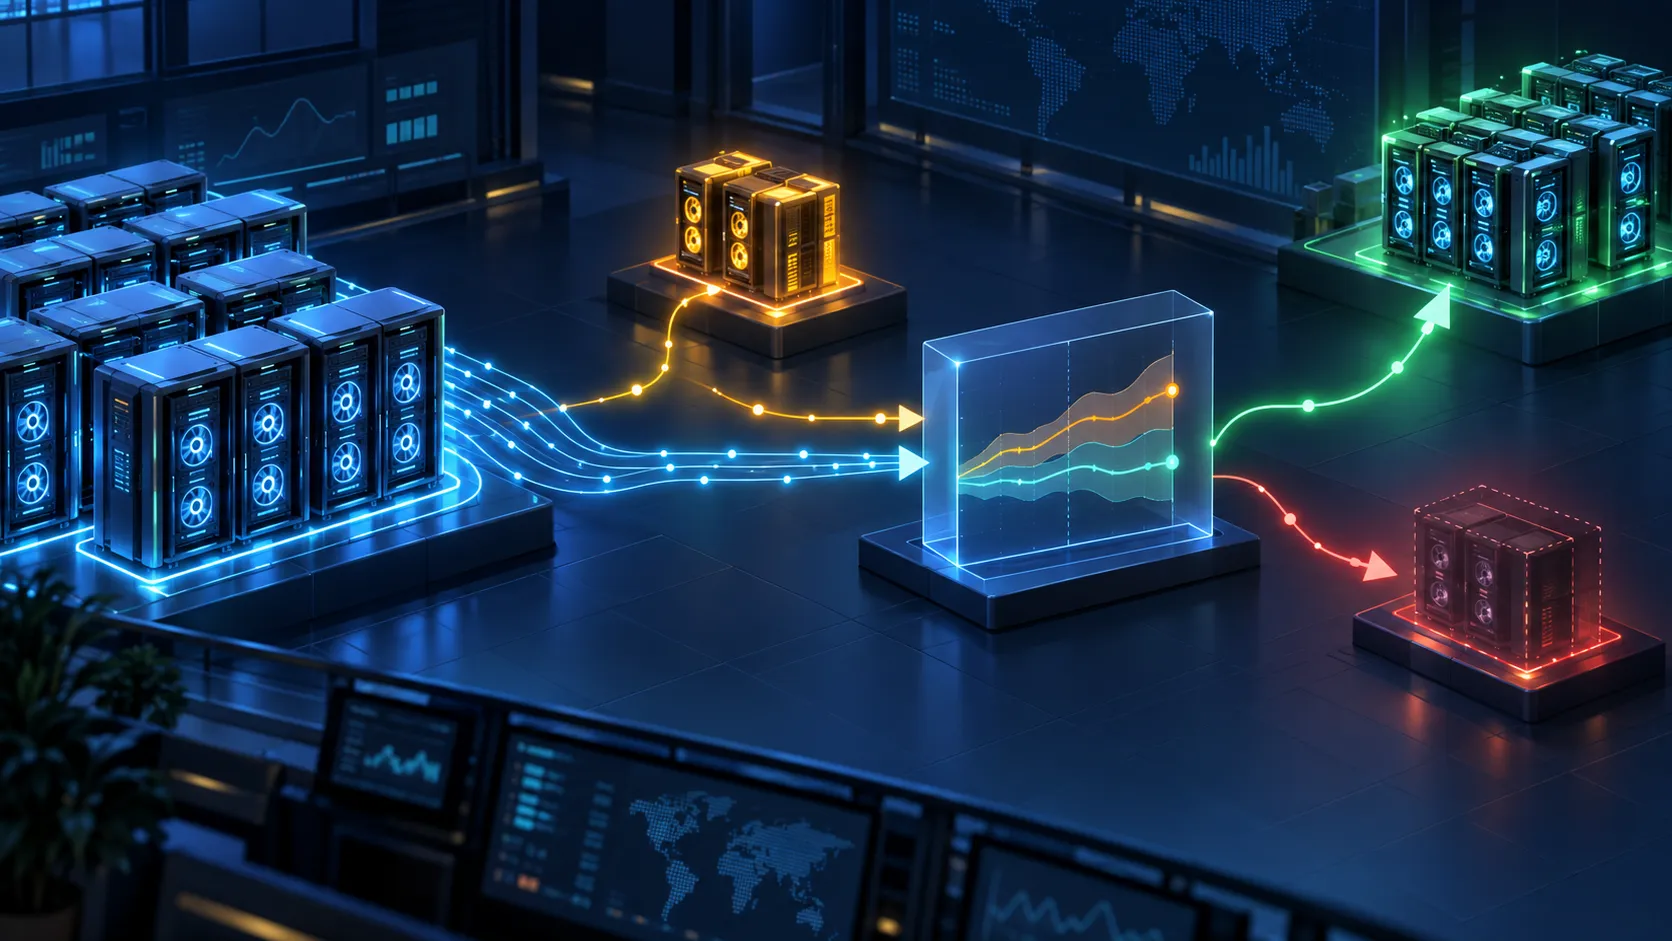 只给新版 5% 流量,多久才敢继续扩量?LLM Canary Analysis 的样本量、序贯门槛与护栏
从小流量灰度的低统计功效出发,手算错误率差异,设计分层对照、序贯判定、质量护栏与自动扩量状态机。
19 分钟 中文 -
 新版副本已 Ready,为何发布仍会截断回答?LLM Rolling Update 的预热、排水与回滚门槛
从长连接被中断与 GPU 容量超卖出发,手算滚动更新的 surge、可用容量和排水预算,设计版本感知的预热、切流与自动回滚。
18 分钟 中文 -
 新 GPU 为何迟迟不 Ready?拆解权重加载、预热与冷启动
从扩容后副本长时间不可用出发,拆解权重分发、本地读取、Host-to-Device 传输、引擎初始化与预热门槛。
16 分钟 中文
返回