拒绝自动决策之后,系统真的更好吗?三条执行路径的结果与容量审计
把自动决策、旧策略回退和人工复核接入同一决策账本,用固定入口分母、成熟结果覆盖率和复核队列守恒,识别看似漂亮的路径均值背后的选择与容量问题。
上一篇把效应不确定性写进拒绝决策规则:证据不足时,系统执行旧策略或交给人工。于是新的问题出现了:自动路径的转化率是 50%,人工路径是 100%,是不是应该把更多用户交给人工?如果人工的“100%”只来自一名已经完成复核且结果成熟的用户,而排队者和缺失标签都消失在报表里,这个结论就站不住。
本篇建立一份按入口路径保留全部决策的审计表。沿用之前的一决策一行回放数据,只增加三个紧密关联的检查:入口分母是否完整、结果是否成熟且被观测、人工路径是否承担得起实际工作量。读者最终会得到一段可以直接运行的 Python 审计程序。
01 入口路径、证据状态和最终动作,各记录一列#
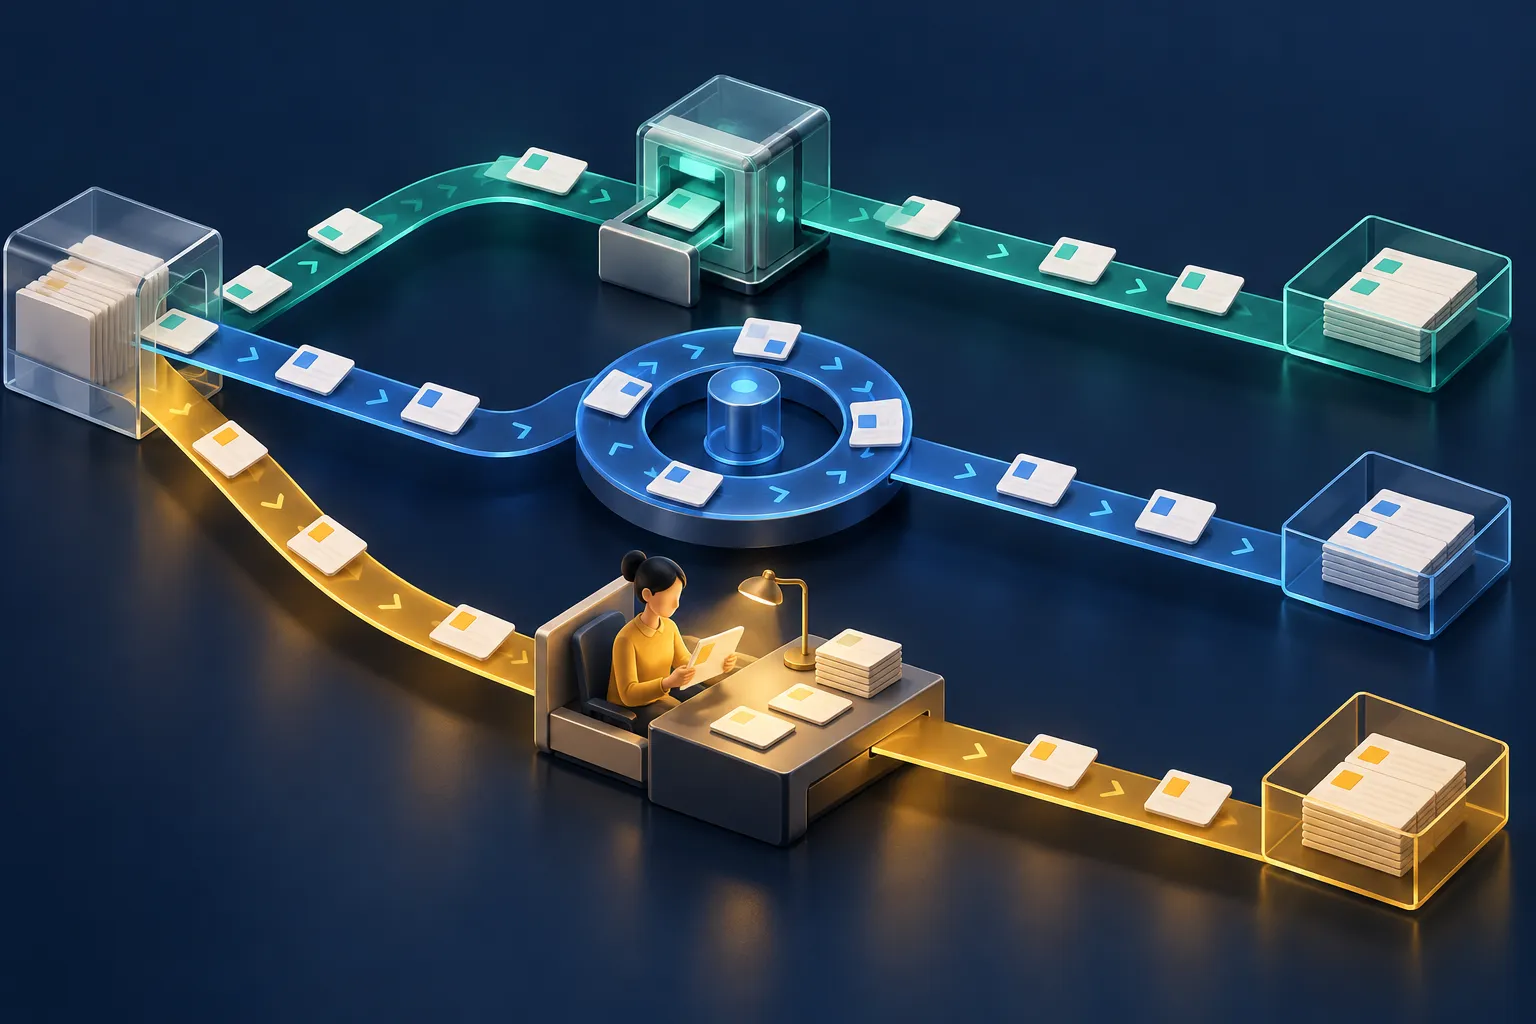
假设系统决定是否发送一次辅导邀请,结果是“决策后 7 天内是否完成报名”。邀请只是动作,报名才是结果。入口路径(entry route)记录这一决策最初由谁负责;拒绝状态(abstention status)记录模型为何没有自动判断;最终动作(executed action)记录实际发送或不发送。
| 入口路径 | 进入条件与责任 | 最终动作可以是什么? | 审计时保留什么? |
|---|---|---|---|
auto:自动决策 | 模型证据通过预定门槛 | 发送或不发送 | 自动决定、执行失败及其结果 |
baseline:基线回退 | 模型拒绝后执行固定版本的旧策略 | 由旧策略决定 | 拒绝原因、旧策略版本、实际动作 |
review:人工复核 | 模型拒绝后提交复核工单 | 人工决定;超时可执行默认动作 | 排队、完成、取消、超时和工作量 |
每次合格决策只能归入一个入口路径。明确无益而自动不干预的情况归入 auto;这里的 baseline 专指拒绝后回退,两者通过证据状态区分。人工复核后即使执行旧策略,也继续归入 review,另外记录终态和最终动作。这样才看得见“先排队再超时回退”的代价。
可以把一行数据读成下面这条短流程;每个分支最终都要回到账本:
合格决策:固定 decision_id 与入口时间
  ├─ auto:自动决定 → 执行回执
  ├─ baseline:旧策略 → 执行回执
  └─ review:排队 → 人工 / 超时 / 取消
                     ↓
同一入口键:连接成熟结果与实际工作量对 个决策,入口特征可表示为 ,其中 是处理前特征数;路径 、拒绝状态 、最终动作 和结果 都是形状 [n] 的数组,枚举值与缺失值有独立语义。若路径选择器输出概率,完整概率矩阵是 [n, 3],列顺序固定为 auto、baseline、review;它与“发送邀请的概率”是两种不同对象。
路径规则、旧策略、模型、复核协议与结果定义都需要版本号。人工看到的资料范围也属于协议:如果复核员能看到模型没有的处理前信息,之后做因果评估时就要认真处理这部分选择机制。
02 三个分母:进入多少、应该成熟多少、实际观测多少#
先冻结入口队列(entry cohort):在指定时间窗内产生、符合资格的所有决策。以 表示三种路径之一,定义
是该路径进入数, 是路径占比; 是条件成立时取 1 的指示函数(indicator function)。执行失败、复核取消和超时者都属于这个分母。人工完成数可以另报,但不能替换进入数。
结果时间窗从入口决策时间开始。设 为入口时间, 为结果观察窗长度, 为标签保护延迟, 为报表截点, 为结果事件水位(watermark),成熟指示为
延续前文的设定,日历窗口和管道水位必须同时通过。若人工等了三天才处理,这三天仍计入路径结果;否则等待的损失会被移到观察窗之外。研究“执行后七天结果”需要另立结果定义,同时保留入口到执行的等待,不可在同一列中悄悄换时钟。
令 表示该决策的标签在截点前已经可用。成熟数、成熟且观测数、成熟标签完整率分别为
分母为零时,完整率是“不可计算”,显示为空值。二元结果的已观测均值为
它描述该路径成熟且已有标签的子集。只有 时,才能把它直接报告为该路径整个成熟队列的均值。若缺失集中在慢设备或失败工单,已观测子集就会被系统性筛选。标签 None、未成熟和真实的零必须区分;水位声明完整而仍缺标签时,应报告数据异常并查回放表的连接规则。
03 六行手算:100% 的人工结果包含了谁?#
以下全部是教学用合成数据。报表截点为 10 月 20 日 12:00,结果窗 天,保护延迟 天,水位到 10 月 19 日 00:00;时间均为北京时间。已知标签都在截点前入库。
| 决策 | 入口时间 | 路径 | 执行/复核状态 | 7 日结果 | 本次如何计数 |
|---|---|---|---|---|---|
| a1 | 10/10 09:00 | auto | 完成 | 1 | 成熟、已观测 |
| a2 | 10/10 09:00 | auto | 完成 | 0 | 成熟、已观测 |
| b1 | 10/11 09:00 | baseline | 完成 | 1 | 成熟、已观测 |
| b2 | 10/11 09:00 | baseline | 执行失败 | 缺失 | 成熟、标签缺失 |
| h1 | 10/11 09:00 | review | 10/12 完成,耗时 12 分钟 | 1 | 成熟、已观测 |
| h2 | 10/19 09:00 | review | 尚待复核 | 未知 | 未成熟、仍在队列 |
三个路径的进入数都是 ,占比都是 。自动路径 ,均值 。基线路径 ,完整率 ;已观测均值虽然是 1,整个成熟队列的均值暂不报告。人工路径 ,成熟均值为 1,但只有一名成熟对象,另一名还在等待。
因此可以说“本快照的人工路径有 1 名成熟对象,观测结果为 1,另有 1 名待复核”。把这句话缩写成“人工比自动提高 50 个百分点”,就把入口选择、样本量、观察时间和工作量一起藏起来了。
04 容量审计:待办不能随着报表窗口消失#
结果表按入口队列统计,容量表按日历区间统计。今天完成的工单可能是昨天进入的,不能拿“今天进入且今天完成”的子集估计整个队列的消化能力。
对一个日历区间,令 和 分别为期初、期末尚未关闭的工单数; 为进入数, 为人工完成数, 为取消或超时等其他关闭数,则
这里的队列包括等待与处理中工单。此式假定每个工单只进入一次、只关闭一次;重新打开需要单独记录重开流入。D 应拆出取消与超时,避免以大量超时关闭制造“队列恢复”的假象。
在六行例子的完整复核队列中,期初为零,两人进入,一人完成,期末剩一人:。若生产中另有历史未结工单,必须加入期初快照。结果审计的六行表只能给出该入口队列仍未关闭的工单数。
工作量另用分钟核算。设区间内完成工单的平均实耗为 分钟,每小时进入 单,则 是粗略的每小时工作分钟需求。例如每小时进入 6 单、平均每单 12 分钟,需求为 72 分钟/小时,已超过一人每小时最多 60 分钟的理论上限。排班、休息、复杂病例和到达波动会进一步吃掉余量;需求均值低于容量也仍可能出现长等待。上线应同时看未结工单年龄、超时比例、进行中实耗与已完成耗时分布。
05 可运行 Python:报表必须保留空值和待办#
输入是前文回放程序已按截点冻结、去重的一决策一行表。y 是按同一结果定义产生的二元标签或 None,已过滤截点之后才入库的事件。函数输出三个路径的计数、完整率、均值和本队列未关闭工单数。它进行报表聚合;策略模型的训练发生在此前,运行期只读取冻结规则的决策日志。
聚合过程可以先写成伪代码,关键是先计入口,再检查结果:
对每个唯一决策:
  按入口路径增加 N;未关闭的人工工单增加待办数
  若结果窗与水位均成熟:增加 M
    若标签可用:增加 O,累加结果
对每条路径:
  输出 N、M、O、完整率与已观测均值
  只有 M > 0 且 O = M,才输出整个成熟队列均值
另外对完整工单事件流检查期初 + 流入 - 关闭 = 期末from datetime import datetime, timedelta
def instant(text):
value = datetime.fromisoformat(text)
if value.utcoffset() is None:
raise ValueError("时间必须带时区")
return value
def audit_routes(rows, cutoff, watermark, horizon=7, lag=1):
cutoff, watermark = instant(cutoff), instant(watermark)
if horizon <= 0 or lag < 0 or watermark > cutoff:
raise ValueError("观察窗、保护延迟或水位不合法")
ids = [row["id"] for row in rows]
if len(set(ids)) != len(ids):
raise ValueError("decision_id 不唯一")
allowed = {
"auto": {"done", "failed"},
"baseline": {"done", "failed"},
"review": {"pending", "done", "cancelled", "timeout"},
}
stats = {
path: dict(entered=0, mature=0, observed=0,
positives=0, cohort_open=0)
for path in allowed
}
for row in rows:
path, state, y = row["path"], row["state"], row["y"]
if path not in allowed or state not in allowed[path]:
raise ValueError("未知路径或状态")
if y is not None and (type(y) is not int or y not in (0, 1)):
raise ValueError("标签必须是 0、1 或 None")
entered = instant(row["entered_at"])
if entered > cutoff:
raise ValueError("混入截点之后的决策")
end = entered + timedelta(days=horizon)
mature = end + timedelta(days=lag) <= cutoff and end <= watermark
item = stats[path]
item["entered"] += 1
item["cohort_open"] += int(path == "review" and state == "pending")
if mature:
item["mature"] += 1
if y is not None: # y=0 是有效标签,不能写成 if y
item["observed"] += 1
item["positives"] += y
for item in stats.values():
m, o = item["mature"], item["observed"]
item["share"] = item["entered"] / len(rows) if rows else None
item["completeness"] = o / m if m else None
item["observed_rate"] = item["positives"] / o if o else None
item["mature_rate"] = item["observed_rate"] if m > 0 and o == m else None
return stats
def queue_balance(opening, arrivals, completed, other_closed, closing):
counts = (opening, arrivals, completed, other_closed, closing)
if any(type(x) is not int or x < 0 for x in counts):
raise ValueError("队列计数必须是非负整数")
expected = opening + arrivals - completed - other_closed
if expected != closing:
raise ValueError("队列不守恒:检查重复关闭、重开、漏单或期初快照")
return closing
def row(key, day, path, state, y):
return dict(id=key, entered_at=f"2026-10-{day:02d}T09:00:00+08:00",
path=path, state=state, y=y)
rows = [
row("a1", 10, "auto", "done", 1),
row("a2", 10, "auto", "done", 0),
row("b1", 11, "baseline", "done", 1),
row("b2", 11, "baseline", "failed", None),
row("h1", 11, "review", "done", 1),
row("h2", 19, "review", "pending", None),
]
report = audit_routes(
rows, cutoff="2026-10-20T12:00:00+08:00",
watermark="2026-10-19T00:00:00+08:00",
)
for path, item in report.items():
print(path, item["entered"], item["mature"], item["observed"],
item["completeness"], item["mature_rate"], item["cohort_open"])
print("queue", queue_balance(0, 2, 1, 0, 1))
# auto 2 2 2 1.0 0.5 0
# baseline 2 2 1 0.5 None 0
# review 2 1 1 1.0 1.0 1
# queue 1datetime.fromisoformat 将带偏移的字符串解析为明确时刻,timedelta 表达观察窗;二者的语义可查 Python 官方文档 ↗。代码使用标准库,不依赖持续变化的机器学习包接口。set 检查决策键唯一性,None 保留“无法报告”的状态。序列化到 JSON 时保留 null,前端显示“缺失”或“尚未成熟”,不要格式化成 0.00%。
生产调用前固定入口起止时间,排除截点后的执行回执、标签与工单状态;保存源快照、结果定义及水位。上述示例把这些事件预处理留给上一篇的回放程序,聚合阶段仍对重复键、路径枚举、二元标签和时间边界作检查。全局队列平衡需要完整工单事件流与期初快照,不能直接由这份入口队列表替代。
06 从路径报表到因果判断,中间还有一步#
人工路径的均值估计的是 在特定成熟队列中的表现。要回答“把同一个合格对象交给人工会不会更好”,目标是潜在路径结果之差,例如
其中 是预先定义、两条路径都可行的决策人群; 包含按既定协议进入路径 后的等待、动作与结果。二者的区别来自路径选择:系统往往把最难、区间最宽的对象送给人工。
可在两条路径均可接受的边界人群中随机分配路径,并按分配路径分析全部对象,记录超时和交叉执行。若依赖历史日志进行离线估计,则需要决策时信息足以控制混杂、路径概率真实可得且目标路径有支持,以及固定的复核与容量协议。把最终发送动作的概率当作路径分配概率,会给估计器错误的分母。
容量也可能制造对象间干扰(interference):多转入一批人会拉长其他人的等待。小流量试验中观察到的人工表现,扩到全量后未必保持。实验应预先写明容量、准入和超时协议,必要时按时间块或独立服务单元设计分配;协议改变就重新定义待评估的系统。
07 常见错误、调试顺序与方法边界#
| 现象 | 优先检查 | 对应修正 |
|---|---|---|
| 人工结果很好,投诉却上升 | 是否只留下已完成工单 | 恢复入口分母,列出未结年龄和超时 |
| 基线路径突然跌到零 | None 是否被转成 0 | 分开未知、未成熟、真实负例 |
| 拒绝率没变,人工量却翻倍 | 入口总量及回退/人工分支比例 | 同报率与人数,核对路由版本 |
| 队列变短,完成量未增加 | 超时、取消、重开与期初数 | 逐类对账,检查队列守恒 |
| 人工均值高于自动均值 | 入口人群、成熟时间、标签缺失 | 报描述性差异;用合适设计估计因果效果 |
调试从计数开始:确认 sum(N_r) == n,再确认 ;检查零标签确实进入分母,随后比较各路径的时间构成、缺失和执行状态。最后对人工队列核对期初、流入、各类关闭和期末快照。顺序反过来,容易先给脏数据拟合出一套复杂解释。
自测:如果把 h2 的状态改成超时,哪几项会变?
本入口队列未关闭工单从 1 变为 0,队列的其他关闭数增加 1;入口路径仍为 review,进入数仍为 2。若截点和结果水位不变,h2 仍未成熟,人工成熟数与成熟均值都不变。若程序把 h2 改归 baseline,说明它覆盖了入口路径,无法再审计超时回退的成本。
选择性预测(selective prediction)侧重自动接收子集的风险与覆盖率;学习转交(learning to defer)把下游专家能力纳入路径学习目标;本篇的路径审计检查冻结系统实际处理了谁、哪些结果可报告、资源流向哪里。双重稳健离线评估则在识别与支持条件成立时估计候选策略价值。这些环节可以接起来,路径报表中的最高均值不能直接当作最优路由规则。
思考练习#
- b2 的真实标签补到且为 0,其余不变。基线路径的完整率、已观测均值、成熟均值各是多少?若它是因为执行失败而缺失,原来“只看已观测”的报表偏向什么方向?
- 某小时期初未结 20 单、进入 12 单、人工完成 8 单、超时关闭 5 单,期末为 19 单。队列是否守恒?仅凭未结数下降,能否说人工能力足够?还应同时报告什么?
- 设计一次只覆盖边界人群的自动/人工路径实验。写清分配单位、路径概率、入口结果时钟、超时动作与人工容量,并说明如何保留未执行分配路径的对象。
相关工作#
- Geifman & El-Yaniv (2019), SelectiveNet: A Deep Neural Network with an Integrated Reject Option ↗:联合学习预测与拒绝,围绕自动覆盖子集上的风险—覆盖率权衡组织目标。
- Madras, Pitassi & Zemel (2018), Predict Responsibly: Improving Fairness and Accuracy by Learning to Defer ↗:把外部决策者的行为与偏差纳入转交机制,强调评估整个人机系统。
- Mozannar & Sontag (2020), Consistent Estimators for Learning to Defer to an Expert ↗:通过代价敏感学习构造具有一致性性质的转交学习代理目标。
- Dudík, Langford & Li (2011), Doubly Robust Policy Evaluation and Learning ↗:结合结果预测与日志概率校正,为有支持的离线策略价值估计提供方法基础。
下一篇预告#
路径账本揭示了人工能力与等待成本,下一步要决定“哪些拒绝案例值得占用有限复核分钟”。下一篇将把预期增益与复核成本写进预算约束的转交规则,并用独立审计比较它与简单按不确定性排序的差别。