效应估计不确定时,个体化策略何时该干预?用拒绝决策与基线回退守住边界
把条件处理效应的不确定区间与干预成本放进三路决策规则:有把握才干预、明确无益时回到对照、证据不足时拒绝自动决策。
上一篇从不可变决策、执行和结果事件构造一决策一行的离线回放表;更早的文章用双重稳健估计比较冻结策略的价值,并用重抽样检查学出的规则是否稳定。现在来到真实决策的边界:某人的估计效应略高于干预成本,但误差范围很宽,系统应该直接行动吗?把点估计硬切在零点,会把模型噪声变成真实干预。
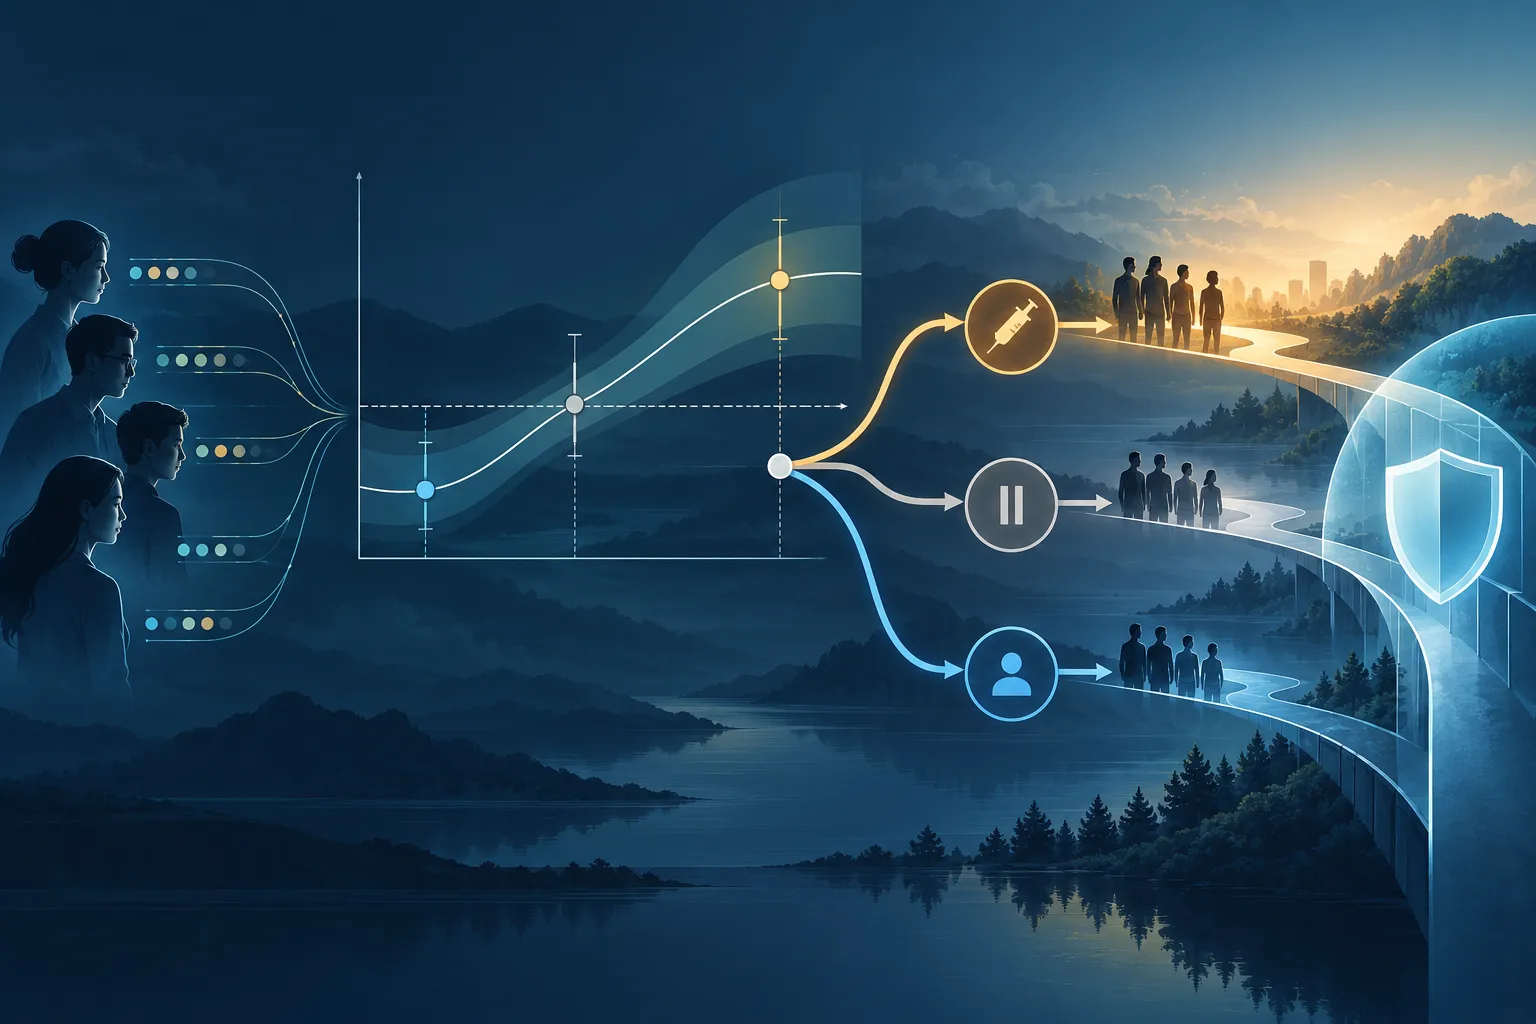
本篇只解决一个问题:**怎样把效应不确定性纳入个体化决策,并明确何时回退到既有基线?**核心规则是三路决策(three-way decision):净收益下界为正才自动干预;净收益上界为负则不干预;区间跨过决策阈值时拒绝自动判定,交给基线策略或人工复核。拒绝不是模型故障,而是可审计的输出类别。
01 点估计越过门槛,不代表风险越过门槛#
令 和 表示样本 在处理与对照下的潜在结果(potential outcomes)。处理效应为 。假设结果越高越好,干预的单位成本折算到相同结果尺度上为 ,则净增益(net benefit)是
若只按 决策,估计值 和 会得到同样的“干预”,即便第一个估计的标准误是 。上一篇的离线策略价值回答策略平均是否有利;这里问的是在单个决策上,证据强度是否足以跨过行动门槛。个体的反事实不能同时观测,因此区间只能来自跨样本模型、设计假设和估计过程,不能把它误称为“这个人效应的客观测量误差”。
flowchart LR
  X[决策时可用特征 X] --> M[诚实估计 τ 与不确定性]
  C[成本 c 与既有基线] --> T[计算净增益区间 L, U]
  M --> T
  T --> D{区间相对 0}
  D -->|L > 0| A[自动干预]
  D -->|U < 0| N[不干预 / 基线]
  D -->|L ≤ 0 ≤ U| R[拒绝自动决策]
  R --> B[既有基线、人工复核或安全试验]
  A --> G[记录模型版本、区间和策略路径]
  N --> G
B --> G02 三路规则:下界、上界与拒绝区#
设估计器给出净增益点估计 和标准误 。一个便于讲解的近似区间为
若 ,即便按区间保守端计算,预期增益仍超过成本,才进入自动干预;若 ,则选择不干预;其余情况进入拒绝区。这里 是参考分布的分位点,比如正态近似下 95% 双侧区间的 。 控制单个区间的名义错误率,但不自动保证不同人群、许多特征切片或反复更新后的总体覆盖率。
| 净增益区间 | 系统输出 | 需要记录的原因 |
|---|---|---|
| 干预 | 保守下界仍为正 | |
| 不干预,沿用基线 | 保守上界仍为负 | |
| 拒绝自动判断 | 证据跨过行动阈值 |
“回退基线”需要明确说清楚:在二元处理、对照即当前常规做法的例子里,回退等于不干预;若生产系统有现行策略 ,拒绝时应执行 ,而非默认置零。若既有策略也不安全或不可用,拒绝路径必须是人工复核、延迟决策或明确的安全默认值。
03 三个人的手算例:同样看似受益,动作不同#
假设效应与成本已经转换到“效用点”单位。为了简单,三人的成本后净增益估计和标准误如下,使用 :
| 人 | 95% 近似区间 | 规则输出 | ||
|---|---|---|---|---|
| A | 2.0 | 1.0 | 干预 | |
| B | 0.5 | 1.0 | 拒绝,回退基线 | |
| C | -4.5 | 1.0 | 不干预 |
A 的下界仍略大于零,所以在假设成立时进入干预;B 的均值为正却没有越过不确定区,不能因为点估计“看起来好”就强行行动;C 的上界仍小于零,支持不干预。A 离门槛仅 ,换一个更保守的临界值或校准误差就可能进入拒绝区,因此实际系统还要对阈值敏感性做诊断。
04 从输出张量到动作:实现规则而非拟合因果模型#
实现层接收已由诚实因果估计流程产生的 effect 与 se。对 个决策单位,两者都是形状 [n] 的一维数组;cost 可以是标量或同形数组;输出为 [n] 个带拒绝状态的动作。以下纯 Python 函数演示决策层,不负责估计处理效应,也不把正态近似包装成普适置信保证。
from math import isfinite


def decide_with_abstention(effect, se, cost, z=1.96, baseline="no_treat"):
    """数组逐项对齐;不确定时输出基线,另保留 abstain 诊断状态。"""
    if len(effect) != len(se):
        raise ValueError("effect 与 se 长度不一致")
    costs = [cost] * len(effect) if isinstance(cost, (int, float)) else list(cost)
    if len(costs) != len(effect):
        raise ValueError("cost 必须是标量或与样本数相同")

    rows = []
    for i, (tau, stderr, c) in enumerate(zip(effect, se, costs)):
        if not all(isfinite(v) for v in (tau, stderr, c)) or stderr < 0:
            raise ValueError(f"第 {i} 行估计、标准误或成本无效")
        net = tau - c
        lower, upper = net - z * stderr, net + z * stderr
        if lower > 0:
            status, action = "treat", "treat"
        elif upper < 0:
            status, action = "no_treat", "no_treat"
        else:
            status, action = "abstain", baseline
        rows.append({
            "net_gain": net, "interval": (lower, upper),
            "status": status, "action": action,
        })
    return rows


result = decide_with_abstention(
    effect=[4.0, 1.5, -3.5],
    se=[1.0, 1.0, 1.0],
    cost=[2.0, 1.0, 1.0],
)
print([(r["status"], r["action"]) for r in result])
# [('treat', 'treat'), ('abstain', 'no_treat'), ('no_treat', 'no_treat')]此处第一人的净增益为 ,区间 ;第二人为 ,区间 ;第三人为 ,区间 。代码输出两列:status 描述证据状态,action 是实际执行动作。生产日志应同时保存二者,否则事后无法区分“模型判断不干预”和“模型拒绝后回退为不干预”。
如果 是由两条结果模型预测得到,标准误不能随意把两边标准误相加:要考虑协方差,。更可靠的来源通常是按独立决策单位进行的交叉拟合或符合抽样设计的重抽样;同一用户多条记录要按用户聚类,门店随机化要按门店聚类。点对点区间也不等于对上线人群所有决策同时成立的区间。
05 把“拒绝”做成可观测的产品状态#
拒绝区只有连到明确的后续动作才有意义。建议为每次决策写入:decision_id、模型与特征快照版本、、成本版本、区间上下界、阈值、拒绝原因、基线策略版本、最终执行动作和人工覆盖结果。若成本、单位或结果定义改变,必须更新版本,不能复用旧阈值。
可解释的在线指标包括拒绝率、拒绝后各基线分支占比、按预先指定人群切片的拒绝率,以及拒绝与未拒绝人群的后续成熟结果。分母要同时报告合格决策数与标签成熟数,避免把未到观察窗的样本误算成失败。若拒绝率突然上升,应依次检查输入分布、标准误/区间宽度、成本配置、估计模型版本和标签水位;这与“策略突然不想干预”是不同故障。
以下情况尤其不能只靠这条规则:
- 估计区间未校准、训练数据有选择偏差或动作重叠不足。窄区间可能只是模型过度自信。
- 治疗会影响他人、资源拥堵或产生延迟反馈。逐人净增益不等于系统总收益,需显式考虑干扰与容量约束。
- 干预存在不可逆伤害或法规要求。此时行动门槛应按损害函数和治理要求制定,而不是随意选择 95%。
- 基线执行路径本身改变了人群后续数据。拒绝组并非随机对照,不能直接用其结果估计自动干预效果。
调试顺序:先验证 effect、se、cost 的单位和行对齐,再用手算边界断言 lower == 0 与 upper == 0 应进入拒绝区;接着检查拒绝状态是否保留在决策日志,最后按时间和人群查看拒绝率与结果成熟度。阈值比较使用明确的严格不等号,避免浮点边界在不同服务实现中改变动作。
06 与相近做法的区别#
点估计阈值直接按 执行动作,利用样本多,但在门槛附近对估计噪声敏感。拒绝决策将不确定性转成显式回退状态,可能降低自动覆盖率,也会增加人工量或基线执行成本。风险敏感策略可以进一步惩罚方差或最坏情形,但其目标函数与本篇简单区间门槛不同;双重稳健离线评估估计冻结策略的平均价值,不会自动生成单个样本的有效置信区间;保形预测区间提供另一类覆盖保证,仍需关注交换性条件、切片覆盖和分布变化。
因此,拒绝规则不是“给 CATE 加个标准误就安全”。它把估计不确定性转成一种策略行为,是否合理取决于估计器校准、决策单位、基线语义、损害成本和后续审计。
思考练习#
- 某干预成本从 1 个效用点上调到 2 个点,哪些样本会从“干预”进入“拒绝”或“不干预”?写出净增益区间的新阈值。
- 同一用户每周出现多次,按行 bootstrap 得到的区间可能为什么过窄?应当以什么单位重抽样?
- 拒绝后执行旧策略,而旧策略会改变后续观察到的人群与结果。你会在账本中增加哪些字段,才能区分回退效果与自动策略效果?
延伸阅读#
- Athey, S. & Imbens, G. (2016). Recursive partitioning for heterogeneous causal effects ↗. PNAS.
- Wager, S. & Athey, S. (2018). Estimation and inference of heterogeneous treatment effects using random forests ↗.
- Kitagawa, T. & Tetenov, A. (2018). Who should be treated? Empirical welfare maximization methods for treatment choice ↗. Econometrica.
- Zhao, Y. et al. (2012). Estimating individualized treatment rules using outcome weighted learning ↗. JASA.
下一篇可以把“拒绝后回退”的动作接到离线回放账本中,比较自动干预、旧基线与人工复核三条路径各自的成熟结果和容量代价。