平行趋势可能怎样弯?HonestDiD 的幅度、平滑度与方向约束
从事件研究系数和协方差出发,比较相对幅度、二阶差分平滑度与方向限制,理解稳健区间如何随假设变化。
上一篇把平行趋势从“成立或不成立”改写成一个敏感性问题:如果处理后的趋势偏差最多有多大,结论会不会改变?但“最多多大”还不够具体。偏差可以始终很小却忽然折弯,也可以平滑地逐步积累;它们对短期与长期效果的影响不同。
本篇只讲一个核心:**把处理后允许的趋势偏差写成可解释的形状集合,再计算所有允许偏差下都站得住的区间。**我们比较相对幅度(relative magnitudes)、二阶差分平滑度(smoothness)和方向限制(shape restrictions),并用作者维护的 R 包 HonestDiD 读取事件研究估计与协方差。它延续上一篇的趋势敏感性问题,下一篇将转向上线前的研究设计:怎样冻结结果口径、估计对象和决策规则,避免看到结果后才挑假设。
01 同样的预趋势,处理后可以怎样偏离?#
设处理组和对照组在事件时间 的未处理潜在结果差为 。若平行趋势精确成立, 不随时间改变;若不成立,变化部分会混进事件研究系数。令 表示这项未观测趋势偏差, 是估出的事件研究系数, 是真实处理效应。直观上,处理后有
因此要估计某个动态效果组合 ,就要问趋势偏差在同一组合上的影响 可以有多大。 是目标权重:看第一个处理后时期时只选该期;看两期平均时可取 。没有先写明目标,稳健区间就没有明确含义。
事件研究输入是一个系数向量 和协方差矩阵 : 个处理前系数在前、 个处理后系数在后,参考期通常被省略。协方差的行列顺序必须与系数完全一致。它应来自正确随机化/聚类层级下的估计,不能把系数标准误随手拼成彼此独立的对角阵用于正式分析。
flowchart LR
  A[事件研究系数 β 与协方差 Σ] --> B[冻结目标权重 ℓ]
  B --> C[选择可解释的偏差形状集合 Δ]
  C --> D[在所有 δ ∈ Δ 下求最坏偏差]
  A --> E[纳入抽样不确定性]
  D --> F[对每种限制与尺度计算稳健区间]
  E --> F
F --> G[报告何时跨过 0 与对应假设]图中的 是对可能偏差轨迹的约束,不是从样本“检验通过”的结论。敏感性分析回答“在这些偏差形状里,区间怎样变化”;它不能证明所选集合覆盖了真实偏差。
02 相对幅度和曲率,限制的是不同东西#
**相对幅度限制(relative-magnitude restriction)**把处理后的趋势变化与处理前观察到的最大变化相比。令 表示差异趋势,则一种直观写法是限制处理后相邻时期的变化:
是无量纲倍率。 表示允许处理后每期的趋势变化不超过处理前看到的最大一期变化; 则允许达到两倍。它不是“处理效应缩小到一半”,也不是显著性水平。若处理前最大变化非常接近零,这个尺度会很脆弱,必须把预趋势估计的不确定性和领域尺度一起考虑。
**平滑度限制(smoothness restriction)**约束趋势偏差的二阶差分,也就是斜率改变的幅度:
带有结果变量的量纲,并依赖时期单位:若结果是转化率百分点,事件时间以周计,那么二阶差分以“百分点/周变化”表达。小 允许近似线性延伸,大 允许更急的弯曲。它不是限制偏差水平恒定在 以内,因此不要把 误读成处理后结果的最大误差。
这两种假设各有侧重:相对幅度比较每期趋势变化和处理前的实测尺度;平滑度比较趋势斜率怎样弯折。若知道偏差方向,也可加符号限制;若合理假设偏差单调,可加入单调性限制。限制越多,集合越小、区间通常越窄,但结论也依赖更强的先验判断。
| 限制 | 对象 | 尺度 | 直觉问题 |
|---|---|---|---|
| 相对幅度 | 处理后每期趋势变化 | 无量纲倍率 | 能比最坏预趋势大几倍? |
| 平滑度 | 趋势偏差的二阶差分 | 结果单位/时期² | 斜率每期最多弯多少? |
| 方向/单调性 | 偏差符号或变化方向 | 方向假设 | 有领域证据支持只往一边走吗? |
03 手算:一个稳健区间怎样变宽?#
假设研究者关心两期平均效果,事件研究点估计为 ,平均估计是 。在“完全平行”下,常规 95% 区间假设为 。若一个极简教学情境把选定的偏差集合投影到这个平均目标后,得到 ,那么最坏偏差会把区间两端向外推:
点估计仍是 ,变化的是允许的反事实范围。此处把偏差投影当成已知区间,并用区间相加演示几何直觉;它不是 HonestDiD 的数值输出。正式算法同时使用整个系数向量、协方差、目标权重与限制集合,计算对所有允许偏差有效的置信集合。
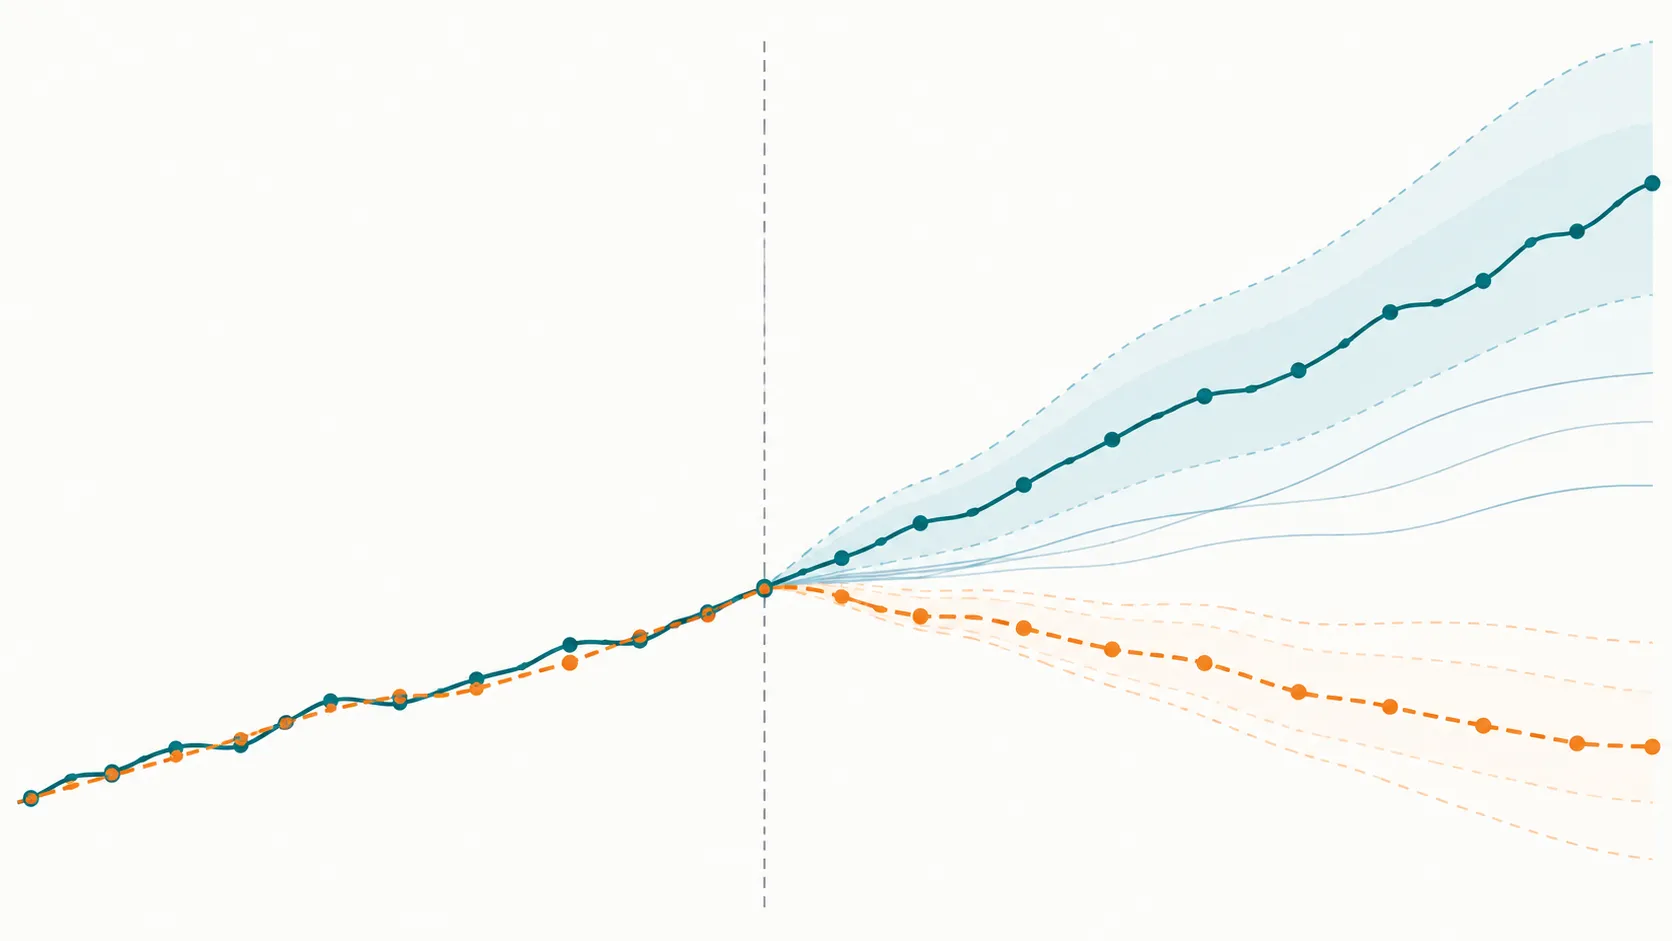
想象图中竖线是处理时点:相对幅度限制每期允许的差异趋势变化相对预趋势最大变化有多大;平滑度限制反事实曲线能以多快的速度转弯。若长期效果权重更偏向远期,累积趋势偏差通常更重要;所以报告一个“稳健/不稳健”标签会丢失关键上下文,最好画出区间随 或 变化的曲线。
04 用 HonestDiD:把目标、顺序和协方差对齐#
作者维护的 R 包提供 constructOriginalCS()、createSensitivityResults() 和 createSensitivityResults_relativeMagnitudes()。下面用人为构造的系数和对角协方差说明 API 的数据契约;它只供检查形状与参数流,不能替代真实回归、聚类协方差或结果复核。正式使用应传入事件研究模型导出的完整协方差矩阵。
library(HonestDiD)

# 顺序:处理前 -3、-2;处理后 0、1;参考期 -1 已省略
betahat <- c(-0.12, 0.08, 0.55, 0.72)   # shape: [K + P] = [4]
sigma <- diag(c(0.08, 0.07, 0.09, 0.10)^2) # shape: [4, 4],仅演示
numPrePeriods <- 2
numPostPeriods <- 2
ell <- c(0.5, 0.5)                       # 对两个处理后时期取平均,[P]

original <- HonestDiD::constructOriginalCS(
  betahat = betahat, sigma = sigma,
  numPrePeriods = numPrePeriods,
  numPostPeriods = numPostPeriods,
  l_vec = ell
)

smooth <- HonestDiD::createSensitivityResults(
  betahat = betahat, sigma = sigma,
  numPrePeriods = numPrePeriods,
  numPostPeriods = numPostPeriods,
  l_vec = ell,
  Mvec = seq(0, 0.20, length.out = 9)
)

relative <- HonestDiD::createSensitivityResults_relativeMagnitudes(
  betahat = betahat, sigma = sigma,
  numPrePeriods = numPrePeriods,
  numPostPeriods = numPostPeriods,
  l_vec = ell,
  Mbarvec = seq(0, 2, by = 0.25)
)

head(smooth)    # 每个 M 对应稳健区间与方法信息
head(relative) # 每个 Mbar 对应稳健区间与方法信息betahat 和 sigma 分别是估计量与估计误差结构;numPrePeriods、numPostPeriods 告诉函数如何拆分事件期;l_vec 指定要推断的处理后线性组合。输出表含区间端点等列,逐个敏感度值报告。若只用默认 l_vec,函数通常针对第一个处理后效果,而不是自动给出长期平均效果。
createSensitivityResults() 对应平滑度家族,可传 Mvec;还可通过 monotonicityDirection 或 biasDirection 加方向限制。相对幅度家族用 createSensitivityResults_relativeMagnitudes() 与 Mbarvec。不要把 Mvec 与 Mbarvec 当成同一横轴:前者有结果量纲,后者是倍率。包也提供 createSensitivityPlot() 和 createSensitivityPlot_relativeMagnitudes();绘图是区间的展示层,不能代替确认系数顺序或推断层级。
下面是分析控制流的伪代码:
freeze outcome, event-time reference, target weights ell, and cluster level
fit event-study model -> betahat[K+P], sigma[(K+P) × (K+P)]
check coefficient order, omitted reference, pre/post counts, and covariance
for each justified bound M or Mbar:
    define allowed trend-bias set Delta(bound)
    optimize ell' * delta over delta in Delta(bound)
    combine worst-case bias with sampling uncertainty using HonestDiD
plot lower/upper endpoints against the bound
report first bound where interval includes zero, if such crossing occurs关键检查点不是函数有没有返回对象,而是输入含义是否一致:事件时间是否等间隔、基准期是否被省略、预趋势和处理后系数是否完整、 是否按聚类/随机化层级计算、 是否对应预先声明的 estimand(估计目标)。若协方差顺序错一位,代码仍可能运行,区间却针对错误的系数线性组合。
05 怎么读敏感性曲线,哪些结论容易过头?#
- 看首次跨零位置,而不挑最好看的单个点。 在预先说明的 或 范围内,记录区间什么时候包含零;“breakdown value”(结论失效界值)是描述敏感程度,不是另一个 值。
- 把限制尺度翻译回业务单位。 解释允许的预趋势偏离相当于每周多少百分点、或预趋势最大变化的几倍;不要只报告软件默认网格。
- 核对事件研究估计量。 若有错时处理且效果异质,直接对传统双向固定效应系数做敏感性分析,不会自动修复错误对照;先像上一篇那样定义可信的组别—时间估计量,再确定事件时间汇总目标。
- 重跑合理的结果口径和窗口。 埋点改变、处理前时期太少、对照组受溢出影响,都不是扩大 可以修复的问题。趋势限制只处理某一类未观测偏差。
- 保留区间与设计证据。 低功效预趋势检验没有拒绝差异,不等于平行趋势已证实;稳健区间对限制集合有效,也不证明真实偏差一定落在该集合里。
键盘可展开:汇报前的敏感性分析清单
按 Tab 聚焦摘要,再按 Enter 或 Space 展开。核对结果定义和单位;确认事件期参考值与系数顺序;列明估计量、协方差聚类层级和目标权重;分别说明 M 与 Mbar 的业务解释及扫描范围;报告原始区间、稳健区间和首次跨零位置;保存供体/样本窗口变化与代码版本。
| 方法 | 主要解决什么 | 它不能代替什么 |
|---|---|---|
| 处理前趋势图/检验 | 展示观测到的预趋势与有限样本证据 | 不能证明未观测的处理后平行趋势 |
| HonestDiD 敏感性界限 | 在声明的偏差集合下做稳健推断 | 不能替研究者选择可信的偏差尺度 |
| 合成控制安慰剂 | 比较供体池中的拟合与处理后差距 | 不能自动给出任意平行趋势偏离下的稳健区间 |
| 聚类稳健标准误 | 处理所选估计量的组内相关抽样误差 | 不能控制未观测混杂或错误 estimand |
思考练习#
- 两期平均的完全平行区间为 ,允许目标偏差范围为 。教学区间会变成什么?何时会包含零?
- 结果以百分点记录、事件时间以月记录。 的平滑度限制如何解释?改成周为单位后,能否不换算就沿用同一个数?
- 一个事件研究有 3 个处理前系数、5 个处理后系数,省略期不是 。调用 HonestDiD 前要如何确认
betahat、sigma、numPrePeriods和l_vec的顺序?
延伸阅读#
- Rambachan & Roth, A More Credible Approach to Parallel Trends (Review of Economic Studies, 2023) ↗ — 相对幅度、平滑度及稳健推断的原始论文。
- HonestDiD 作者维护的 R 包与示例 ↗ — 当前函数签名、限制类型和工作流。
- HonestDiD CRAN 参考手册 ↗ — API 参数和返回值文档。
- Roth, Pretest with Caution: Event-Study Estimates after Testing for Parallel Trends (AER: Insights, 2022) ↗ — 预趋势预检对推断的影响。
上一篇把平行趋势转成偏差大小的敏感性分析;本篇进一步说明“大小”依赖偏差的形状与单位。下一篇将从模型假设回到实验准备:在看结果前冻结指标、目标权重和继续/停止规则,让后续推断可以审计。