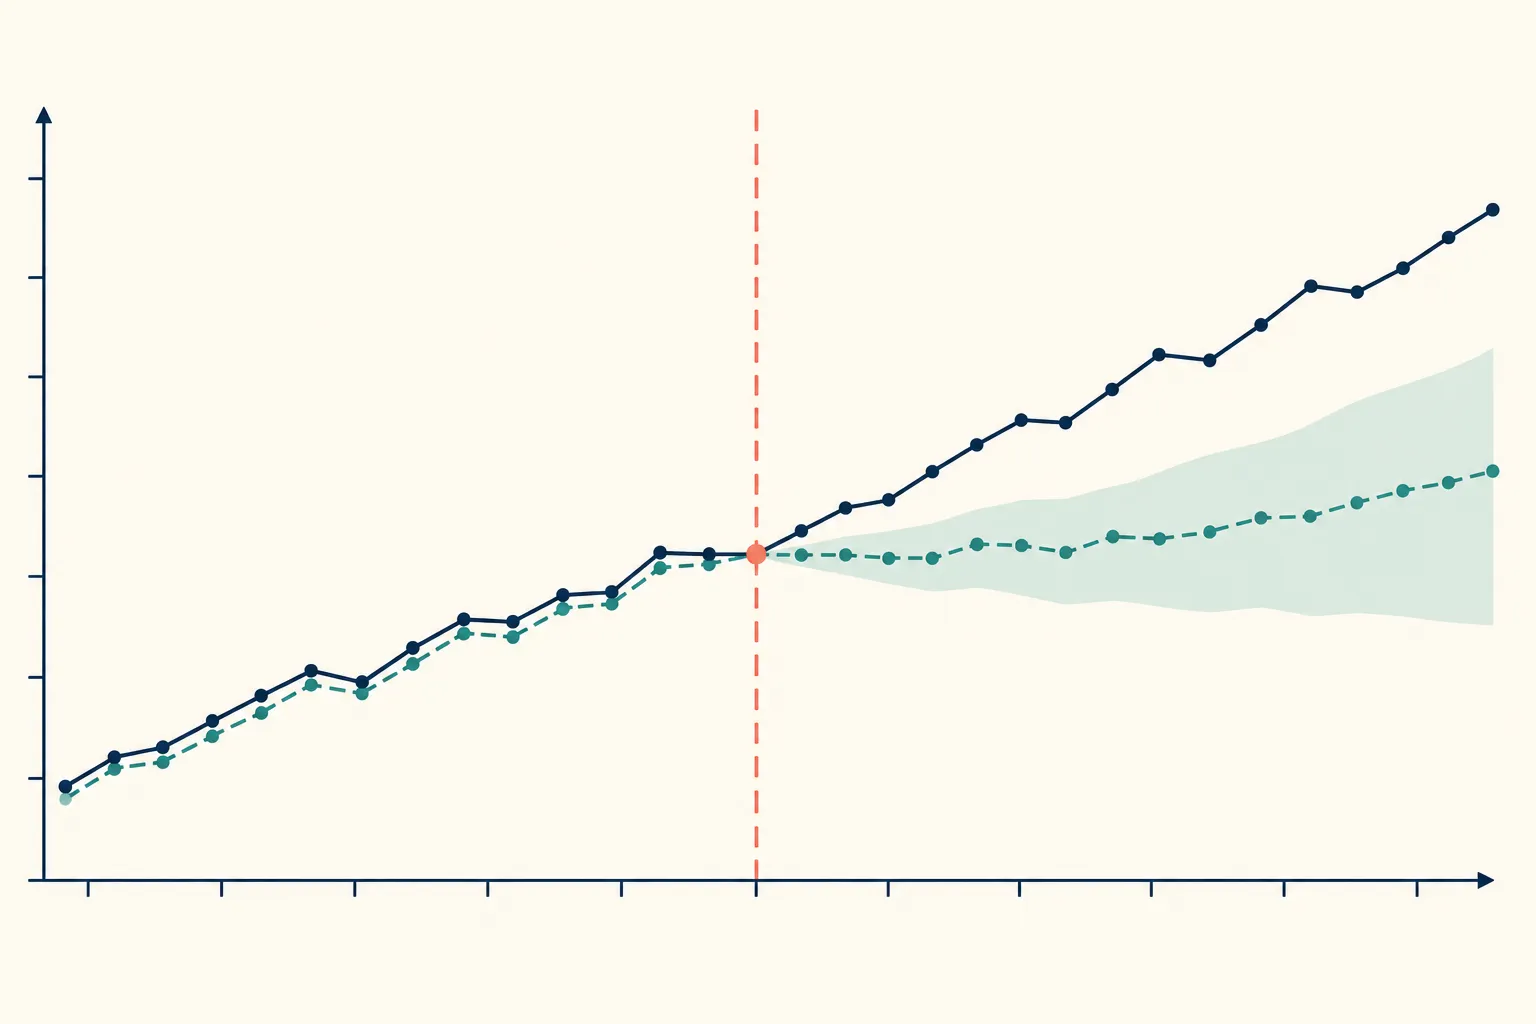
平行趋势略有偏离,DiD 结论还能站得住吗?敏感性界限与 HonestDiD
平行趋势不能靠“不显著”证明。把处理后的未观测趋势偏差限制在可解释的范围内,再观察效应区间何时跨过零。
上一篇按上线批次分别估计组别—时间处理效应,避免把已经处理的城市当对照;但这些比较仍要假设处理组与对照组的未处理趋势平行。现实里,推荐模型可能恰好在处理组所在城市改善网络,也可能有地区促销。处理前趋势看起来接近,并不能证明上线后的反事实趋势会继续接近。
本篇只讲一个问题:**如果平行趋势允许偏离到某个有实际含义的程度,处理效应区间会变成什么?**我们把未观测的趋势偏差限制在由处理前数据校准的集合中,再对所有允许偏差计算区间。下一篇可以继续看多种偏差形状限制,以及如何将敏感性分析用于分批处理的动态效应。
01 “处理前没显著差异”为什么不够?#
差分中的差分(Difference-in-Differences,DiD)把处理组与对照组的结果变化相减。要把这个差异解释成因果效应,需要未处理潜在结果的趋势平行。这个条件涉及处理后的反事实,而处理后处理组的未处理结果恰好观察不到。
对处理前事件时间系数做联合检验,只能检查有限样本下是否能拒绝某些处理前差异。样本少时检验可能没有足够统计功效;即使没有拒绝,也不等于偏差为零。若先看检验结果,再决定是否报告 DiD,常规置信区间还会忽略这种预检选择。
因此,敏感性分析不问“平行趋势是否被证明”,而问:“如果趋势偏差最多达到一个预先解释的量,结论还保持什么?”分析结果是对假设的敏感程度,不会凭空恢复处理后的反事实。
flowchart LR
  A[估计事件研究系数与协方差矩阵] --> B[选择趋势偏差限制]
  B --> C[用处理前趋势校准偏差尺度]
  C --> D[扫描敏感度 M]
  D --> E[对允许的反事实偏差求最坏区间]
  E --> F{区间是否仍排除 0?}
  F -->|是| G[在该偏差限制下仍稳健]
F -->|否| H[结论依赖更强的平行趋势假设]这条数据流有两个输入:事件研究点估计向量和它的协方差矩阵;另一个关键输入是研究者给出的偏差限制。后者不是软件自动从数据里学出的参数,必须用领域知识、处理前变化尺度或政策背景说明。
02 用趋势偏差集合替代“精确平行”#
考虑一个处理组和一个对照组。令 表示时期 两组未处理潜在结果差距相对基准期的变化。精确平行趋势把所有处理后 设为 0;敏感性分析允许其非零,但要求它属于一个限制集合 。
在单个处理后时期,观测到的 DiD 估计可写成:
这里 是目标处理效应, 是趋势偏离造成的偏差。若用最简单的对称界 ,点估计对应的部分识别区间是 。若原始 置信区间为 ,一个直观的外扩区间为 。
**这只是解释偏差如何扩展区间的教学近似。**正式方法还要把预趋势估计的不确定性、事件研究系数之间的协方差,以及多期约束一起纳入稳健推断。不能拿这个外扩公式替代 HonestDiD 的正式稳健置信区间。
在多期事件研究中,将系数按“处理前、处理后”拼成 ,对应协方差矩阵 。参考期通常省略,参数 是所关心的单期效应或加权动态平均。 的长度等于处理后系数个数; 选第一个处理后时期,等权平均则各分量为 。
| 符号 | 含义 | 维度 / 取值 |
|---|---|---|
| 事件研究中未省略的处理前与处理后系数 | 维向量 | |
| 这些系数的联合协方差 | 矩阵 | |
| 处理组相对对照组的未处理趋势偏差 | 随事件时间变化的向量 | |
| 偏差限制的敏感度刻度 | ;越大,允许的偏离越强 | |
| 目标动态效应的线性权重 | 维向量 | |
| 在限制强度 下与数据相容的目标效应范围 | 一维区间 |
03 两类限制:幅度与曲率#
Rambachan 与 Roth 的框架提供多种偏差集合。两个常见选择是:
- 相对幅度限制(Relative Magnitudes):假设处理后的趋势偏差不会远大于处理前观测到的最大偏差。令 为相邻时期趋势差距的变化,一种直觉化写法是 ,其中 是处理后时期。 表示允许的处理后变化不超过处理前最明显的相邻变化; 则允许达到两倍。正式实现会使用对应的系数限制矩阵与联合不确定性,而不是逐个点代入这个标量式。
- 平滑度限制(Smoothness):假设处理后的趋势差距相对处理前线性外推的弯曲幅度有限。 是严格线性延伸;更大的 允许斜率在相邻期之间改变得更多。它适合“趋势可能延续但不应突然急转弯”的领域判断。
两者编码不同的实质性假设,不能看完哪种区间更窄就挑哪种。 也没有通用默认值:先检查处理前系数的量纲、相邻变化和置信区间,再说明为什么某个范围的处理后偏离可信。可以报告一系列 ,让读者看到结论在哪个点失去稳健性。
输入:事件研究系数 beta_hat、协方差 Sigma、偏差限制类型、敏感度网格 M
为每个 M:
    构造允许的未处理趋势偏差集合 Delta(M)
    联合使用 beta_hat 与 Sigma,求目标效应的最坏下界和上界
    记录区间是否覆盖 0,以及是否仍保持预设方向
输出:M -> robust confidence interval 的敏感性曲线处理前“看起来平”不能自动把 设成 0:点估计接近 0 可能只是区间很宽。预趋势的统计不确定性应由 带入正式推断;相对幅度限制还需要说明比较的是水平偏差还是相邻变化,避免把两种尺度混为一谈。
04 手算一个区间何时跨过零#
假设某个上线后时期的估计效果是 ,标准误为 。常规正态近似 95% 区间为 。处理前相邻趋势差距的最大变化约为每期 个点击百分点。作为简化演示,设目标时期有两次趋势变化,且每次绝对值不超过 ,那么累计偏差界是 。
| 偏差界 | 简化外扩区间 | 是否排除 0 | |
|---|---|---|---|
| 0 | 0 | [4.04, 7.96] | 是 |
| 2 | 2 | [2.04, 9.96] | 是 |
| 4 | 4 | [0.04, 11.96] | 勉强是 |
| 4.1 | 4.1 | [-0.06, 12.06] | 否 |
这个算例告诉我们:结论在允许的偏差扩大到约 时触及零。它不是某篇实证研究的正式稳健区间,也没有利用多期协方差;它只展示敏感度参数如何改变结论。正式 breakdown value(结论失效临界值)应从正式稳健区间的上下界求得。
05 先用标准 Python 看懂简化外扩#
下面的函数只实现上一节的教学近似:输入单期估计、标准误、处理前相邻变化幅度、处理后步数和 ,返回外扩后的区间。它没有优化趋势偏差向量,也没有同时校正预趋势估计误差,因此不能用于正式论文推断。
from math import isfinite


def illustrative_interval(theta_hat, se, max_pre_change, post_steps, M,
                          z=1.96):
    """教学用最坏偏差包络,不是正式 HonestDiD 推断。"""
    values = (theta_hat, se, max_pre_change, M, z)
    if not all(isfinite(x) for x in values):
        raise ValueError("inputs must be finite")
    if se < 0 or max_pre_change < 0 or M < 0 or post_steps < 1 or z <= 0:
        raise ValueError("scales must be non-negative and post_steps >= 1")

    sampling_radius = z * se
    bias_radius = post_steps * M * max_pre_change
    radius = sampling_radius + bias_radius
    return theta_hat - radius, theta_hat + radius


ci = illustrative_interval(
    theta_hat=6.0, se=1.0, max_pre_change=0.5, post_steps=2, M=4.1
)
print(tuple(round(x, 2) for x in ci)) # (-0.06, 12.06)这里所有输入都是标量,输出也只有两个端点。post_steps 是偏差可以累积的处理后间隔数,不是样本数。把它误填成城市数,会把偏差单位放大到错误尺度。检查任何实现时,可先取 ,确认结果退化为常规区间;再逐渐加大 ,对称的简化区间只能变宽,不能变窄。
06 正式推断:事件研究结果与 HonestDiD#
正式分析先得到一致的事件研究系数及其协方差矩阵。以下 R 调用采用作者维护的 HonestDiD 包的相对幅度接口。betahat 与 sigma 必须只含事件研究系数及对应协方差;若结果里还有控制变量系数,要在调用前同步筛掉矩阵中相应的行列。
# betahat: K 维事件研究系数;sigma: K x K 协方差矩阵
# 此例设 4 个处理前系数、3 个处理后系数;参考期已省略。
result <- HonestDiD::createSensitivityResults_relativeMagnitudes(
  betahat = betahat,
  sigma = sigma,
  numPrePeriods = 4,
  numPostPeriods = 3,
  Mbarvec = seq(0, 2, by = 0.25),
  l_vec = c(1, 0, 0)
)

original <- HonestDiD::constructOriginalCS(
  betahat = betahat,
  sigma = sigma,
  numPrePeriods = 4,
  numPostPeriods = 3,
  l_vec = c(1, 0, 0)
)
HonestDiD::createSensitivityPlot_relativeMagnitudes(result, original)numPrePeriods 与 numPostPeriods 说明事件研究向量中两类系数的排列长度;Mbarvec 是要扫描的相对幅度网格;l_vec 定义关心哪个动态效应。输出包含不同 下的下界、上界与方法信息,图上可直接读区间何时跨过 0。若要约束趋势弯曲,官方接口 HonestDiD::createSensitivityResults(...) 使用 Mvec,并要求先明确其 smoothness 版本的尺度解释。实际使用时应对照包文档核对所用设计与选项。
该接口针对的是给定事件研究估计量的敏感性分析。分批上线时,不能把含异质处理效应且比较组混杂的传统 TWFE 动态系数直接送进去,就以为稳健性问题解决了。先按上一篇的组别—时间 ATT 路线,选择适当动态汇总估计量和推断,再确认该方法的偏差集合适用于目标参数。包的 README 也列有 did 事件研究的适配示例和 universal base period 要求。
07 调试、失败场景与方法边界#
| 检查 | 常见错误 | 调试方法 |
|---|---|---|
| 系数顺序 | 处理前后时期顺序或遗漏基准期弄错 | 打印事件时间、系数名与 numPrePeriods / numPostPeriods 对照 |
| 协方差矩阵 | 使用了完整回归矩阵,却只传入事件研究系数 | 保持系数向量与协方差矩阵同顺序、同维度;检查对称性和对角线 |
| 目标参数 | l_vec 误选单期或平均处理效应 | 手算 ,确认长度与权重和 |
| 的含义 | 把“倍数”写成没有单位的任意调参 | 报告处理前变化尺度、限制类型与完整 网格 |
| 预趋势 | 不显著就把限制设为 | 联合报告点估计与不确定性;做功效和替代 分析 |
| 分批上线 | 把 TWFE 事件系数当成无异质性偏差的输入 | 先估适用于目标 estimand 的动态效应,再做敏感性分析 |
该方法仍依赖研究者选定的偏差集合。若上线同时发生处理组专属埋点改版、用户构成断裂或跨组溢出,单靠“趋势偏差不超过某个倍数”未必覆盖这些结构变化。处理前时期很少或很嘈杂时,校准的最大偏差本身也不稳定;可报告替代窗口、领域量级或外部对照尺度,而不能把噪声峰值当作确定边界。
敏感性区间越宽不代表原研究“错误”,而是说明在更弱的平行趋势限制下,数据无法排除更多因果效应。反过来,区间窄也只表示在所写明的限制集合下稳健。它与安慰剂检验、预趋势图、合成控制是互补证据,不会自动修复处理选择偏差、负权重或错误的目标效应。
键盘可展开:报告敏感性分析前的核对清单
按 Tab 聚焦摘要,再按 Enter 或 Space 展开。写明估计量、事件时间基准、系数与协方差的维度、偏差限制类型、M 的单位解释、M 网格、目标线性组合,以及区间首次包含零的位置。把常规区间与稳健区间分开标注。
思考练习#
- 若常规区间为 ,并允许处理后偏差 ,教学用外扩区间是多少?若偏差允许为 4,结论发生什么变化?
- 处理前相邻趋势变化最大值估计为 0.2,但置信区间很宽。直接用 0.2 校准 有何隐患?还可以用哪些预先说明的尺度做敏感性分析?
- 为什么在错时上线且处理效应异质时,先解决事件研究估计量和目标效应定义,再做趋势敏感性分析?
延伸阅读#
- Rambachan & Roth, A More Credible Approach to Parallel Trends (Review of Economic Studies, 2023) ↗ — 相对幅度、平滑度限制与稳健推断的原始论文。
- Roth, Pretest with Caution: Event-Study Estimates after Testing for Parallel Trends (AER: Insights, 2022) ↗ — 预趋势检验功效不足与预检对估计推断的影响。
- Bilinski & Hatfield, Nothing to See Here? A Non-Inferiority Approach to Parallel Trends (Statistics in Medicine, 2026) ↗ — 用非劣效思路表达可接受的趋势偏离。
- HonestDiD 作者维护的 R 包与示例 ↗ — 当前函数参数、输入结构及分批处理示例。
本篇把平行趋势从“成立/不成立”的二元判断改写成对偏差集合的敏感性问题:结论在什么程度的违背下仍成立?下一课沿着多期事件研究继续扩展,比较幅度、平滑度与更一般的约束如何改变动态效果的稳健区间。