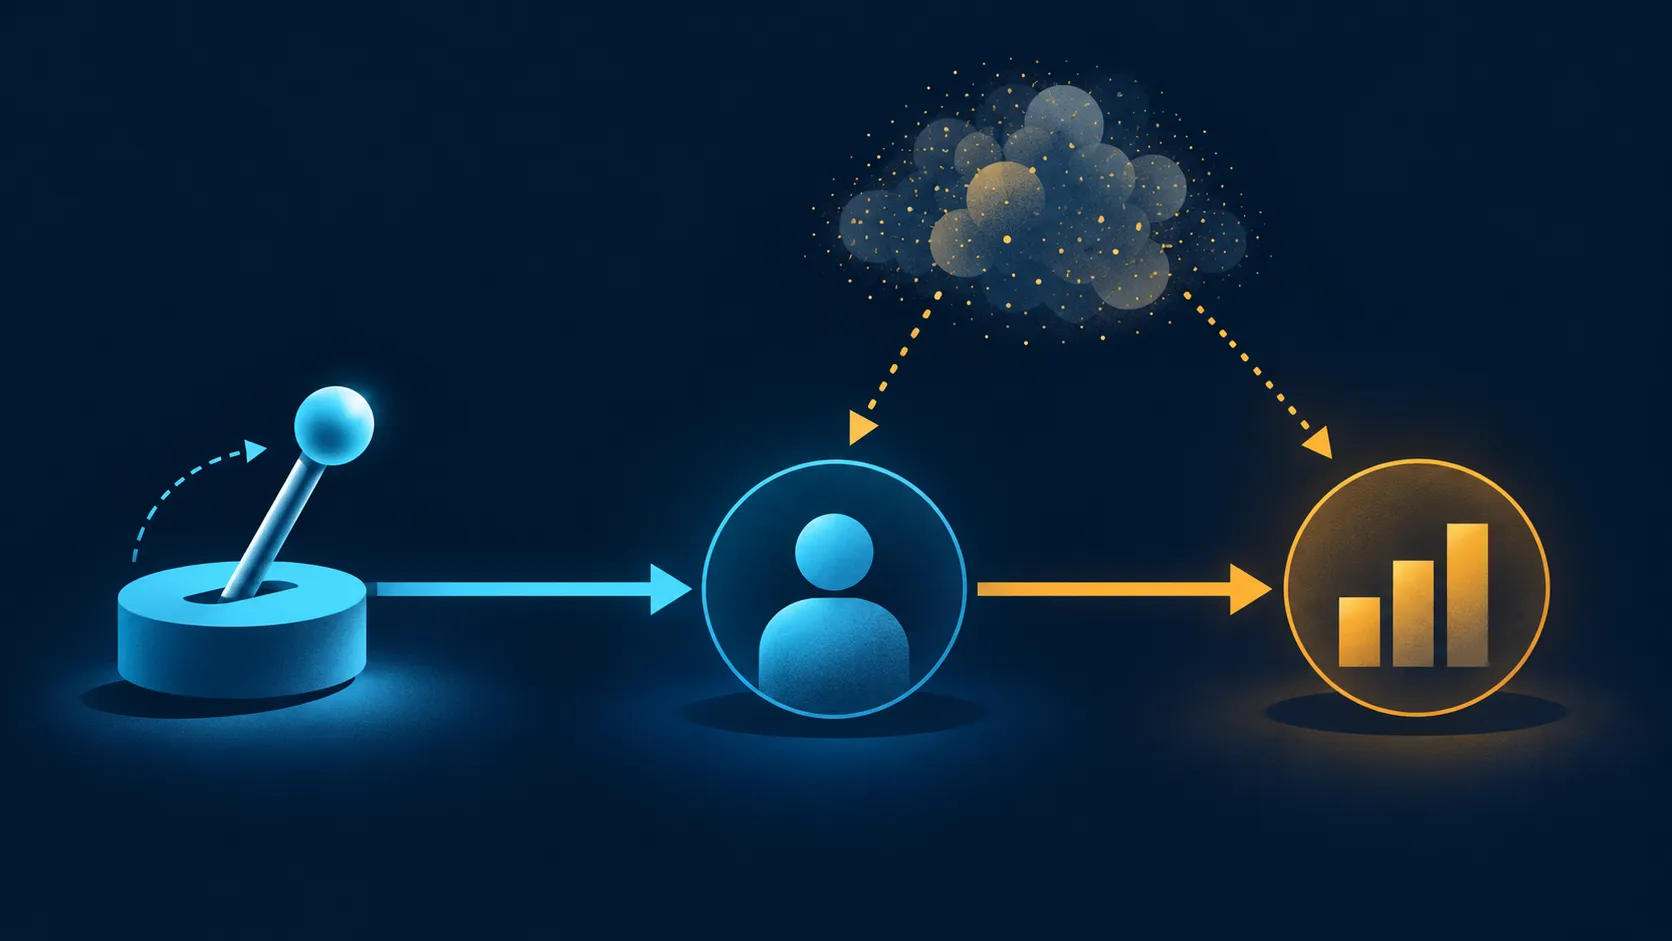
鼓励会改变治疗选择,却不直接改变结果:工具变量的 Wald 比率与 LATE
从鼓励设计推导工具变量 Wald 比率,手算第一阶段与约化式,并用纯 Python 检查 LATE 的识别假设和弱工具变量。
上一篇用 E-value 问“未测混杂要多强,才足以解释观察到的关联”。但敏感性分析不会替我们消除混杂。本篇换一个识别思路:找一个会推动治疗选择、却不直接改变结果的外生鼓励,比较鼓励两组的治疗率与结果差异。
**工具变量(instrumental variable, IV)**记作 (Z),治疗记作 (D),结果记作 (Y)。核心是 Wald 比率:鼓励对结果的影响,除以鼓励对治疗的影响。它通常识别的是会被鼓励改变选择的服从者效果,而不是所有人的平均治疗效果。下一篇转向另一种准实验:当治疗由一个阈值决定时,比较阈值附近的单位。
flowchart LR
  Z[随机鼓励 Z] -->|推动但不强迫| D[实际治疗 D]
  D --> Y[结果 Y]
  U[未测共同原因 U] --> D
  U --> Y
Z -. 排除限制:不能有直接路径 .-> Y数据流伪代码:
输入每个单位的鼓励 Z、实际治疗 D、结果 Y
计算第一阶段 FS = E[D|Z=1] - E[D|Z=0]
计算约化式 RF = E[Y|Z=1] - E[Y|Z=0]
若 FS 接近 0:标记弱工具变量,Wald 比率不稳定
否则输出 RF / FS,并连同假设、方向和不确定性报告01 为什么不能直接比较接受治疗的人?#
想估计培训 (D) 对工资 (Y) 的因果效果。主动报名者可能更有动力;动力 (U) 同时影响报名和工资。于是 (E[Y|D=1]-E[Y|D=0]) 混合了培训效果与人群差异。回归调整只能处理测得且正确建模的混杂。
假设我们随机发送一封培训邀请 (Z)。邀请会提高参加率,却不保证每个人参加。因为邀请随机,(Z) 与潜在结果的基线因素独立;但邀请影响结果只能通过实际参加 (D)。这让 (Z) 成为候选工具变量。
四个常见条件要逐一写清:
- 相关性(relevance):鼓励确实改变治疗概率,(E[D|Z=1]\ne E[D|Z=0])。
- 独立性(independence):鼓励近似随机,或在给定协变量 (X) 后独立于潜在治疗与结果。
- 排除限制(exclusion restriction):鼓励对 (Y) 没有不经过 (D) 的直接作用。若邀请本身提供信息、资源或压力,这条可能失败。
- 单调性(monotonicity):没有因收到鼓励反而不参加、但不收到就参加的“反向服从者”。这把比率解释成服从者的局部平均效应。
02 Wald 比率从哪里来?#
把潜在结果写成 (Y_i(d)),潜在治疗写成 (D_i(z))。先看鼓励对结果的平均影响:
再看鼓励对治疗的平均影响:
工具变量估计量为
(RF) 的单位是结果单位,(FS) 是治疗概率差,所以比率仍是“接受治疗”对应的结果单位。在二元鼓励、二元治疗以及上述条件成立时,该比率识别 服从者平均因果效应(local average treatment effect, LATE):会因鼓励而改变治疗状态的那群人,其平均治疗效果。
它不自动等于总体平均处理效应(average treatment effect, ATE)。若不同人群治疗效果不同,IV 以谁会响应该工具为权重;换一个工具,目标人群也可能换掉。
03 手算:结果增加 3,参加率增加 0.4#
把 100 人按随机邀请 (Z) 分成两组。表中的结果是组均值,治疗人数是参加培训人数:
| 鼓励 (Z) | 人数 | 治疗人数 | 治疗率 (E[D|Z]) | 平均工资增量 (E[Y|Z]) | |---|---:|---:|---:|---:| | 0 | 50 | 10 | 0.20 | 10 | | 1 | 50 | 30 | 0.60 | 13 |
第一阶段 (FS=0.60-0.20=0.40),约化式 (RF=13-10=3)。Wald 比率 (3/0.40=7.5):在假设成立时,服从者参加培训带来的平均工资增量为 7.5 个单位。
如果误把 (3) 当成治疗效果,就把未参加培训的人也算进鼓励组,估计的是“邀请”的 ITT 效果,而不是“参加培训”的 LATE。
04 可运行的纯 Python:明确分母和单位#
函数接收鼓励两组各自的样本数、治疗人数、结果总和,返回两组均值、第一阶段、约化式与比率。它不调用黑盒拟合,也不声称能从数据验证排除限制或单调性。
def wald_from_counts(n0, treated0, outcome_sum0,
                    n1, treated1, outcome_sum1):
    if min(n0, n1) <= 0:
        raise ValueError("每个鼓励组都必须有样本")
    if not (0 <= treated0 <= n0 and 0 <= treated1 <= n1):
        raise ValueError("治疗人数必须位于 [0, n]")
    d0, d1 = treated0 / n0, treated1 / n1
    y0, y1 = outcome_sum0 / n0, outcome_sum1 / n1
    first_stage = d1 - d0
    reduced_form = y1 - y0
    if abs(first_stage) < 1e-12:
        raise ValueError("第一阶段为零,Wald 比率未定义")
    return {
        "treatment_rate_z0": d0,
        "treatment_rate_z1": d1,
        "outcome_mean_z0": y0,
        "outcome_mean_z1": y1,
        "first_stage": first_stage,
        "reduced_form_ITT": reduced_form,
        "wald_LATE": reduced_form / first_stage,
    }

result = wald_from_counts(50, 10, 500, 50, 30, 650)
print(result)
# first_stage=0.4, reduced_form_ITT=3.0, wald_LATE=7.5真实个体数据中,先按随机分配 (Z) 分组,再计算组均值;不能按实际治疗 (D) 分组来构造分子。加入协变量时,要让约化式和第一阶段使用相同的样本、协变量和权重。多工具、多内生处理或多期处理的 2SLS 需要更完整的矩阵估计与稳健标准误;不能把“先拟合 D,再把预测值塞进普通回归”的标准误当作有效推断。
05 弱工具变量、排除限制与调试#
当第一阶段很小,分子中一点抽样噪声除以小分母就会变成很大的比率。调试至少同时报告:两组治疗率、第一阶段点估计和区间、约化式、Wald 比率及其区间。弱工具下,常规大样本近似区间会失真;应使用针对弱工具稳健的区间或随机化推断,并明确设计依据。
排除限制无法只靠“工具变量和结果相关”证明。画因果图、列出鼓励可能改变结果的其他路径,审计分配机制与实施日志。若 (Z) 不是随机的,独立性也要依赖可辩护的设计或条件调整。E-value 可量化未测混杂强度,但不能替 IV 的排除限制背书;负向对照是诊断,不是证明。
| 方法 | 处理选择的来源 | 主要识别对象 | 最容易被忽略的代价 |
|---|---|---|---|
| 直接观察比较 | 实际接受治疗 | 调整后关联或在强假设下的 ATE | 未测混杂 |
| 工具变量 | 外生鼓励推动治疗 | 通常为 LATE | 排除限制、弱第一阶段 |
| 鼓励试验 ITT | 随机分配鼓励 | 分配鼓励的平均效果 | 不是治疗本身的效果 |
思考练习
- 若 (FS=0.05)、(RF=1),Wald 比率仍是 20。为什么“数字算得出来”不代表这个估计稳定?
- 如果培训邀请同时赠送了交通补贴,因果图中多出哪条路径?它威胁哪项假设?
- 一个工具识别的 LATE 与另一个工具的 LATE 相差很大,能否据此断言至少一个估计错了?
相关工作与原文
- Imbens & Angrist (1994), Identification and Estimation of Local Average Treatment Effects ↗
- Angrist, Imbens & Rubin (1996), Identification of Causal Effects Using Instrumental Variables ↗
- Staiger & Stock (1997), Instrumental Variables Regression with Weak Instruments ↗
- Angrist & Krueger (1991), Does Compulsory School Attendance Affect Schooling and Earnings? ↗