阈值附近的人几乎可比:回归断点设计怎样估计局部因果效应?
从资格分数阈值推导回归断点设计,手算断点跳跃并用纯 Python 拟合两侧局部线性趋势,检查带宽、操纵和模糊断点。
上一篇用外生鼓励工具变量识别会因鼓励改变选择的人群效果。本篇看另一种机制:若资格由考试分数是否跨过门槛决定,门槛两边的人可能在其他方面相似,但治疗概率突然变化。我们比较断点左右的结果极限,而不是把整个处理组和对照组直接比较。
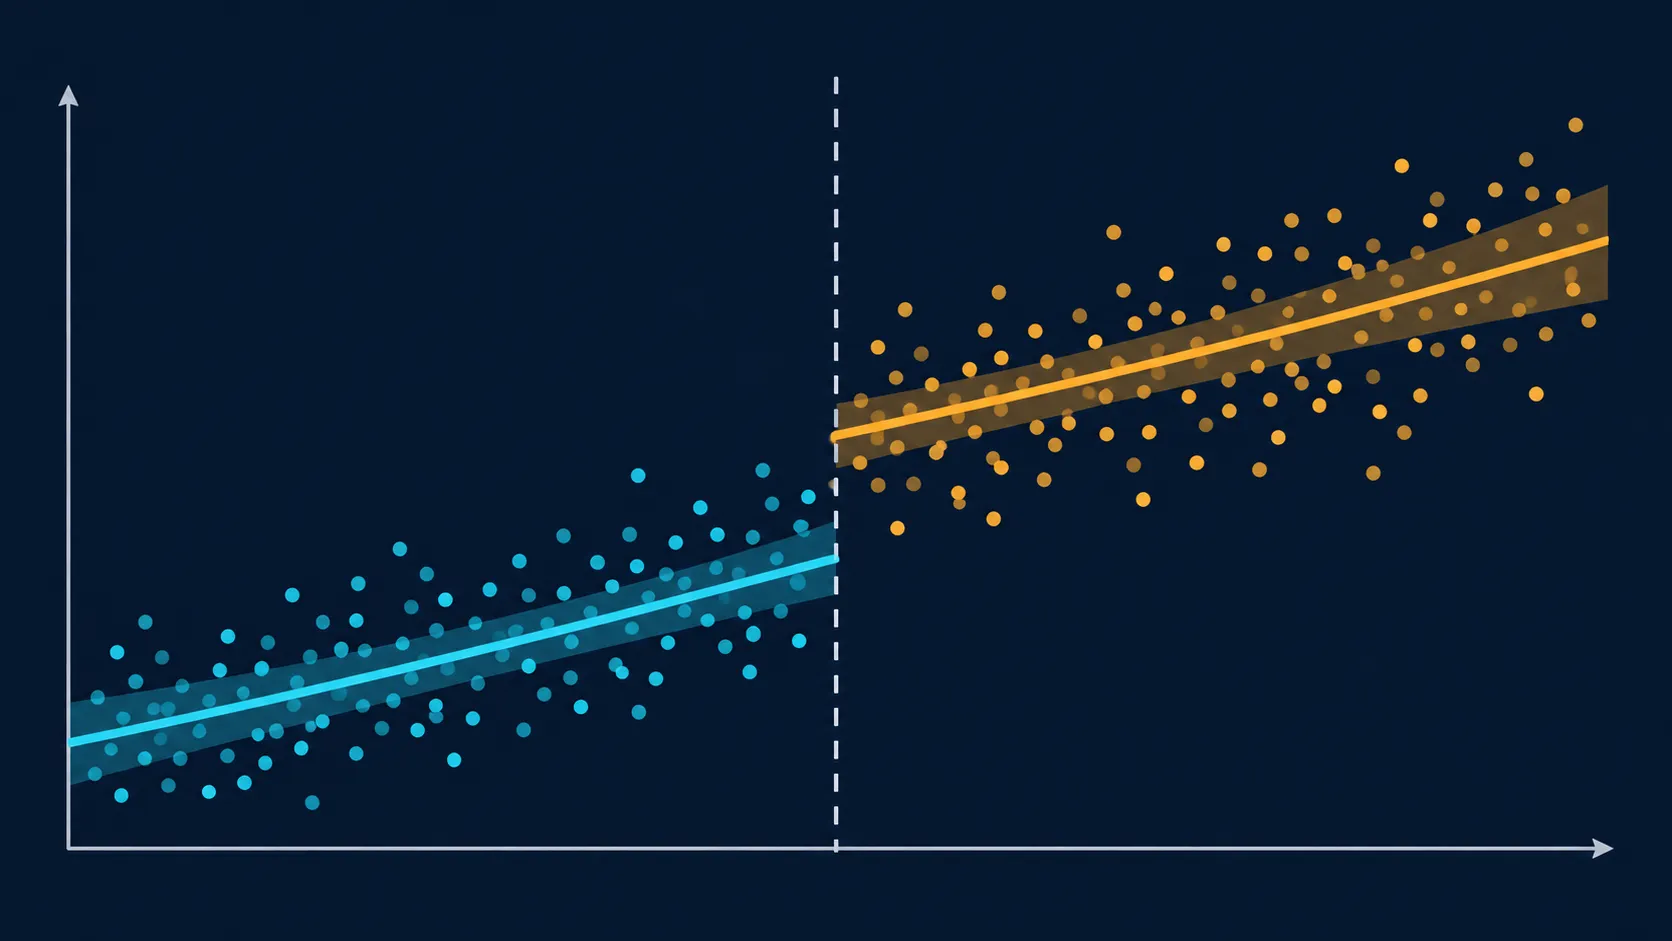
**回归断点设计(regression discontinuity design, RDD)**的核心不是“在阈值处做一条回归线”,而是:在断点附近,除治疗分配外,潜在结果随运行变量平滑变化。RDD 因而识别阈值附近的局部效应。下一篇将继续沿着局部准实验推进,讨论当治疗由资格规则与实际接受不完全对应时,如何连接断点与工具变量。
flowchart LR
  X[运行变量 X:考试分数] --> T{跨过阈值 c?}
  T --> Z[资格分配 Z]
  Z --> D[实际接受治疗 D]
  D --> Y[结果 Y]
  X --> Y
  U[其他因素 U] --> Y
  C[只在 c 附近比较] --> L[拟合左右局部趋势]
L --> J[断点处跳跃 = 局部效应]估计伪代码:
输入运行变量 x、结果 y、阈值 c、带宽 h、核权重 K
令 r = x - c;只保留 |r| <= h 的样本
断点左侧拟合 y = a_left + b_left * r
断点右侧拟合 y = a_right + b_right * r
sharp RDD:输出 a_right - a_left
检查带宽敏感性、分数操纵、预定变量连续性与不确定性01 阈值为什么能制造局部对照?#
假设奖学金资格由标准化考试分数决定:分数 (X_i\ge c) 获得资格。令 (Z_i=\mathbb1(X_i\ge c)),实际是否领取奖学金为 (D_i),后续成绩为 (Y_i)。
分数高低本来就可能影响成绩,所以不能把所有达标者与未达标者作均值比较。RDD 的问题更局部:如果没有资格变化,潜在结果随分数在 (c) 附近平滑,那么门槛两侧任意接近的人,除了资格分配外应近似相似。观察到的结果跳跃就可归因于资格规则带来的变化。
**运行变量(running variable)**是决定分配的连续量,这里是考试分数;**断点(cutoff)**是规则改变的位置。关键识别假设是潜在结果在阈值处连续,且个体不能精确操纵自己落在阈值哪一边。
02 Sharp 与 fuzzy:资格不等于接受#
在 **sharp RDD(确定性断点)**中,跨过阈值会让治疗状态从 0 直接变为 1,即 (D_i=Z_i)。断点效应为
这里左右极限代表从断点两侧靠近,不能拿一个任意宽区间的样本均值差替代。
现实中,获得奖学金资格不保证领取,也可能有人通过其他渠道获得资助。若治疗概率只在阈值处跳升,属于 fuzzy RDD(模糊断点):用结果跳跃除以治疗概率跳跃,
这是阈值附近的 Wald 比率,形式上连接上一篇的 IV;资格指标充当工具,通常识别阈值附近服从资格影响的人群局部效果。它不是全体考生的 ATE。
03 手算断点:两侧趋势不同,阈值跳跃为 2#
把阈值中心化为 (r=X-c=0)。分数略低一侧,结果沿着 (Y=5+r) 变化;略高一侧,结果沿着 (Y=7+r) 变化:
| 相对分数 (r) | -1.0 | -0.5 | +0.5 | +1.0 |
|---|---|---|---|---|
| 结果 (Y) | 4.0 | 4.5 | 7.5 | 8.0 |
| 局部趋势 | (5+r) | (5+r) | (7+r) | (7+r) |
在阈值处,左趋势外推为 5,右趋势外推为 7,跳跃为 (7-5=2)。若直接比较四点均值,右侧均值 7.75 减左侧 4.25 得 3.5;它混入了左右分数位置不同造成的趋势差异。局部线性模型先允许两侧各有斜率,再比较断点截距。
04 纯 Python:按带宽与三角权重拟合左右直线#
下面的教学实现把断点设为 0,选 (|r|\le h) 的点,并赋予三角核权重 (1-|r|/h)。分别加权最小二乘拟合截距和斜率。截距就是估计的断点极限。它用于展示数据流,不计算标准误,也不替代有偏差修正的正式局部多项式推断。
def weighted_line_intercept(xs, ys, weights):
    sw = sum(weights)
    sx = sum(w * x for x, w in zip(xs, weights))
    sy = sum(w * y for y, w in zip(ys, weights))
    sxx = sum(w * x * x for x, w in zip(xs, weights))
    sxy = sum(w * x * y for x, y, w in zip(xs, ys, weights))
    det = sw * sxx - sx * sx
    if sw == 0 or abs(det) < 1e-12:
        raise ValueError("有效样本不足以拟合局部直线")
    intercept = (sy * sxx - sx * sxy) / det
    slope = (sw * sxy - sx * sy) / det
    return intercept, slope

def sharp_rdd(xs, ys, cutoff, bandwidth):
    left, right = [], []
    for x, y in zip(xs, ys):
        r = x - cutoff
        if 0 < abs(r) <= bandwidth:
            weight = 1 - abs(r) / bandwidth
            (right if r >= 0 else left).append((r, y, weight))
    if not left or not right:
        raise ValueError("带宽内断点两侧都必须有观测")
    left_fit = weighted_line_intercept(
        [p[0] for p in left], [p[1] for p in left], [p[2] for p in left])
    right_fit = weighted_line_intercept(
        [p[0] for p in right], [p[1] for p in right], [p[2] for p in right])
    return {
        "left_limit": left_fit[0], "right_limit": right_fit[0],
        "left_slope": left_fit[1], "right_slope": right_fit[1],
        "jump": right_fit[0] - left_fit[0],
    }

x = [-1.0, -0.5, 0.5, 1.0]
y = [4.0, 4.5, 7.5, 8.0]
print(sharp_rdd(x, y, cutoff=0.0, bandwidth=1.1))
# left_limit≈5, right_limit≈7, jump≈2输入 xs、ys 是长度为 (n) 的一维列表;每个分数与结果一一对应。中心化后 (r_i=x_i-c),加权回归设计矩阵每行是 ([1,r_i]),系数向量 ([a,b]) 分别是断点截距和局部斜率。实际研究还要报告带宽选择、核函数、偏差修正区间、聚类层级与带宽敏感性;不要只报告最漂亮的一个带宽。
05 断点能被操纵时,局部可比性就会破裂#
重点检查四类问题:
- 分数操纵:若学校知道资格线后可以改分,断点一侧的人可能被选择性堆积。检查分数密度在阈值处是否异常,并查阅评分制度。
- 基线变量跳跃:年龄、前期成绩等不应由本次资格影响的预定变量若也跳跃,说明局部可比性值得怀疑。通过不代表假设已被证明。
- 带宽与模型敏感性:带宽过宽把远处趋势混进来;过窄则有效样本少、方差大。报告多个合理带宽与局部线性主分析,不用高阶多项式任意追曲线。
- 阈值同时改变多项政策:断点识别的是规则带来的局部总效果。如果阈值同时触发奖学金、辅导和学籍政策,就不能把跳跃单独归给奖学金。
| 设计 | 外生变化来源 | 识别对象 | 关键风险 |
|---|---|---|---|
| 双重差分 | 时间与组别的处理前后变化 | 处理组平均变化 | 平行趋势 |
| 工具变量 | 鼓励推动实际治疗 | 工具响应者的 LATE | 排除限制、弱工具 |
| 断点设计 | 阈值造成的分配跳跃 | 阈值附近局部效应 | 操纵、带宽、阈值共变政策 |
思考练习
- 若阈值使资格概率跳 1.0,但领取概率只跳 0.4,为什么结果断点 2 不能直接解释为领取奖学金效果?
- 把带宽从 1.1 扩大到 10,会增加精度吗?它又会引入什么偏差风险?
- 若断点处前期成绩也跳跃,哪些设计事实需要先查清?
相关工作与原文
- Thistlethwaite & Campbell (1960), Regression-Discontinuity Analysis ↗
- Hahn, Todd & Van der Klaauw (2001), Identification and Estimation of Treatment Effects with a Regression-Discontinuity Design ↗
- Imbens & Lemieux (2008), Regression Discontinuity Designs: A Guide to Practice ↗
- Lee (2008), Randomized Experiments from Non-random Selection in U.S. House Elections ↗
- Cattaneo, Idrobo & Titiunik (2020), A Practical Introduction to Regression Discontinuity Designs ↗