同一段前缀该送到哪张卡?KV Cache-aware Routing 的命中定位与副本亲和
从轮询打散前缀缓存出发,手算最长块命中,把请求 token、KV 事件索引与副本选择串成可验证的 KV 缓存感知路由。
上一篇用分位数预测剩余输出长度,让调度器不再把一个长尾请求误判成短作业。但请求进入某个 GPU worker 之前,还有一层更早的决定:它究竟应该去哪个副本?
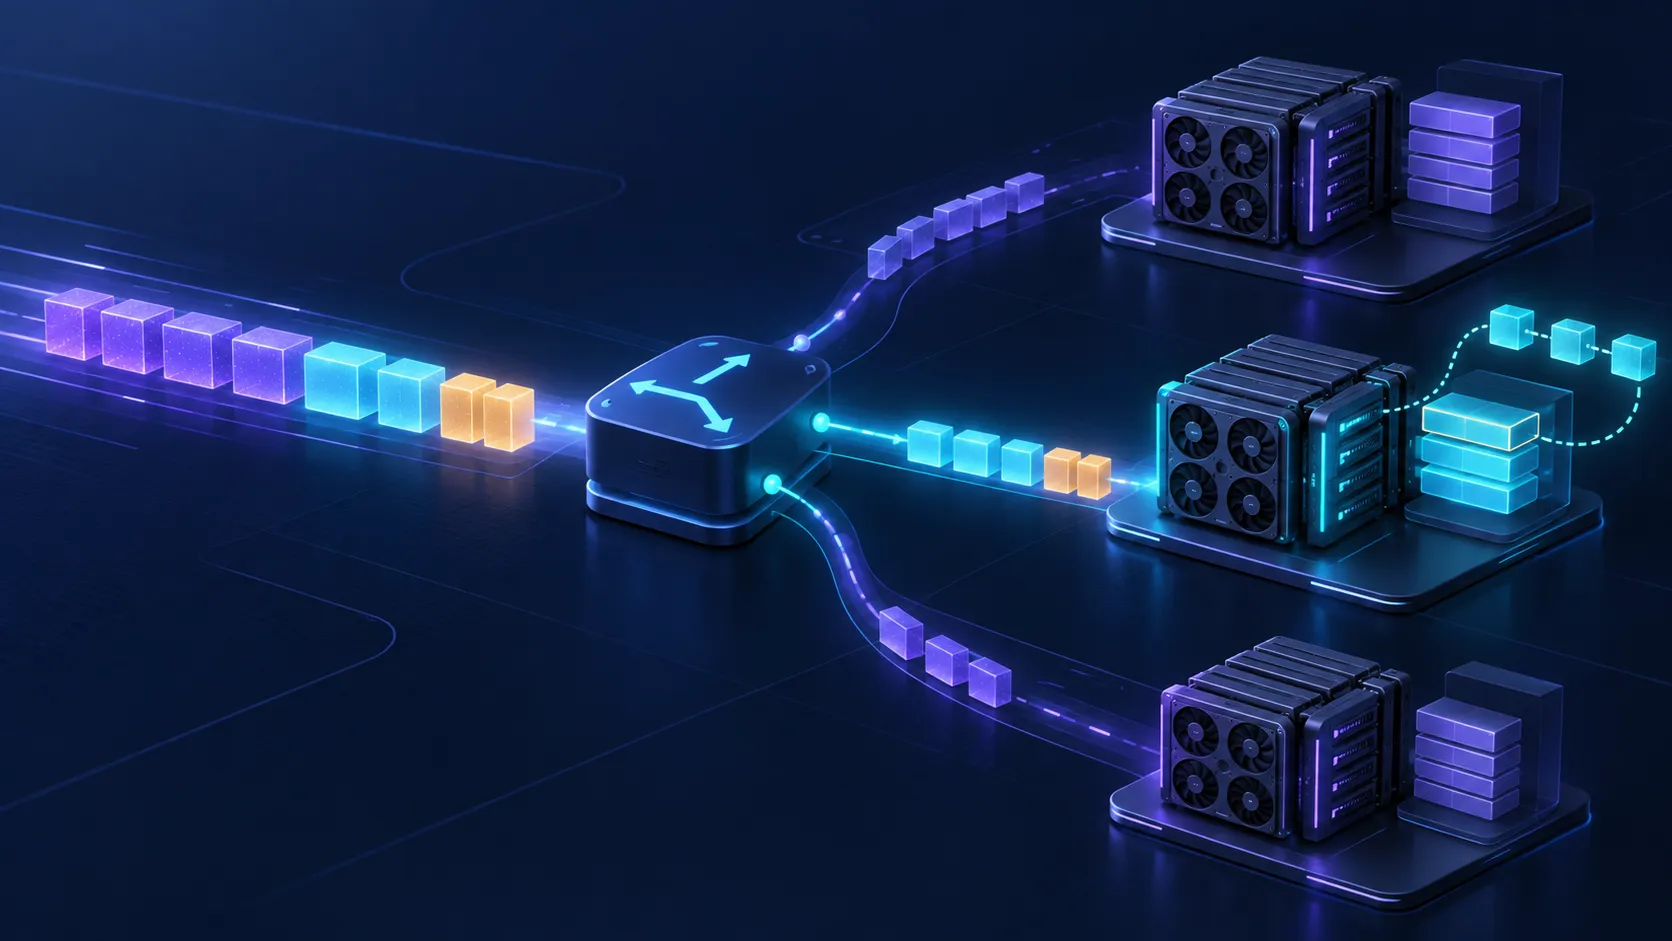
若三个副本都加载同一个模型,普通 Round-robin(轮询)看起来很公平;可多轮对话的下一轮很可能被送到另一张卡,于是上一轮留下的前缀 KV Cache(键值缓存)完全用不上。Automatic Prefix Caching(自动前缀缓存)解决的是“单个副本里能否复用”,KV Cache-aware Routing(KV 缓存感知路由)解决的是“怎样找到持有这段前缀的副本”。
本文只讲透这条链:请求分块哈希 → 查询全局位置索引 → 计算最长连续命中 → 选择副本 → 用真实 cached tokens 验证。
01 轮询为什么会把缓存收益稀释掉?#
假设会话每轮都保留 2048-token 系统提示和历史。第一次请求落到副本 A,A 完成 Prefill(预填充)后持有 2048 tokens 的 KV;第二次请求增长到 2304 tokens:
| 路由结果 | 可复用前缀 | 需要新 Prefill | 直觉 |
|---|---|---|---|
| 仍到 A | 2048 | 256 | 只计算新增问题 |
| 到 B | 0 | 2304 | 整段历史重算 |
轮询只平衡“请求个数”,不知道每个请求在各副本上的历史计算资产。若有 个副本、请求被独立均匀分发,下一轮回到原副本的概率仅约为 。会话亲和(Session Affinity)能让同一 session 粘住某个副本,但它不知道缓存是否已被淘汰,也不能发现不同 session 共享的系统提示。
02 路由器真正需要知道哪些状态?#
对请求 token 序列
按 block size 切成 个完整块。第 个块的键不能只哈希本块 token,而应延续上一篇 APC 的链式定义:
其中 包含模型版本、LoRA adapter、多模态输入摘要和租户隔离 salt 等会改变 KV 结果的 extras。路由层维护位置索引:
是模型标识, 是 replica id,tier 可区分 GPU、CPU 或远端层级。若索引只记录“某处存在”,却没有副本身份,仍无法完成路由。
03 数据流:KV 事件怎样变成一次路由决定?#
flowchart LR
  Q[请求 messages] --> T[模板化并 tokenize<br/>tokens: L]
  T --> H[链式分块哈希<br/>block keys: M]
  E[各副本 KV events<br/>stored / removed] --> I[位置索引<br/>key → replica set]
  H --> I
  I --> S[逐副本最长连续命中<br/>matched blocks: R]
  S --> P[过滤健康且模型匹配的副本]
  P --> W[选择命中最多者<br/>并设置回退规则]
  W --> G[GPU worker]
G --> V[观测 cached tokens、TTFT]这里有两条异步数据流:请求路径在毫秒级做查询;状态路径由 worker 上报 BlockStored / BlockRemoved 一类 KV 事件更新索引。路由器看到的是副本缓存的近似快照,不是强一致事务。
若 block key 矩阵记为 [M],查询结果可组织成布尔矩阵 :
副本 的最长前缀命中块数为
若全部为 1,则 ;可复用 token 数约为 。
04 三个副本怎样手算最长命中?#
令 block size 为 4,请求共有 14 tokens,因此只有前三个完整块能直接按块查找:
请求: [a b c d] [e f g h] [i j k l] [m n]
块键: h0 h1 h2 未满块索引查询返回:
| 副本 | 最长命中 | 需新算 token | |||
|---|---|---|---|---|---|
| A | ✓ | ✓ | ✗ | 8 | 6 |
| B | ✓ | ✓ | ✓ | 12 | 2 |
| C | ✓ | ✗ | ✓ | 4 | 10 |
C 虽然也有 ,却不能越过缺失的 使用它。缓存感知路由应选 B;最后 2 个未满块 token 仍需 Prefill。若 B 在请求到达前恰好淘汰 ,索引陈旧会造成一次 false hit,worker 最终以本地 block table 为准并重算,而不能错误复用。
05 一个可检查的最小路由器#
下面的 Python 只模拟核心机制,不依赖服务框架。输入是 block_keys: list[str] 与 locations: dict[str, set[str]],输出是副本名、命中块数和命中 token 数:
from dataclasses import dataclass


@dataclass(frozen=True)
class Route:
    replica: str
    matched_blocks: int
    matched_tokens: int


def longest_prefix_hits(
    block_keys: list[str],
    locations: dict[str, set[str]],
    replicas: list[str],
) -> dict[str, int]:
    hits = {replica: 0 for replica in replicas}
    for replica in replicas:
        for key in block_keys:
            if replica not in locations.get(key, set()):
                break
            hits[replica] += 1
    return hits


def route_kv_aware(
    block_keys: list[str],
    locations: dict[str, set[str]],
    replicas: list[str],
    inflight: dict[str, int],
    block_size: int,
) -> Route:
    if not replicas:
        raise ValueError("no healthy replicas")

    hits = longest_prefix_hits(block_keys, locations, replicas)
    # 先最大化连续命中;平局时选择 in-flight 更少者,再按名称稳定决策。
    chosen = min(replicas, key=lambda r: (-hits[r], inflight[r], r))
    return Route(chosen, hits[chosen], hits[chosen] * block_size)


locations = {
    "h0": {"A", "B", "C"},
    "h1": {"A", "B"},
    "h2": {"B", "C"},
}

print(route_kv_aware(
    block_keys=["h0", "h1", "h2"],
    locations=locations,
    replicas=["A", "B", "C"],
    inflight={"A": 1, "B": 3, "C": 0},
    block_size=4,
))
# Route(replica='B', matched_blocks=3, matched_tokens=12)时间复杂度是 。生产索引通常反向存储“块 → 副本集合”,并在第一个缺口停止;请求极长、worker 很多时,还要批量查询、限制候选集合并缓存 hash 计算。
06 为什么 token 化必须发生在正确的信任边界?#
路由器若只看原始字符串,两个视觉相同的 prompt 可能因为 chat template、Unicode 归一化、special tokens 或 tokenizer 版本不同而得到不同 token;反过来,字符串前缀相同也不保证模型输入完全相同。
正确路径应固定:
- 确认模型与 tokenizer 版本;
- 按服务端实际 chat template 展开 messages;
- 生成与 worker 一致的 token ids;
- 用相同 block size、父 hash 与 extras 构造 key;
- 只在同一隔离域查询位置。
若路由层无法可靠复现 worker 的 token 化,宁可使用 session affinity 作为粗粒度信号,也不要宣称“精确 KV 命中”。
07 索引一致性:stored 与 removed 事件会迟到#
令副本真实状态为 ,路由器快照为 。网络延迟、重连、事件乱序和路由器重启都会让二者不同:
- False positive:索引说块存在,实际已淘汰;结果是本次重算与额外排队,不能错误读取别的内容。
- False negative:索引没看到新块;结果是错过复用机会。
- 副本重启:旧 epoch 的位置记录若未清除,会制造大量 false positive。
事件至少应带 replica_id + epoch + block_key + action + sequence。消费者按 epoch 隔离重启前状态,用单调 sequence 丢弃倒序事件;定期快照或全量校准负责修复永久丢失。
worker restart
    ├─ epoch: 41 → 42
    ├─ 清空索引中 (worker, 41) 的全部位置
└─ 只接受 epoch=42 的后续事件08 缓存亲和、会话亲和与共享远端 KV 有何区别?#
| 方法 | 依据 | 缓存被淘汰后 | 跨会话共享前缀 | 主要代价 |
|---|---|---|---|---|
| Round-robin | 顺序计数 | 不感知 | 偶然 | 缓存命中低 |
| Session affinity | session key | 仍粘在原副本 | 通常不能 | 热会话倾斜 |
| Prefix-aware | 请求前缀近似 | 可能仍发往原副本 | 可以 | 近似状态误差 |
| KV-aware | 实际 KV 位置索引 | 可发现 miss | 可以 | 事件与索引系统 |
| 共享远端 KV | 远端可取回位置 | 可从外层恢复 | 可以 | 传输与分层成本 |
KV-aware routing 不是“把 KV 搬到目标卡”。它优先把计算送到 KV 所在地;若使用 LMCache 一类跨实例层级,还需把读取远端 KV 的传输时间计入收益。
09 当前 vLLM Production Stack 怎样落地?#
截至本文核对时,vLLM Production Stack 官方教程把 KV cache-aware routing 与 prefix-aware routing 区分开:前者查询当前 KV cache holder,后者可能只按前缀亲和,即使缓存已被淘汰仍保持粘性。官方示例通过带 LMCache 配置的 Helm values 部署两个实例,并要求每个实例使用不同 instanceId。
helm install vllm helm/ \
-f tutorials/assets/values-17-kv-aware.yaml然后向 OpenAI-compatible /v1/completions 连续发送具有增长共同前缀的请求,观察第二次是否回到持有匹配 KV 的实例。这里的 YAML、镜像与参数属于持续演进的部署接口;复制前应以当前官方 KV Cache Aware Routing 教程 ↗为准。
10 怎样证明路由真的带来收益?#
至少记录以下按副本拆分的量:
| 指标 | 要回答的问题 |
|---|---|
matched_tokens_at_router | 路由器认为命中了多少? |
cached_tokens_at_worker | worker 实际复用了多少? |
| TTFT P50/P95/P99 | 命中是否真的缩短首 token? |
| prompt tokens/s | Prefill 工作量是否下降? |
| index lookup latency | 查询是否吃掉收益? |
| false-hit / stale ratio | 事件索引是否可信? |
| per-replica inflight / KV usage | 是否形成热点? |
实验应固定模型、tokenizer、block size、采样配置和到达过程,对比 round-robin、session affinity 与 KV-aware。把冷启动、暖缓存和稳态分开报告;只用同一 prompt 连发十次会高估真实收益。
11 常见错误与最短调试路径#
- 把任意相同块数相加:打印逐块命中位图,确认遇到第一个 0 就停止。
- 路由器与 worker 的 chat template 不同:同时记录前 32 个 token ids 和模板版本。
- 忘记模型/adapter/salt:让 key schema 显式版本化,做跨租户负测试。
- 只看 request hit rate:改看 cached token ratio;命中 1 个短块与命中 8k tokens 不是同一收益。
- 副本重启后仍大量“命中”:检查 epoch 清理和 removed 事件积压。
- TTFT 没变:分解 tokenize、index lookup、排队、KV load、剩余 Prefill;瓶颈可能已转移。
- 命中副本排队严重:这是缓存亲和与负载平衡的冲突,不能靠继续提高亲和度解决。
最短路径是:验证 token 一致 → 验证 block key → 验证索引位置 → 对比 router 预测与 worker 实际 → 最后看端到端时延。
12 失败场景与局限#
- 请求之间几乎没有共享前缀;
- 前缀很短,索引查询和网络跳转比节省的 Prefill 更贵;
- 热门 system prompt 让所有请求都指向同一个 holder;
- 缓存淘汰速度高于事件传播与请求复用速度;
- Decode 主导时延,减少 Prefill 对 E2E 收益有限;
- tokenizer 或模板频繁升级,hash namespace 大量失效;
- 安全策略禁止跨用户、跨租户共享 KV;
- 远端 KV 虽“命中”,但读取带宽不足,冷算反而更快。
KV-aware routing 最大化的是某个计算复用信号,不等同于最小化排队时间,更不自动保证 SLO。下一篇将专门处理这个冲突。
13 今天真正需要记住什么?#
- 单副本 APC 只建立复用能力;多副本系统还要把请求送到真实持有最长连续前缀的副本。
- 路由键必须由实际 token、父块、模型环境与隔离域共同决定。
- KV 事件索引是最终一致快照;worker 本地状态始终是能否复用的最终真相。
- 验收要闭环比较 router 预测命中、worker 实际 cached tokens、TTFT 与副本负载。
14 思考题与小练习#
- block size 为 16,请求有 70 tokens。副本 A 连续命中前 3 块,B 命中前 4 块但
h_2的 removed 事件刚到。分别计算两者可复用 token,并说明 B 的索引更新后为何不能使用h_3。 - 给最小路由器加入
epoch:模拟副本 B 重启,证明旧 epoch 的全部位置不会参与新请求决策。 - 设计一个 4 副本实验,令 80% 请求共享 4096-token 系统提示。比较 round-robin 与 KV-aware 的命中率、TTFT 和最大/最小队列比;判断何时缓存收益被热点抵消。
相关工作#
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention ↗,块式 KV 管理与 vLLM serving 的基础。
- Zheng et al., SGLang: Efficient Execution of Structured Language Model Programs ↗,用 RadixAttention 与调度复用共享前缀。
- Gim et al., Prompt Cache: Modular Attention Reuse for Low-Latency Inference ↗,研究模块化 prompt 的 KV 复用。
- Patel et al., Splitwise: Efficient Generative LLM Inference Using Phase Splitting ↗,从集群资源视角分析大模型推理阶段与路由。
- vLLM Production Stack, KV Cache Aware Routing ↗,当前官方部署与验证入口。
15 下一篇预告#
最长前缀命中看似总该优先,但若热门提示只驻留在一个副本,所有请求都会涌向同一条队列。下一篇将把缓存收益与实时负载写进同一评分式,推导何时应该放弃一次命中,把请求溢出到冷但空闲的副本。