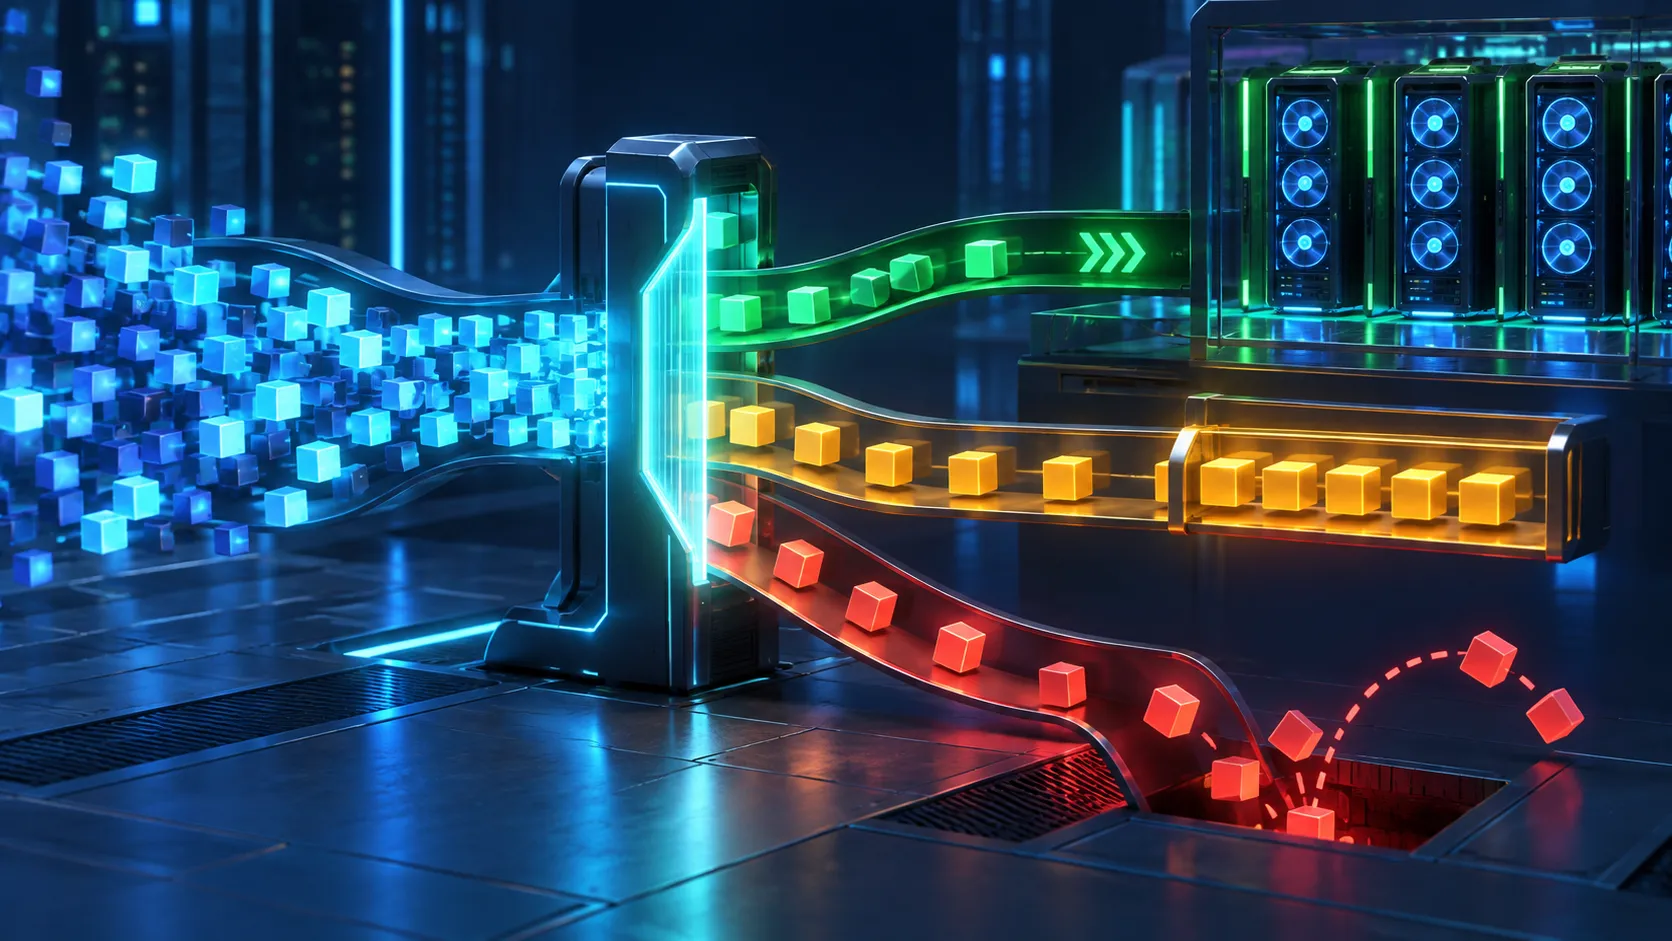
所有请求都接收为何会让所有人超时?LLM Admission Control 的期限、Token 预算与过载保护
从无限排队的延迟崩塌出发,手算可完成性,解释 token 工作量、deadline slack、公平配额、拒绝与降级。
上一篇让 Autoscaling 根据队列和 SLO 增加副本,但 GPU 冷启动远慢于流量尖峰。若网关在这段时间继续无条件接收,请求会把内存和队列填满;等新容量就绪,早期请求可能早已超过 deadline(期限),后续请求也被无望工作拖累。
Admission Control(准入控制)并不是粗暴限 QPS。它在请求进入昂贵执行阶段前回答:以当前 backlog、请求成本和期限,这份工作还有合理机会按约完成吗? 做不到时,立即拒绝、降级或延迟,往往比先排几分钟再超时更诚实,也能保护仍可完成的请求。
01 为什么“先接进来再说”会造成延迟崩塌?#
设服务能力为 work units/s,到达工作量为 。当 ,队列以 的速度增长;排队时间没有稳定上界。超时的客户端还可能重试,进一步抬高到达率,形成 Retry Storm(重试风暴)。
| 策略 | 满载时表象 | 用户结果 | 系统代价 |
|---|---|---|---|
| 无限排队 | 接受率 100% | 大量晚失败 | 内存、KV 与连接被占满 |
| 固定 QPS 限流 | 简单可控 | 忽略请求大小 | 长 prompt 仍可拖垮系统 |
| 并发上限 | 保护执行批 | 忽略在途 token | 请求成本差异巨大 |
| 工作量准入 | 按可完成性决策 | 快速失败或降级 | 需要成本估计与校准 |
02 把请求换成同一单位#
对请求 ,令:
- :未命中的 Prefill tokens;
- :预测的 Decode tokens,可取校准后的 p90;
- :两阶段每 token 的相对成本;
- :请求等价工作量。
若副本池 Ready 容量为 work units/s,已有 backlog ,请求 deadline 距现在还有 秒,保留安全系数 ,则一个最小可完成性条件是
等价地,Deadline Slack(期限余量)为
才接受。这个估计忽略 batch 非线性和阶段干扰,因此它是 admission guard,不是精确延迟承诺。
03 用三个请求手算一次决策#
假设 work units/s,,当前 backlog 。三个请求按到达顺序评估:
| 请求 | 加入前 | 预计完成 | 结果 | ||
|---|---|---|---|---|---|
| A | 800 | 5 s | 2400 | s | 接受 |
| B | 1600 | 5 s | 3200 | 6 s | 拒绝 |
| C | 400 | 6 s | 3200 | 4.5 s | 接受 |
B 被拒绝后不能加入 backlog;否则 C 会被一份已知无法按期完成的工作连带拖迟。接受 C 后 。
04 数据流:决策必须发生在昂贵分配之前#
flowchart LR
  Q[请求 + tenant + deadline] --> T[模板化 / tokenize]
  T --> W[估计未命中 Prefill<br/>与 Decode 分位数]
  M[Ready 容量、backlog<br/>KV 与 SLO] --> F[可完成性计算]
  W --> F
  F -->|可行| A[预留预算并入队]
  F -->|边界| D[降级模型 / 缩短输出]
  F -->|不可行| R[429/503 + Retry-After]
  A --> G[GPU scheduler]
  G --> U[完成/取消后释放预算]
U --> M先分配大块 KV、建立长生命周期流式连接,再决定拒绝,会让 admission 失去保护作用。请求取消、超时和失败后必须释放 reserved work;否则 shadow backlog 只增不减,系统会在空闲时继续误拒绝。
05 一个透明的最小 Admission Gate#
from dataclasses import dataclass
from math import ceil


@dataclass(frozen=True)
class RequestEstimate:
    request_id: str
    prefill_tokens: int
    decode_p90: int
    deadline_s: float


@dataclass(frozen=True)
class Decision:
    accepted: bool
    work: float
    predicted_finish_s: float
    retry_after_s: int


def admit(
    req: RequestEstimate,
    backlog_work: float,
    capacity_per_s: float,
    prefill_cost: float = 1.0,
    decode_cost: float = 4.0,
    safe_utilization: float = 0.8,
) -> Decision:
    if capacity_per_s <= 0 or req.deadline_s <= 0:
        raise ValueError("capacity and deadline must be positive")

    work = prefill_cost * req.prefill_tokens + decode_cost * req.decode_p90
    safe_capacity = capacity_per_s * safe_utilization
    predicted_finish = (backlog_work + work) / safe_capacity
    accepted = predicted_finish <= req.deadline_s

    # 拒绝时给出“队列需要消化多久”而不是随机常数。
    retry_after = 0 if accepted else max(1, ceil(backlog_work / safe_capacity))
    return Decision(accepted, work, predicted_finish, retry_after)


req = RequestEstimate("B", prefill_tokens=800,
                      decode_p90=200, deadline_s=5)
print(admit(req, backlog_work=3200, capacity_per_s=1000))
# work=1600, predicted_finish_s=6.0, accepted=False这里 decode_cost=4 只是演示单位换算;真实系数要按模型、GPU、并行度、batch 与上下文分桶测量。输出长度预测也可能漂移,因此要记录估计、实际 token 和 finish reason。
06 Batch 并行会不会让加法工作量失效?#
会。Continuous Batching 让多个请求共享一次 GPU step,吞吐不是单请求成本的简单相加;长上下文还会改变 attention 与 KV 代价。加法模型仍有三个用途:
- 比 request count 更能区分大小;
- 可用压测拟合局部有效容量;
- 发生偏差时容易解释和回退。
工程上可把容量写成查表函数
并对预测完成时间乘校准因子。不要一开始就训练黑盒延迟模型而无法解释误拒原因。
07 Deadline 从哪里来?#
客户端 deadline、网关 timeout 和内部 SLO 不是同一个概念。可用于 admission 的预算应为
若客户端未提供 deadline,就按 endpoint 的产品契约设置默认值;不能把“无限”等同于最高优先级。网关、router 和 worker 要传递绝对截止时间,而不是每一跳重新获得完整 timeout。
arrival 12:00:00.000
absolute deadline 12:00:03.000
router receives 12:00:00.120 → remaining 2.880 s
worker receives 12:00:00.310 → remaining 2.690 s08 接受、拒绝还是降级?#
决策不必只有二元:
| 动作 | 适用条件 | 必须告知客户端 |
|---|---|---|
| 接受 | 保守估计仍可达标 | deadline 与取消语义 |
缩短 max_tokens | 用户允许较短答案 | 实际上限与截断风险 |
| 切换小模型 | 质量等级允许 | 使用了哪一服务等级 |
| 延迟/异步队列 | 非交互任务 | 可查询任务 ID 与期限 |
| 快速拒绝 | 无可行方案 | retryable、Retry-After、幂等建议 |
降级必须来自显式产品契约,不能偷偷换模型。对流式生成,已发送 token 后再换模型还会破坏一致性,因此 admission 应尽量在首 token 前完成。
09 怎样避免重试风暴?#
若所有客户端在 Retry-After: 5 后同时重试,会产生新尖峰。服务器应给基于恢复时间的窗口,客户端执行 Exponential Backoff with Jitter(带抖动指数退避):
import random


def retry_delay(attempt: int, retry_after: float, cap: float = 60.0) -> float:
    base = min(cap, max(retry_after, 2 ** attempt))
return random.uniform(0.5 * base, 1.5 * base)只有幂等请求才能自动重试;工具调用、付费动作和有外部副作用的生成必须携带 idempotency key 或要求用户确认。
10 多租户下“先到先得”为何不公平?#
一个租户可以在突发瞬间占满全部 backlog。可为租户 维护 reserved work 与权重 ,按 Dominant Share(主导份额)或 token bucket 约束:
在都可完成的候选中优先较小 share,同时保留 emergency/interactive 等明确 service class。必须避免两种极端:高付费租户无限挤压其他人;低成本短请求永久越过长请求。可通过每类最小容量、最大 burst、aging 与审计日志组合解决。
11 KV Cache 还要做一条硬约束#
时间上可完成不代表内存上可容纳。令可用 KV blocks 为 ,请求 p99 需要 blocks,保留安全余量 ,则还需
未命中 prompt、预测输出、并行采样 n 和 beam width 都会改变 。若 KV 约束失败,可以等待 block 释放、降低输出上限或拒绝;不能靠乐观平均值让 worker 进入反复 preemption/recompute。
12 指标与日志怎样证明决策正确?#
每次 admission 至少记录:
request_id, tenant, service_class, absolute_deadline
prompt_tokens, cached_tokens, decode_p50/p90/p99, estimate_version
ready_capacity, backlog_work, kv_free, safety_factor
decision, reason_code, retry_after, degraded_to
actual_queue_ms, actual_tokens, finish_reason, final_slo核心看板包括 accepted/rejected/degraded rate、按 reason 的拒绝、false accept(接受后仍超时)、false reject 的影子估计、SLO goodput、重试放大系数、公平份额和因取消未释放预算的泄漏。
13 怎样用影子模式上线?#
- Observe:只计算不执行,比较预测完成时间与实际。
- Shadow reject:标记“本应拒绝”,仍让请求执行,估计误拒代价。
- Canary:仅对可安全重试的少量流量执行准入。
- Enforce:逐服务等级扩大,并保留 kill switch。
- Game day:模拟指标缺失、GPU 节点耗尽、预测漂移和重试风暴。
边界样本应优先降级或进入小额度探索桶,用于持续校准;若永远拒绝相同分布,就再也得不到其真实完成时间。
14 常见错误与最短调试路径#
| 现象 | 常见原因 | 最短检查 |
|---|---|---|
| 接受率高但超时更多 | 成本低估或 deadline 重置 | 回放绝对期限与实际 token |
| 空闲时仍大量拒绝 | reserved work 未释放 | 对账接受/完成/取消 |
| 长 prompt 拖垮系统 | 只限 QPS/并发 | 改看未命中 token 工作量 |
| 某租户几乎全被拒 | 全局 FIFO 无配额 | 按 tenant 看 share 与 burst |
| Retry-After 后再尖峰 | 客户端无 jitter | 查重试时间直方图 |
| 降级投诉 | 静默换模型/截断 | 检查产品契约与响应元数据 |
| KV 反复 preempt | 只做时间准入 | 加 p99 block 硬约束 |
最短路径:验证 deadline → tokenization/cache hit → 成本版本 → backlog 对账 → Ready 容量 → KV 硬约束 → reason code → 最终 SLO。
15 与相近方法的边界#
| 方法 | 主要控制量 | 优点 | 局限 |
|---|---|---|---|
| Rate limiting | 请求/秒 | 极简单 | 不识别大小 |
| Concurrency limit | 在途请求 | 保护连接/批次 | 不识别剩余工作 |
| Circuit breaker | 故障/过载状态 | 快速隔离 | 决策粗粒度 |
| Load shedding | 丢弃低价值负载 | 立即恢复 | 需优先级契约 |
| Admission control | 可完成工作量 | 贴近 deadline/SLO | 依赖估计与公平策略 |
| Autoscaling | 副本容量 | 解决持续需求 | 有冷启动延迟 |
它们不是替代关系:rate limit 保护边界,admission 判断可行性,circuit breaker 处理异常,autoscaling 修复容量。
16 失败场景与局限#
- 输出长度分布发生漂移,p90 不再覆盖 90%;
- 工具调用引入不可预测等待,GPU 成本模型失去主导性;
- batch 效率在流量组成变化时剧烈改变;
- 多区域间网络延迟与容量不同,却共享同一 backlog;
- 关键租户的 deadline 不可信或故意夸大优先级;
- 拒绝反馈诱发客户端更激进重试;
- 大量请求在首 token 后取消,历史容量估计被完成样本偏置。
准入控制不能增加物理容量,也不能替代容量规划。它的价值是在容量不足时把不可控的普遍晚失败,变成可解释、可恢复且对剩余请求伤害更小的明确决策。
17 今天真正需要记住什么?#
- 当到达工作量长期大于服务能力,无限队列只会把过载变成延迟崩塌。
- 用未命中 Prefill 与 Decode 分位数构造工作量,比 QPS 或并发更接近真实成本。
- Admission 的核心判据是 deadline slack 与 KV 可容纳性;接受后必须原子预留,结束后必须释放。
- 拒绝要携带 reason、Retry-After 与幂等语义;降级必须获得产品契约授权。
- 多租户公平、影子模式和误拒/误接监控,决定它能否从公式走向生产。
18 思考题与小练习#
- 容量 1600 units/s,,backlog 3600。一个工作量 1200、deadline 3 秒的请求是否接受?若 deadline 为 5 秒呢?
- 给最小实现加入
kv_blocks_p99、租户 token bucket 和取消释放;写测试证明拒绝请求不增加 backlog。 - 设计一次重试风暴实验:比较固定 5 秒、指数退避无 jitter、full jitter 三种客户端策略的峰值到达率。
相关工作#
- Welsh et al., SEDA: An Architecture for Well-Conditioned, Scalable Internet Services ↗,以显式队列和 admission 维持系统良态。
- Dean & Barroso, The Tail at Scale ↗,解释大规模服务为何必须治理尾延迟。
- Fu et al., Efficient LLM Scheduling by Learning to Rank ↗,研究未知输出长度下的请求排序。
- Zhang et al., JITServe: SLO-aware LLM Serving with Imprecise Request Information ↗,把不精确请求信息纳入 SLO-aware serving。
- Kubernetes, Horizontal Pod Autoscaling ↗,说明容量扩展控制与其延迟边界。
19 下一篇预告#
Admission 保护了单个服务入口,但生产集群还要回答“GPU 应该放在哪个模型、哪个租户和哪个时间段”。下一篇将进入多模型 GPU Capacity Planning(容量规划):用流量矩阵、显存约束、SLO 容量曲线和故障余量,把离线压测变成可执行的部署组合。