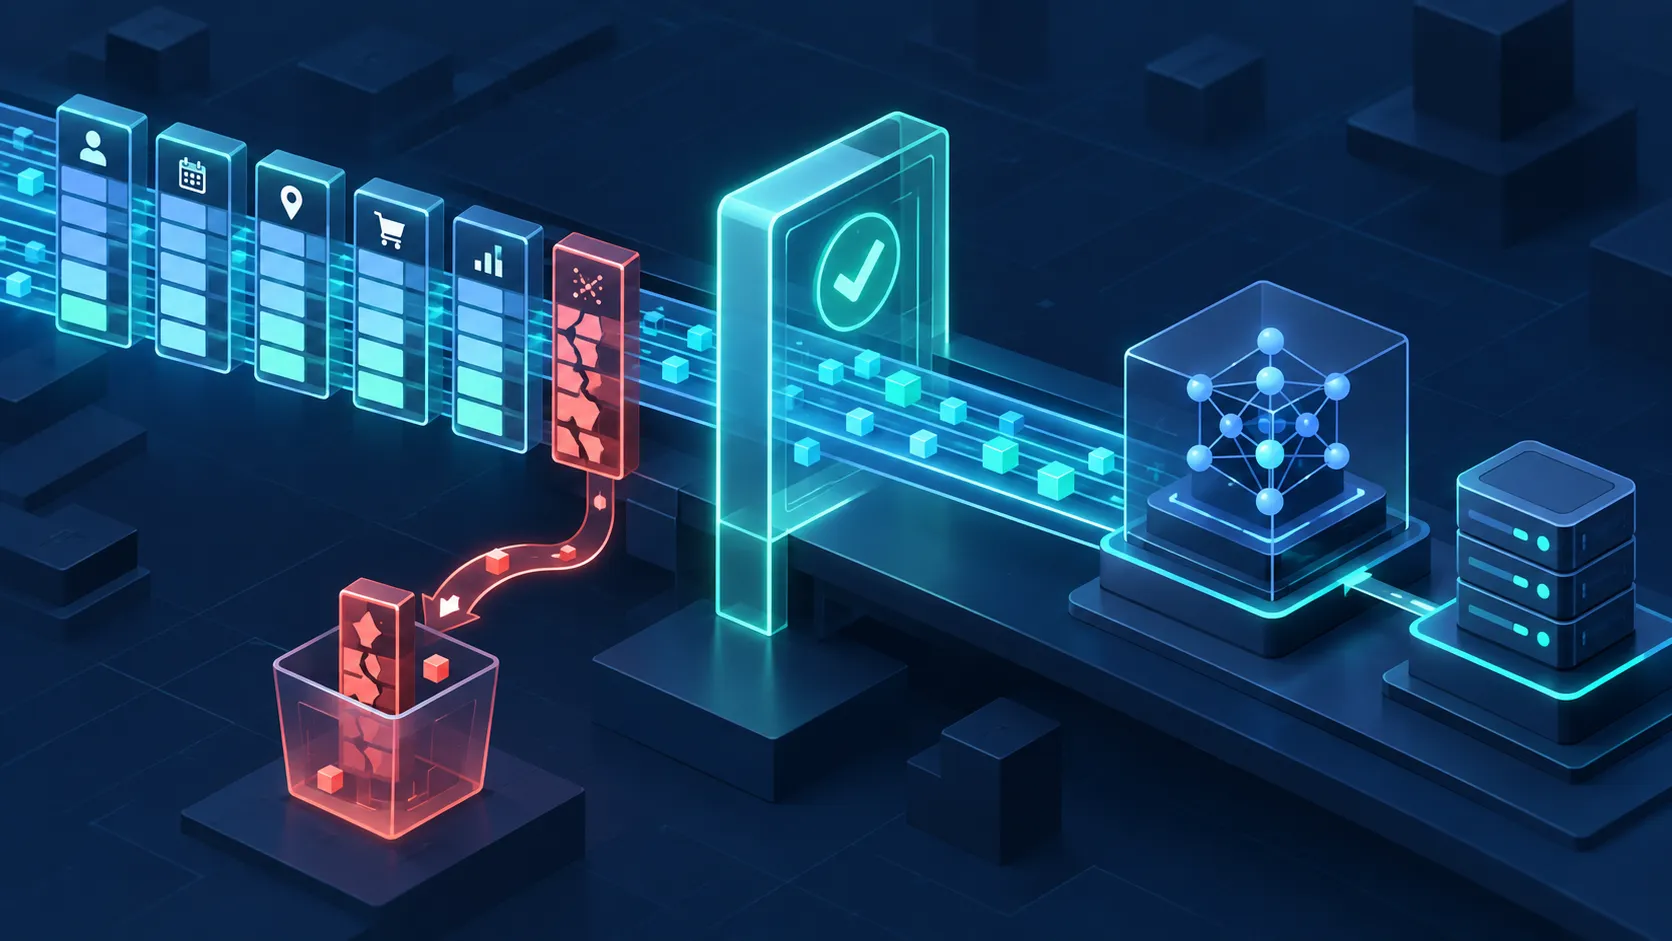
模型为何在上线后悄悄变差?用数据契约拦住特征模式漂移
把训练与服务的字段、类型、范围和缺失语义写成可执行数据契约,在模型前验证特征模式、隔离坏批次并保留可追溯证据。
上一篇用 ML Lineage(机器学习血缘)回答“线上模型来自哪里”。但血缘只能找到有问题的 features@digest;它不能阻止一个字段从 age_years 悄悄变成月龄、把类别 gold 改成 GOLD 后仍被送进模型。最后一环需要 Data Contract(数据契约):让数据生产者和消费者对可接受输入达成可执行、可版本化的约定。
本篇只讲一个核心问题:如何在训练和推理边界校验 Feature Schema(特征模式),把“模型变差”尽早变成一条可诊断的拒绝记录。
01 为什么列名相同仍可能是事故?#
假设流失模型训练时的输入为 : 是样本数, 是特征数,列依次为 age_years、balance、plan_code。在线单请求是 ,预处理后模型输出概率 。
旧办法常是“能解析 JSON 就预测”。它漏掉三类语义变化:
| 检查层 | 例子 | 只检查 JSON 的后果 |
|---|---|---|
| 形状 | 少了 balance | 编码器补默认值,模型静默偏移 |
| 类型/域 | age_years='unknown'、类别新值 | 强制转换失败或落入未知桶 |
| 分布 | 全站余额单位从元改分 | 类型正确,决策边界却整体失真 |
契约不是“所有坏数据都拒绝”。它应声明字段的 owner、版本、缺失语义、范围、允许类别、默认策略和升级规则;然后由验证器在进入特征变换之前执行。
flowchart LR
  P[Producer: profile service] --> R[raw request JSON]
  R --> V{contract v3\nshape/type/domain}
  V -->|pass| T[feature transform]
  T --> S{serve-time\nstatistics guard}
  S -->|pass| M[model@sha256]
  M --> O[prediction]
  V -->|fail| Q[quarantine + reason]
  S -->|drift| F[fallback / alert]
  Q --> L[lineage event]
F --> L这里的输入是原始对象 dict[str, object],验证输出是规范化记录;随后变换才产生 的浮点张量。不要拿模型输入张量的 shape 代替原始契约:一旦 OHE(One-Hot Encoding,独热编码)把类别展开,原字段语义已不可见。
02 极小手算:范围校验与分布校验不是一回事#
训练时 balance(单位:千元)的四个值为 ,均值 ,标准差 。在线一个批次为 ;每个值仍是非负 float,因此“类型 + 范围 ”会通过。
但批次均值 的 z-score 为
这不是普通波动,很可能是单位变更。注意:单条请求不适合做均值检验,必须在同一 contract version、同一流量切片的批次上累积;否则将少数高价值用户误报为漂移。
contract check: age_years=31, plan_code="gold"     -> 通过
contract check: age_years=-1                        -> 拒绝(范围)
contract check: plan_code="platinum"               -> 拒绝/显式 unknown 策略
batch guard: mean(balance)=250, baseline=2.5 -> 隔离并告警(单位疑似变化)03 用 Pydantic v2 把契约写成可运行代码#
Pydantic 的 BaseModel(基类模型)负责字段存在性和类型边界;Field 给出范围;ConfigDict(extra='forbid') 防止生产者悄悄添加拼错字段。当前 v2 API 使用 model_validate() 而不是 v1 的 parse_obj();官方也说明 Field 可通过 Annotated 附加约束。
from typing import Literal
from pydantic import BaseModel, ConfigDict, Field, ValidationError


class ChurnRequestV3(BaseModel):
    model_config = ConfigDict(extra="forbid", strict=True)

    age_years: int = Field(ge=18, le=100)
    balance_k: float = Field(ge=0.0, le=1_000.0)
    plan_code: Literal["free", "silver", "gold"]
    contract_version: Literal["3"]


raw = {"age_years": 31, "balance_k": 2.4,
       "plan_code": "gold", "contract_version": "3"}
try:
    record = ChurnRequestV3.model_validate(raw)
    # 输入 dict;输出不可变式访问的 ChurnRequestV3 记录
    x = [[record.age_years, record.balance_k, {"free": 0, "silver": 1, "gold": 2}[record.plan_code]]]
    print(x)  # [[31, 2.4, 2]],形状 [1, 3]
except ValidationError as exc:
print(exc.errors()) # 结构化 reason,切勿只吞掉异常strict=True 很适合服务边界:它不会把字符串 '31' 悄悄当作整数。不过训练的历史 CSV 常需要宽松解析;应把清洗步骤固定在训练管道,并把其代码 digest 写入血缘,不能通过降低线上标准来“兼容”。类别扩容也不该临时放行:先发布 v4 契约、同步更新编码器与模型签名,再做灰度。
04 运行路径:拒绝、隔离、降级都有不同含义#
伪代码把模型调用放在验证之后,并把每次失败转成有界、去敏的审计事件:
handle(request):
  parsed = validate(request, contract="churn/v3")
  if parsed.invalid:
      emit("contract_reject", version, field, reason_code, request_id)
      quarantine(pointer=request_id, ttl=24h)
      return fallback_or_4xx
  x = transform(parsed.value, transform_digest)
  if batch_guard(x).drift:
      emit("distribution_alert", contract_version, metric)
      route_to_safe_model_or_hold()
return model.predict_proba(x)quarantine 保存请求 ID 或受控样本指针,不应把身份证、Prompt 等原文塞进指标标签。4xx 适合调用方能修复的同步 API;异步批处理更适合隔离坏行、让好行继续,并以失败率阈值决定是否阻断整个批次。Fallback(降级)只能用于产品已定义的安全行为,绝不能拿“随机预测”掩盖数据事故。
05 训练、服务与模型签名要闭环#
同一逻辑至少有三份可核对的身份:
| 制品 | 应固定的内容 | 常见错误 |
|---|---|---|
| 数据契约 | name@version、字段与语义、owner | 只把 YAML 放在 main 分支 |
| 特征变换 | 输入契约、列顺序、类别词表、代码 digest | 训练和服务各复制一份函数 |
| 模型签名 | 输入 、dtype、输出 | 只记录模型文件名 |
对于 batch size(批量大小),线性分类器的权重 、偏置 ,其 logits 是 。契约保证 的列语义与 一致;模型签名保证张量 shape 与 dtype 可执行;血缘保证三者来自哪个不可变 revision。三个都缺一不可。
工程上建议把契约 JSON/YAML 做 canonical digest,写进训练 run、模型元数据和推理日志。例如:contract_sha256、transform_sha256、model_sha256。回滚时必须三者一起回滚;只把 alias 指向旧权重,仍可能让旧模型吃到新单位的数据。
06 常见失败与调试顺序#
- 验证器让未知字段穿透:检查是否误用了
extra='ignore';在 CI 用拼错的balnce_k做负向测试。 - 训练通过、线上全拒绝:比较 API 网关实际序列化后的 payload 与契约;重点查整数被转字符串、时区和
null。 - 告警风暴:按
contract_version、地区、流量来源分桶,再确认 baseline 是否与当前版本同源;不要把新旧版本混算。 - 默默落入 unknown bucket:把 unknown 比率作为 SLI(服务等级指标),并为新类别建立显式升级流程。
- 契约校验很慢:将纯结构校验放同步路径,分位数/漂移统计放批处理;记录 p95 延迟和 reject rate,而不是猜测瓶颈。
数据契约的局限是它擅长检查“已知的不变量”,却不能证明标签是否正确、因果关系是否仍成立,也不能自动发现所有概念漂移。因此下一步应把这些结构性证据接到数据与模型监控的告警策略:如何用基线、切片和行动阈值让监控真正驱动处置。
思考练习#
- 若
plan_code新增platinum,什么时候应拒绝、映射到 unknown、还是发布新契约?分别由谁批准? - 为
balance_k设计一个既能发现单位变化、又不因少量高余额用户误报的批次 guard;写出最小样本量与阈值理由。 - 将一个
[B, 3]的输入契约升级为含文本 embedding 的[B, 3+E]模型时,哪些 digest 必须变,哪些日志字段必须保留?