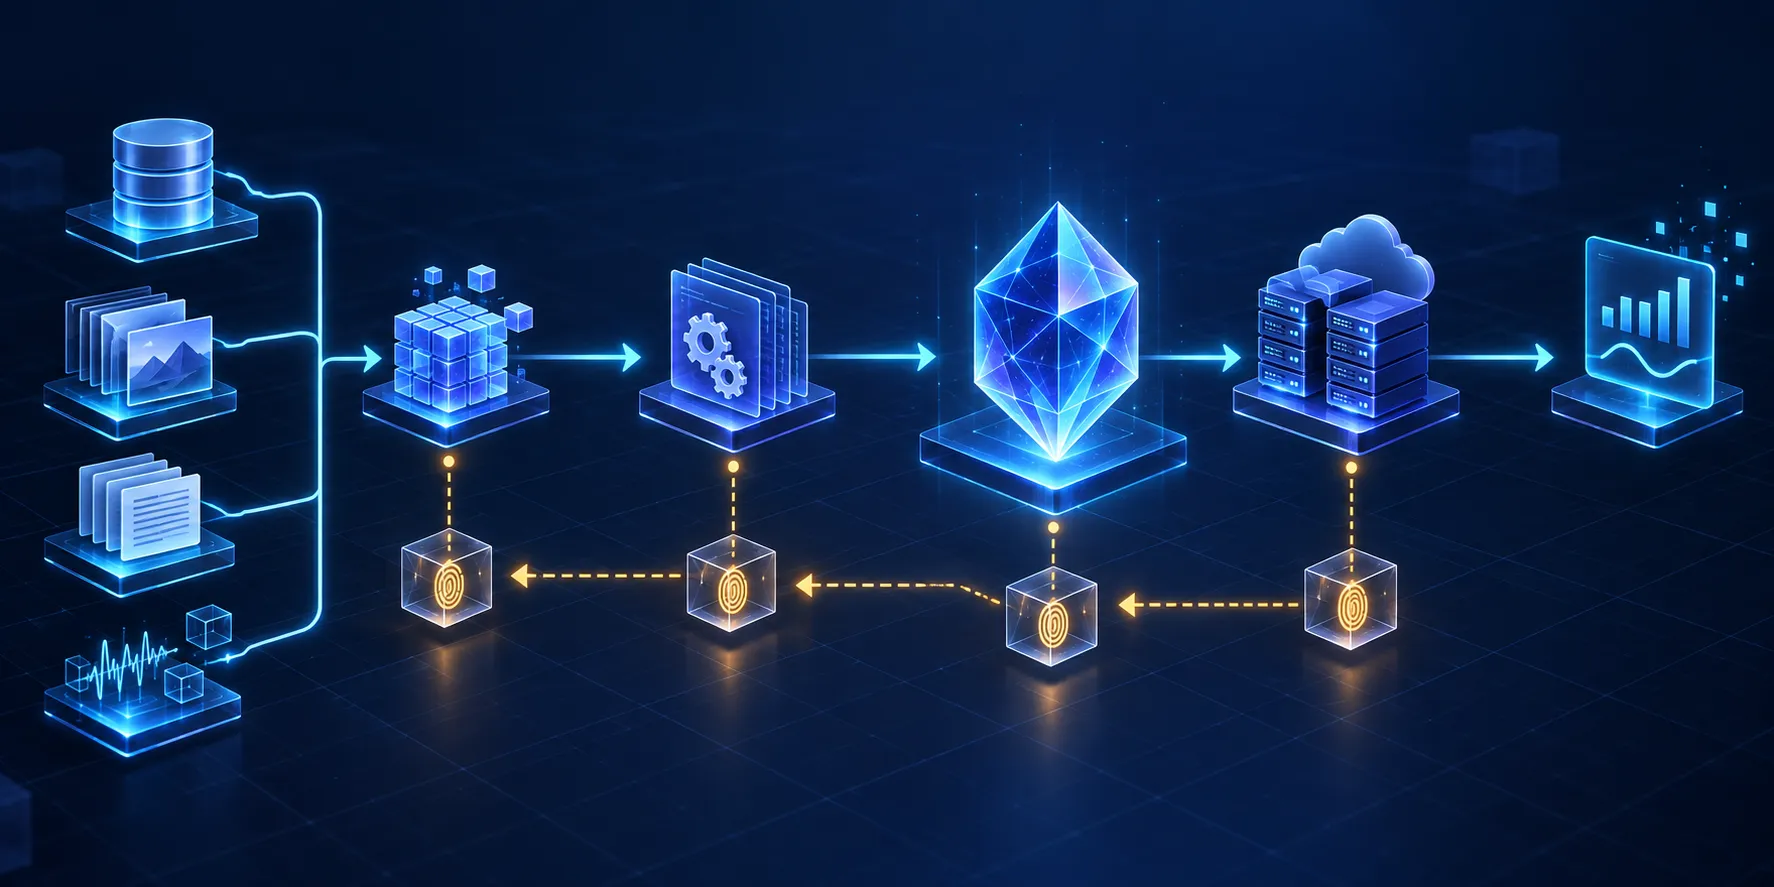
线上模型究竟来自哪份数据?ML Lineage 的不可变身份、血缘 DAG 与可复现回滚
把数据快照、特征代码、训练配置、模型制品和部署记录连接成可查询血缘图,手算影响传播,并用 MLflow 与 OpenLineage 当前 API 记录可复现身份。
上一篇的复盘发现:团队能找到 model-final.pkl,却无法证明它使用了哪天的数据、哪次特征代码和哪份训练配置。即使模型文件还能下载,也不能重建同一个决策过程。
ML Lineage(机器学习血缘)要回答的是:一个线上预测沿哪些输入、变换与运行产生;某个上游变化会影响哪些下游制品。本篇聚焦不可变身份、血缘 DAG、影响查询和可复现回滚。
01 文件路径为什么不是版本?#
下面这些记录看似完整,其实都指向可变状态:
s3://ml-data/train/latest.parquet
git branch: main
config: configs/prod.yaml
model: registry/churn/latest明天再次读取,四者内容都可能改变。稳定身份至少包含:
- 数据:不可变快照 ID 或内容摘要、查询文本、截止水位;
- 代码:Git commit SHA,加上未提交补丁应为空;
- 环境:锁文件摘要、容器镜像 digest,而非只有
python=3.12; - 配置:规范化后的完整配置摘要;
- 模型:权重内容摘要、签名、训练 run ID;
- 部署:模型 revision、服务配置、路由与时间窗。
地址回答“去哪里取”,Digest(内容摘要)回答“取到的是否还是同一份”。二者都要保存。
02 把 ML 系统表示成有向无环图#
令血缘图为 。节点 是不可变实体或一次运行,边 表示 消费了 :
flowchart LR
  R[(raw@91bf)] --> F[feature job@7ac9]
  C[code@4e21] --> F
  F --> S[(features@2d70)]
  S --> T[train run@r184]
  H[config@0aa3] --> T
  T --> M[(model@sha256:6c8e)]
  M --> D[deployment@prod-43]
D --> P[(prediction batch@2026-09-29)]Entity(实体)是数据集或制品,Run(运行)是一次变换。不要把二者压成一个模糊的“pipeline version”:同一份代码可运行多次,同一次运行也可读取多个数据集并输出多个制品。
对训练输入 、标签 ,血缘不应保存全部张量到元数据服务,而应保存:dataset_digest、N、D、schema、统计摘要、受控存储 URI 和访问策略。模型输出参数 同样以 artifact URI、digest、签名与 P 描述。
03 不可变身份怎样计算?#
一个简单的模型身份可以写成
其中 是数据身份、 是代码 SHA、 是环境 digest、 是超参数摘要、 是权重摘要, 是抗碰撞哈希, 表示按稳定顺序拼接。
关键是 Canonicalization(规范化):JSON 键顺序、浮点表示、换行和时区必须固定,否则语义相同也会得到不同摘要。
import hashlib
import json
from pathlib import Path


def canonical_digest(value: dict) -> str:
    payload = json.dumps(
        value, sort_keys=True, separators=(",", ":"), ensure_ascii=False
    ).encode("utf-8")
    return hashlib.sha256(payload).hexdigest()


identity = canonical_digest({
    "data": "sha256:91bf...",
    "code": "4e21c8a",
    "image": "registry/train@sha256:33a1...",
    "params": {"lr": 3e-4, "batch_tokens": 65536},
    "weights": "sha256:6c8e...",
})
print(identity)输入是一个标量/对象元数据字典,输出是 64 位十六进制 SHA-256。大文件应流式读取分块哈希;目录需先固定相对路径排序,并明确是否包含权限、软链接和隐藏文件。
04 极小手算:一次数据修正会影响什么?#
图中有边:
raw-v1 -> features-v4 -> train-r8 -> model-m42 -> deploy-prod
raw-v1 -> audit-report-q3现在发现 raw-v1 的年龄字段单位错误,并生成 raw-v2。从 raw-v1 做广度优先搜索,受影响下游共有 5 个:features-v4、train-r8、model-m42、deploy-prod、audit-report-q3。
但“受影响”不等于“必须重跑”:审计报告若只统计行数,单位变化可能不改变输出。血缘图告诉我们去哪里验证,语义契约才决定是否重算。
from collections import deque


def descendants(graph: dict[str, list[str]], source: str) -> list[str]:
    seen = {source}
    queue = deque([source])
    ordered: list[str] = []
    while queue:
        node = queue.popleft()
        for child in graph.get(node, []):
            if child not in seen:
                seen.add(child)
                ordered.append(child)
                queue.append(child)
    return ordered


graph = {
    "raw-v1": ["features-v4", "audit-report-q3"],
    "features-v4": ["train-r8"],
    "train-r8": ["model-m42"],
    "model-m42": ["deploy-prod"],
}
print(descendants(graph, "raw-v1"))复杂度是 ;真实系统还要处理分页、跨命名空间权限和晚到事件。
血缘回滚查询器
选择线上版本和变更节点,观察可复现回滚必须锁定哪些身份。
回放结论
05 数据流:记录事件,不在训练结束后猜历史#
最佳记录点在每个边界发生时:
- 读取输入前解析不可变 dataset revision;
- 运行开始时记录代码、配置、环境与 run ID;
- 输出提交后计算 digest,并原子写入
COMPLETE事件; - 模型晋级时把 model ID 绑定到 deployment revision;
- 推理日志只引用这些 ID,不复制敏感训练元数据。
sequenceDiagram
  participant O as Orchestrator
  participant J as Training Job
  participant A as Artifact Store
  participant L as Lineage Store
  O->>L: START(run_id, job, input IDs)
  O->>J: immutable input URIs + config digest
  J->>A: upload weights.tmp
  A-->>J: artifact digest
  J->>A: atomic promote weights.tmp -> weights@digest
J->>L: COMPLETE(run_id, output ID, metrics)若任务崩溃,只发送 FAIL,不能把半写入制品标成输出。元数据事件应幂等:run_id + event_type + output_id 重试不能生成多个逻辑运行。
06 用当前 MLflow API 记录数据与模型输入#
MLflow 当前官方 API 用 mlflow.data.from_pandas() 创建带 source、name 与 digest 的 Dataset,再用 mlflow.log_input(..., context="training") 绑定到活动 run。下面显式记录数据、参数、代码 SHA 与模型;不把 fit() 当成不可解释黑盒:
import mlflow
import mlflow.sklearn
import pandas as pd
from sklearn.linear_model import LogisticRegression

frame = pd.DataFrame({
    "age": [22, 45, 31, 52],
    "balance": [1.2, 8.0, 2.4, 7.1],
    "churn": [0, 1, 0, 1],
})
X = frame[["age", "balance"]]  # [N=4, D=2]
y = frame["churn"]              # [N=4]
dataset = mlflow.data.from_pandas(
    frame,
    source="s3://ml-data/churn/snapshot=2026-09-28/part.parquet",
    name="churn-train-2026-09-28",
)

with mlflow.start_run(tags={"git.commit": "4e21c8a"}) as run:
    mlflow.log_input(dataset, context="training")
    mlflow.log_params({"C": 1.0, "solver": "lbfgs", "max_iter": 200})
    model = LogisticRegression(C=1.0, solver="lbfgs", max_iter=200)
    model.fit(X, y)
    info = mlflow.sklearn.log_model(
        sk_model=model,
        name="churn-model",
        input_example=X.iloc[:2],
    )
print(run.info.run_id, info.model_uri)X 输入形状是 [4,2],y 是 [4];模型输出 predict_proba(X) 是 [4,2]。MLflow Dataset digest 适合跟踪与比较,但关键数据仍应由底层版本化存储保证不可变,不能把元数据哈希当成完整备份。
07 用当前 OpenLineage API 表达跨系统 DAG#
当训练跨 Airflow、Spark、特征平台和模型注册表时,开放事件格式更容易连接边界。OpenLineage Python 客户端当前使用 RunEvent、Run、Job、InputDataset 与 OutputDataset:
from datetime import datetime, timezone
from openlineage.client import OpenLineageClient
from openlineage.client.event_v2 import (
    InputDataset, Job, OutputDataset, Run, RunEvent, RunState,
)
from openlineage.client.uuid import generate_new_uuid

client = OpenLineageClient()  # transport 由 openlineage.yml / 环境配置
run = Run(runId=str(generate_new_uuid()))
job = Job(namespace="ml-prod", name="churn.train")
inputs = [InputDataset(namespace="s3://ml-data", name="churn@sha256:91bf")]
outputs = [OutputDataset(namespace="s3://ml-models", name="churn@sha256:6c8e")]

client.emit(RunEvent(
    eventType=RunState.START,
    eventTime=datetime.now(timezone.utc).isoformat(),
    run=run, job=job, inputs=inputs, producer="https://example.com/ml-platform",
))
# ...只有模型制品原子提交成功后...
client.emit(RunEvent(
    eventType=RunState.COMPLETE,
    eventTime=datetime.now(timezone.utc).isoformat(),
    run=run, job=job, inputs=inputs, outputs=outputs,
    producer="https://example.com/ml-platform",
))START 与最终的 COMPLETE/FAIL/ABORT 必须共享同一个 runId。namespace + name 要形成稳定唯一身份;不要把访问令牌、原始 Prompt 或 PII 放进名称与 facet。
08 回滚不是把 alias 指回旧模型#
一个可复现回滚包至少包含:
| 层 | 必须锁定 | 仅回滚模型的失败方式 |
|---|---|---|
| 数据/特征 | snapshot、schema、transform SHA | 旧模型读取新单位或新类别编码 |
| 模型 | 权重 digest、签名、tokenizer | 文件同名但内容已替换 |
| 运行环境 | image digest、GPU/库约束 | 算子或序列化格式不兼容 |
| 服务配置 | Prompt、路由、工具 schema | 权重回退但行为仍是新版 |
| 状态 | 索引、缓存、写入 schema | 旧服务无法读取新状态 |
回滚查询应先从 deployment_id 反向遍历,得到 Transitive Closure(传递闭包),验证所有节点可访问、摘要一致、兼容检查通过,再产生候选变更。血缘系统只提供证据,生产切换仍要走上一篇的可逆动作与审批门槛。
09 常见错误与最短调试路径#
| 现象 | 根因候选 | 第一项检查 |
|---|---|---|
| 同一 run 每次得到不同模型 | 随机种子、数据顺序或算子非确定 | seed、worker、CUDA deterministic 记录 |
| 血缘图有节点但打不开制品 | 元数据与 artifact 提交非原子 | COMPLETE 是否早于上传成功 |
latest 回放结果变化 | 记录的是可变别名 | 底层 snapshot/digest |
| 下游影响查询漏节点 | 某任务未发事件或 namespace 不一致 | event completeness 与命名规范 |
| 图中出现重复 run | 重试没有稳定 attempt/run ID | 幂等键与 orchestrator attempt |
| 元数据服务含敏感原文 | 把 lineage 当日志仓库 | 只留 ID、schema、统计与受控 URI |
10 失败场景与相近概念#
- Lineage 不保证 Reproducibility(可复现性):随机性、外部 API 和非确定算子仍需单独控制。
- Experiment Tracking(实验跟踪)偏向一次 run 的参数、指标与制品;Lineage 关注跨系统输入输出关系,两者重叠但不等价。
- Model Registry(模型注册表)管理模型生命周期、版本与晋级;它应消费血缘证据,不应替代数据/特征血缘。
- Feature Store(特征存储)解决特征复用与线上/离线一致性;它是血缘图中的一类实体和运行,不是整张图。
- Data Catalog(数据目录)强调发现、schema 与治理;若没有运行边,无法回答某模型实际消费了哪个快照。
- 旧数据已依法删除时,完全重训可能不允许;应明确“可审计但不可重建”的保留边界。
11 工程验收清单#
- 随机抽一个生产 deployment,能否在 2 分钟内找到模型、run、代码、配置和数据快照?
- 对每个 COMPLETE 输出,artifact 是否存在且 digest 匹配?
- 对输入数据修正,后代查询是否覆盖训练、模型、部署与报告?
- 删除/过期策略是否同步更新节点状态,而不是留下假可用 URI?
- 元数据是否不含秘密、PII 和未经授权的 Prompt?
- 用故意损坏的 digest 演练,晋级门禁是否会失败关闭?
12 今天真正需要记住什么?#
- 路径和
latest是定位符,不是版本;可复现身份需要不可变快照与内容摘要。 - 用“实体—运行—实体”的 DAG 表达数据、代码、配置、模型与部署,记录发生在边界当时。
- 血缘图回答影响范围,schema 与业务契约决定是否需要重算。
- 可复现回滚必须锁定模型周边状态;血缘提供证据,但不替代兼容检查和发布审批。
13 思考题与小练习#
- 数据快照同时被三个特征任务消费,其中两个模型部署到线上。画出 DAG;当一个字段单位变化时,写出后代集合与需要语义检查的边。
- 为什么
git commit + random seed仍不足以复现 GPU 训练?列出至少四个缺失身份或非确定来源。 - 扩展
descendants,为每个节点加入available与digest_verified;生成回滚包时,只要一个必需祖先不可用就返回明确阻塞原因。
相关工作#
- Sculley et al., Hidden Technical Debt in Machine Learning Systems ↗,说明 ML 系统中的隐式数据依赖与配置债务。
- Baylor et al., TFX: A TensorFlow-Based Production-Scale Machine Learning Platform ↗,展示生产 ML 平台中的验证、元数据和流水线设计。
- MLflow Dataset Tracking ↗,当前官方数据集身份与
log_input文档。 - OpenLineage Specification ↗,跨作业、运行与数据集的开放血缘事件规范。
- Schelter et al., On Challenges in Machine Learning Model Management ↗,讨论模型管理中的依赖、版本、复现与部署挑战。
14 下一篇预告#
血缘图已经能证明候选模型从哪里来,但“有记录”不等于“允许上线”。下一篇将进入 Model Registry Promotion Gates(模型注册表晋级门禁):怎样把签名、数据验证、离线评测、风险审批与环境晋级写成不可绕过的状态机。