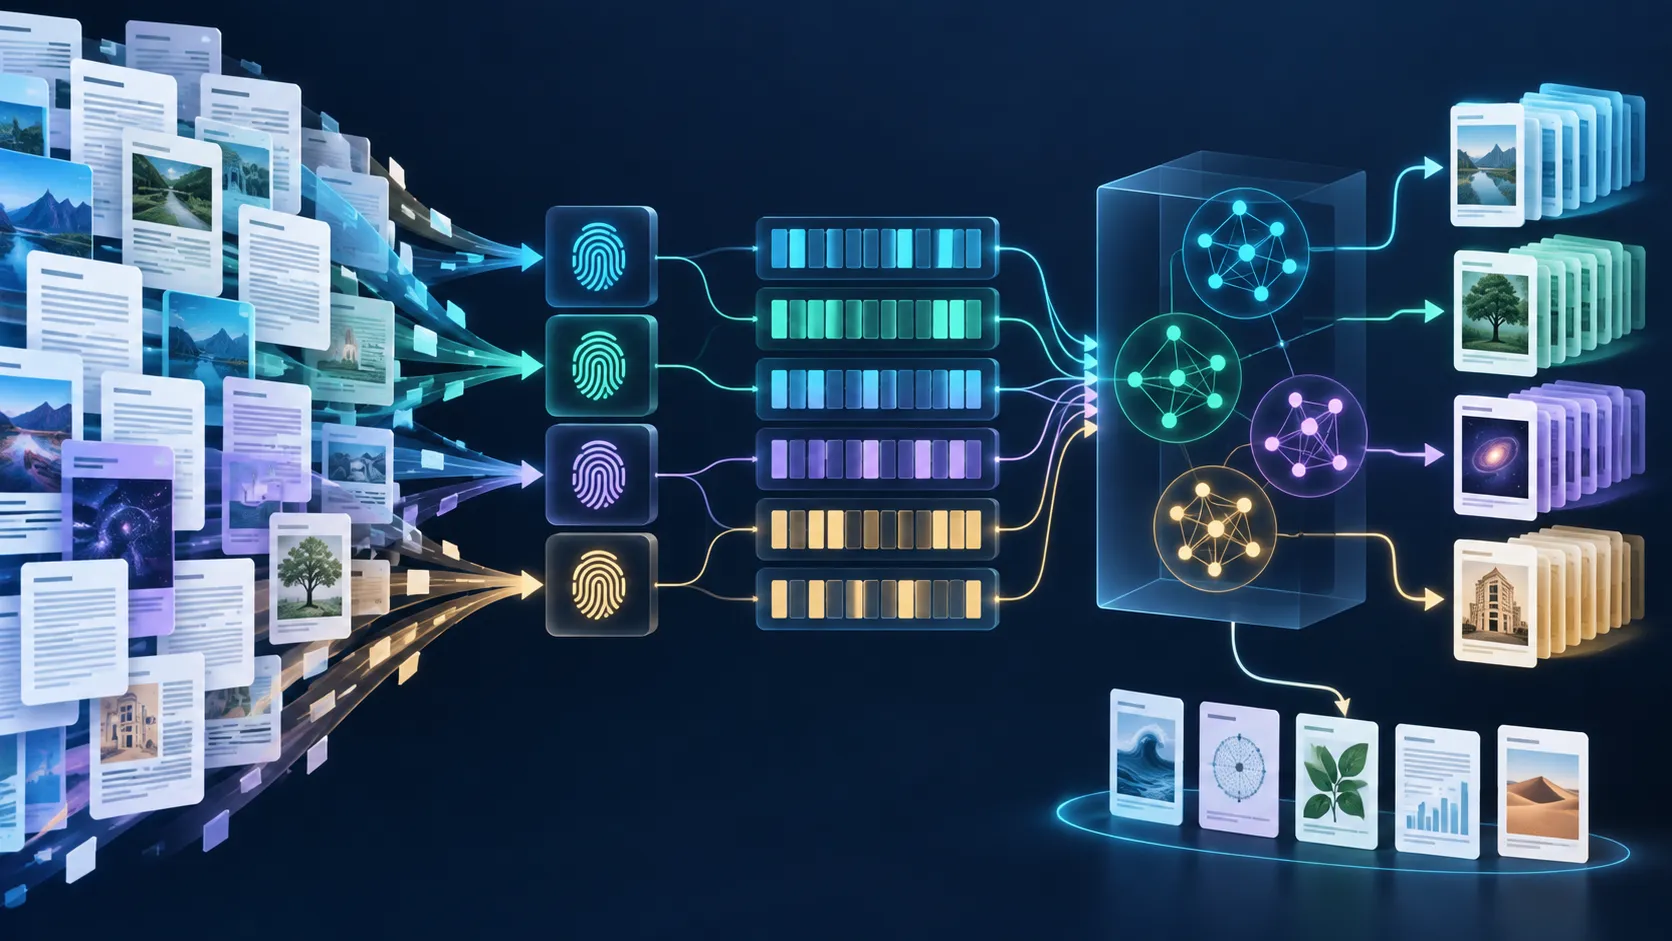
十亿段语料怎样避免反复背诵?精确去重、MinHash 与评测污染
从重复网页造成的隐式加权出发,手算 Jaccard 与 MinHash,构造可审计的精确—近重复去重流水线,并处理数据切分、阈值和分布式工程陷阱。
上一篇把 token id 映射为 Embedding,并让 LM Head 把隐藏状态投回词表。模型闭环已经完整,但它会忠实放大数据分布:同一篇公告被镜像 100 次,就相当于在损失中给它 100 倍权重;测试题若混进训练集,漂亮分数也不再表示泛化。
数据去重(Data Deduplication)不是“删掉看起来相似的文本”这么简单。本文只讲透三个紧密环节:用内容哈希删除精确重复、用分片 Jaccard 与 MinHash 发现近重复,以及在切分之前建立不可泄漏、可复现的删除规则。
01 重复数据怎样改变训练目标?#
设文档 含 个可预测 token,逐 token 平均损失为 :
若 被复制 次,它的权重从 变成 。重复不是只浪费磁盘,而是在未声明的情况下重写采样分布,并增加逐字记忆、隐私暴露与训练—评测污染(Train–Evaluation Contamination)的风险。
02 去重流水线放在哪里?#
flowchart LR
  A[原始文档 + source/id] --> B[解析正文]
  B --> C[仅供匹配的规范化副本]
  C --> D[内容哈希:精确桶]
  D --> E[shingle 集合]
  E --> F[MinHash + LSH 候选]
  F --> G[真实 Jaccard 复核]
  G --> H[重复图/连通分量]
  H --> I[确定性保留代表]
  I --> J[训练/验证/测试切分]
J --> K[tokenize 与混合采样]原文与匹配副本必须分开保存。去重规范化可以折叠空白、统一换行,却不应悄悄改写最终训练文本。每步输出原因码,例如 exact_hash、near_duplicate、eval_overlap,否则删错后无法追踪。
03 精确重复:关键是哈希什么#
对规范化字节串 计算摘要 。相同摘要先进入同一桶,再比较字节确认;这样即使理论上发生哈希碰撞,也不会误删。
import hashlib
import re
import unicodedata

def match_view(text: str) -> str:
    text = unicodedata.normalize("NFC", text)
    return re.sub(r"\s+", " ", text).strip()

def exact_key(text: str) -> tuple[str, bytes]:
    payload = match_view(text).encode("utf-8")
    digest = hashlib.blake2b(payload, digest_size=16).hexdigest()
    return digest, payload

seen: dict[str, list[bytes]] = {}
def is_exact_duplicate(text: str) -> bool:
    digest, payload = exact_key(text)
    bucket = seen.setdefault(digest, [])
    duplicate = payload in bucket
    if not duplicate:
        bucket.append(payload)
return duplicate输入是 Unicode 文本,输出是布尔值;生产系统还应输出匹配文档 id。不要用 Python 的 hash():它不是跨进程稳定的内容指纹。
04 为什么精确哈希抓不到网页近重复?#
页眉、日期或一句免责声明不同,整篇摘要就完全不同。把文档切成长度为 的连续 token shingle(词片):
两个集合的 Jaccard 相似度为:
令 ,,交集有 2 个、并集有 4 个,所以 。集合忽略重复次数;若频次本身重要,应使用加权 Jaccard。
05 MinHash 为什么能用短签名估计 Jaccard?#
对集合元素使用随机排列 ,第 个签名值是:
关键性质是 。若用 个排列,两个签名有 3 位相同,则估计 。标准误差约为 ,增加 才会稳定。
def minhash(shingles: set[bytes], seeds: list[int]) -> tuple[int, ...]:
    signature = []
    for seed in seeds:
        key = seed.to_bytes(8, "little")
        values = [
            int.from_bytes(
                hashlib.blake2b(item, key=key, digest_size=8).digest(), "little"
            )
            for item in shingles
        ]
        signature.append(min(values))
    return tuple(signature)

def estimate_jaccard(a: tuple[int, ...], b: tuple[int, ...]) -> float:
    assert len(a) == len(b) and a
return sum(x == y for x, y in zip(a, b)) / len(a)seeds、分词器、 和规范化版本必须固定。空文档要提前过滤,否则 min() 没有定义。
06 LSH 怎样避免所有文档两两比较?#
篇文档全比较需要 对。局部敏感哈希(Locality-Sensitive Hashing,LSH)把 个签名切成 个 band,每 band 含 行;任一 band 完全相同才成为候选。
例如 ,候选概率约 ;当 时约 。LSH 只负责召回候选,最终仍应用真实 shingle 集合计算 Jaccard。
signature [R=8]
 ├─ band0 [2] ─┐
 ├─ band1 [2] ─┼─ 同桶文档对 ─► 真实 Jaccard ─► 重复边
 ├─ band2 [2] ─┤
└─ band3 [2] ─┘07 重复关系为什么要建图?#
相似关系不一定传递: 和 都过阈值,不代表 也过阈值。常见工程做法把文档视为节点、过阈值候选视为边,再用并查集求连通分量。
每个分量只保留一个代表时,规则必须确定:依次比较质量分、正文长度、来源优先级、抓取时间和稳定 id。不要“谁先被 worker 扫到就保留谁”,否则并行度改变数据集。
08 切分与评测污染应怎样处理?#
最安全的顺序是把训练、验证、测试候选放进同一近重复图,再按优先级保留:
- 基准测试与人工保留集拥有最高保护优先级;
- 与评测集近重复的训练样本删除,而不是反过来;
- 同一重复簇不可跨 split;
- 最终只在训练 split 上拟合 tokenizer 或其他数据统计量。
若合规要求不允许跨集合读取正文,可交换不可逆指纹或 shingle 哈希,并记录覆盖率局限。
09 参数怎样选,不能只看一个阈值#
| 参数 | 过小 | 过大 | 应看什么 |
|---|---|---|---|
| shingle 长度 | 常用短语误报 | 局部改写漏报 | 文档类型分层标注 |
| 签名数 | 估计方差大 | 内存与计算增加 | 候选召回稳定性 |
| Jaccard 阈值 | 误删同主题文章 | 漏掉模板变体 | 人工 precision/recall |
| 最短正文 | 菜单模板主导 | 丢失短问答 | 长度分桶审计 |
在已标注文档对上画 precision–recall,而不是从论文复制一个 。代码、中文短文本与英文长网页通常需要不同参数。
10 分布式实现的数据契约#
输入: {doc_id, source, raw_text, crawl_time}
中间: {doc_id, norm_version, exact_key, minhash[R], quality}
删除: {removed_id, kept_id, reason, score, pipeline_version}
输出: {doc_id, source, raw_text}先按 exact key 分区,再按 LSH band key shuffle 候选。候选对要排序去重;并查集结果按稳定 id 归并。保存各阶段计数、每来源删除率及阈值附近样本,才能发现某种语言被过度删除。
11 最短验证与调试路径#
- 用 golden pairs 覆盖完全相同、空白变化、页眉变化、同主题不同事实和代码重命名;
- 打印规范化文本、shingle 交并集、MinHash 估计和最终原因码;
- 在 1%、10%、100% 数据上检查删除率是否突变;
- 比较单进程与多 worker 的保留 id 集合;
- 扫描训练集与评测集 overlap,并人工复核高分对。
| 症状 | 常见原因 | 最短检查 |
|---|---|---|
| 每次保留样本不同 | seed 或代表规则不稳定 | 固定 seed,按 id 排序 |
| 中文几乎全被判重复 | shingle 太短 | 查看真实交集片段 |
| 内存爆炸 | 热门 LSH 桶形成笛卡尔积 | 限制模板桶并分层处理 |
| 评测异常升高 | 先切分后仅在 split 内去重 | 做跨 split overlap |
| 去重后小语种骤减 | 来源本就高度镜像 | 按来源统计并重配权重 |
12 失败场景与相近方法#
MinHash 适合集合重叠,不理解语义改写;事实相同但措辞不同可能漏掉,模板相同但事实字段不同又可能误报。Embedding 相似度更擅长语义,却更昂贵且容易把同主题合法样本混为重复。后缀数组适合长公共子串;SimHash 更接近余弦式指纹;图像、音频需要模态专用感知哈希。
去重也不能修复错误事实、隐私、许可问题和来源偏差。它只是数据治理的一层,不是质量过滤的代名词。
13 今天真正需要记住什么?#
- 重复文档等于隐式提高其 token 权重,会影响泛化、记忆和评测可信度。
- 精确哈希解决字节级重复;shingle Jaccard 定义近重复;MinHash+LSH 只加速候选召回。
- 评测集应受保护,跨 split 重复必须在切分前解决。
- 规范化、seed、代表选择与删除日志都是可复现训练数据的一部分。
14 思考题与小练习#
- 对集合 与 手算 Jaccard;若 8 位 MinHash 有 5 位相同,比较估计误差。
- 固定 ,计算 的候选概率,并解释 S 曲线如何影响召回。
- 为新闻、GitHub 代码和论坛短帖各设计一条代表保留规则,说明可能引入的偏差。
相关工作#
- Broder, On the Resemblance and Containment of Documents ↗,提出用 MinHash 估计文档集合相似度。
- Lee et al., Deduplicating Training Data Makes Language Models Better ↗,系统研究语言模型训练语料去重。
- Kandpal et al., Deduplicating Training Data Mitigates Privacy Risks in Language Models ↗,分析重复、记忆与隐私风险。
- Dodge et al., Documenting Large Webtext Corpora ↗,审计大型网页语料与下游基准重叠。
15 下一篇预告#
去重后,每份来源终于不再因镜像数量获得隐式权重;但高质量小语种、代码和网页正文仍相差几个数量级。下一篇将把“数据源比例”写成明确的按 token 采样分布,并讨论温度平滑、预算与可复现批次。