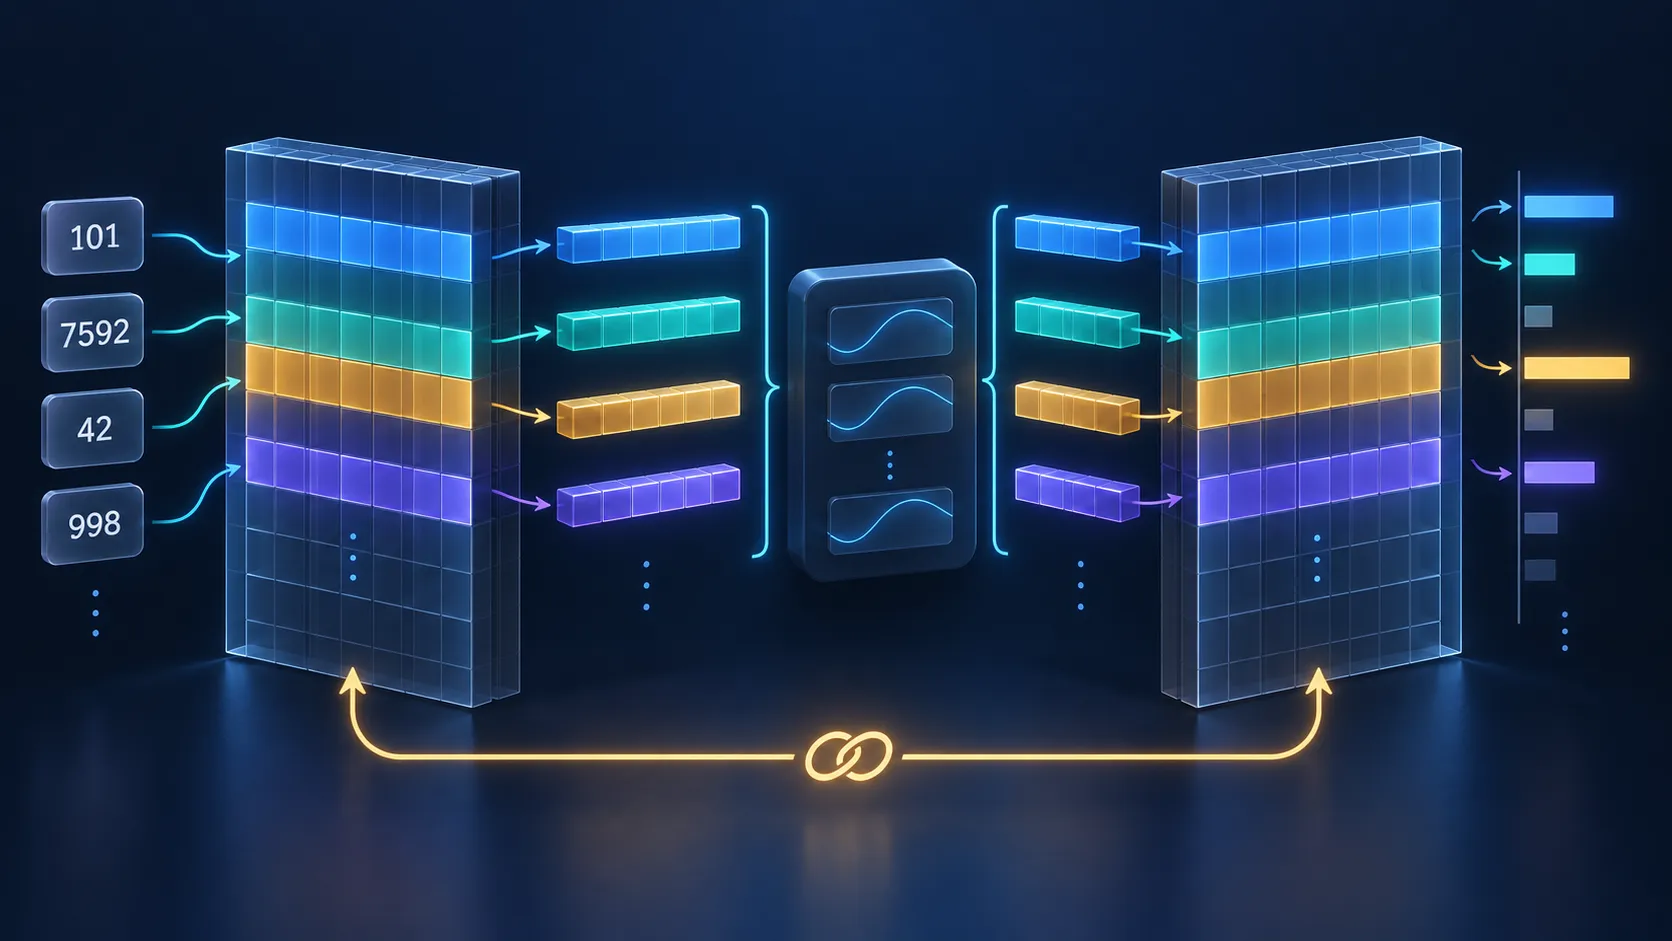
整数编号怎样变成可学习语义?Token Embedding、梯度累加与权重绑定
从 token id 的无序性出发,手算 Embedding 查表和重复行梯度,追踪 LM Head 的词表 logits,并用 PyTorch 2.14 正确实现权重绑定。
上一篇用 BPE 把开放文本切成有限词表中的整数 id。但 id 只是地址:token 7 不比 token 3 “大 4”,对编号直接做加减会把任意词表顺序误当作语义几何。模型需要把每个地址映射成可学习向量,并在输出端把隐藏状态重新与整个词表比较。
Token Embedding(词元嵌入)与语言模型输出头(Language-Model Head,LM Head)正好位于这条数据流的两端。本文只讲透三件事:查表怎样等价于 one-hot 乘矩阵、重复 token 的梯度怎样累加,以及为何输入表与输出分类器常共享同一张权重。
01 token id 为什么不能作为数值特征?#
假设词表是:
0:<pad> 1:猫 2:银行 3:跑 4:狗编号来自 tokenizer 的构建顺序,不表达距离。把 id 4 当浮点输入会暗示“狗”是“猫”的四倍,并且重排词表就改变模型函数。正确做法是用 id 选择矩阵的一行。
设词表大小 、宽度 :
,输出 。查表不会平均相邻 id,也不要求 id 连续地表达语义。
02 查表为何等价于 one-hot 矩阵乘法?#
若 id 为 2,对应 one-hot 向量 :
ids I [N,L]
   │ 每个整数选择 E 的一行
   ▼
E [V,D] ───────────────► X [N,L,D]
                         │ Transformer blocks
                         ▼
H [N,L,D]one-hot 解释清楚了数学,但生产实现不会显式构造 [N,L,V] 的零矩阵;索引读取只取需要的行。
03 用一个 4×2 表手算前向#
令:
则:
输入形状 [L]=[3],输出 [L,D]=[3,2]。批量输入 [N,L] 只是在前面再保留 batch 轴,不会把三个向量相加。
04 重复 token 的梯度流向哪一行?#
若上游对三个输出位置的梯度为:
id 1 在位置 0、2 出现,所以:
id 3 的梯度是 [3,4],未访问行梯度为 0。这是 scatter-add,而不是“后一次覆盖前一次”。高频 token 每批获得更多直接更新机会,稀有行可能长期不动。
import torch
from torch import nn

embedding = nn.Embedding(num_embeddings=4, embedding_dim=2)
with torch.no_grad():
    embedding.weight.copy_(torch.tensor([[0.,0.],[1.,0.],[0.,2.],[1.,1.]]))
ids = torch.tensor([[1, 3, 1]], dtype=torch.long)  # [N=1,L=3]
x = embedding(ids)                                # [1,3,2]
x.backward(torch.tensor([[[1.,2.],[3.,4.],[5.,6.]]]))
torch.testing.assert_close(embedding.weight.grad[1], torch.tensor([6.,8.]))05 LM Head 怎样把隐藏状态投回词表?#
Transformer 输出 。独立输出权重 与偏置 产生:
H [N,L,D] @ W_out.T [D,V] + b [V]
                         │
                         ▼
                   logits [N,L,V]
                         │ 与右移 labels [N,L] 做 CE
                         ▼
loss []logit 是兼容分数,不是概率;上一篇的 cross_entropy 会内部执行稳定的 LogSoftmax。对全部位置显式 softmax 还会产生额外内存。
06 为什么输入与输出能共享同一张表?#
权重绑定(Weight Tying)令:
同一行 有两个角色:输入中出现 token 时,它被取出;输出预测时,它作为“候选 token ”的方向与所有隐藏状态比较。
                    ┌──────── E[v,:] ◄──── input id v
                    │             │
所有 ids ─ lookup ──┘             │ 同一 Parameter
                                  ▼
hidden h ─────────────────── dot(E[v,:]) ─► logit_v不绑定时输入、输出两表共 个参数;绑定后是 ,偏置另计。例如 、float16 权重时,一张表约 390.6 MiB,绑定可少一张同尺寸参数表;训练中的梯度和优化器状态节省更大。
绑定也施加归纳偏置:适合“读入 token 的几何”也用于“判断下一个 token”。它减少自由度,不保证所有架构或跨词表 Encoder–Decoder 都更好。
07 绑定后梯度为何来自两条路径?#
对共享行 :
输入项只来自 batch 中实际出现的 ;输出项来自每个有效位置的 类交叉熵,因为即使 不是目标,其预测概率也影响梯度。这意味着绑定后“未作为输入出现的行”仍可能通过输出端更新。
08 用 PyTorch 2.14 正确实现#
PyTorch 2.14 官方 nn.Embedding(num_embeddings, embedding_dim, padding_idx=...) 接受任意形状整数索引,并在末尾追加 embedding_dim。padding_idx 行默认不从Embedding 查表路径获得梯度。
import torch.nn.functional as F

class TiedTokenIO(nn.Module):
    def __init__(self, vocab_size: int, d_model: int, pad_id: int):
        super().__init__()
        self.token_embedding = nn.Embedding(vocab_size, d_model, padding_idx=pad_id)
        self.lm_head = nn.Linear(d_model, vocab_size, bias=False)
        self.lm_head.weight = self.token_embedding.weight  # 同一个 Parameter

    def forward(self, input_ids, hidden_fn):
        x = self.token_embedding(input_ids)  # [N,L,D]
        hidden = hidden_fn(x)                # [N,L,D]
        return self.lm_head(hidden)           # [N,L,V]

model = TiedTokenIO(vocab_size=32_000, d_model=768, pad_id=0)
assert model.lm_head.weight is model.token_embedding.weight
assert model.token_embedding.weight.shape == (32_000, 768)先初始化再绑定,避免后续分别初始化两个模块而意外改写共享参数。建立 optimizer 前完成绑定,并用对象身份和 data_ptr() 检查,不要只比较数值相等。
09 一个完整训练步怎样检查?#
ids = torch.tensor([[2, 7, 9, 0]], dtype=torch.long)  # [N,L]
labels = ids.clone()
labels[ids == 0] = -100
logits = model(ids, transformer)                       # [N,L,V]
loss = F.cross_entropy(
    logits[:, :-1].reshape(-1, logits.size(-1)),
    labels[:, 1:].reshape(-1),
    ignore_index=-100,
)
optimizer.zero_grad(set_to_none=True)
loss.backward()
assert model.token_embedding.weight.grad is model.lm_head.weight.grad
optimizer.step()检查 id 范围、dtype、形状与右移方向。若 max(input_ids) >= V,错误在 tokenizer—checkpoint 契约,不该用取模“修复”。
10 padding_idx、稀疏梯度和 max_norm 的边界#
padding_idx适合让 padding 查表向量稳定,但 attention mask 与 loss mask 仍不可省;sparse=True可让查表梯度稀疏,但只有部分 optimizer 支持,而且绑定到稠密 LM Head 后输出路径本来就是稠密的;max_norm会在 forward 中原地重整被访问行。若 forward 前还对weight做可微操作,可能触发 autograd 版本错误;- 重复 id 的梯度会累加,分布式训练中还要确认稀疏参数通信方案。
权重绑定的大型语言模型通常使用稠密梯度;不要因为“Embedding 是查表”就默认 sparse=True 一定省总成本。
11 tokenizer 与模型怎样一起扩词表?#
增加特殊 token 不是只在 tokenizer 末尾追加字符串。若旧词表 扩到 :
- 固定旧 token 的 id,不要重排;
- 把 扩成
[V+k,D]; - 初始化新增行并保持 LM Head 绑定;
- 更新配置中的
vocab_size与特殊 id; - 检查 checkpoint 加载缺失行、optimizer state 与服务端 tokenizer 哈希。
随机新行一开始既不会正确读入新 token,也不会正确输出它。应给新增 token 足够训练数据,或用组成它的旧子词向量初始化,再验证实际收益。
12 常见错误与最短调试路径#
| 症状 | 常见原因 | 最短检查 |
|---|---|---|
index out of range | tokenizer 大于模型词表 | 打印 min/max id 与权重形状 |
| 参数量没有减少 | 复制了数值而非共享 Parameter | 比较 is 与 data_ptr() |
| 两表训练后不再相等 | 绑定发生在 optimizer 之后 | 检查参数列表中的对象身份 |
| PAD 行仍变化 | 绑定后的输出梯度 | 分开记录输入/输出梯度贡献 |
| 稀有 token 几乎不学习 | 数据频次低、切分过细 | 统计每行访问数与梯度范数 |
| logits 显存爆炸 | [N,L,V] 过大 | 分块 loss 或词表并行分析 |
| 换 tokenizer 后语义崩坏 | 相同 id 指向不同 token | 比对 tokenizer 哈希和映射 |
13 失败场景与相近表示#
静态 token 行并不等于上下文语义:“银行”的输入行固定,但 Transformer 后的 hidden 会随“河岸/金融”上下文变化。Embedding 也无法自动处理 tokenizer 切得过碎、训练语料偏差或新 token 数据不足。
One-hot 没有学习参数且维度为 ;Embedding 是其低维可学习投影。位置表示表达顺序而非 token 身份。预训练词向量可初始化表,却未必匹配新 tokenizer。Adaptive Softmax、采样 softmax 或词表并行主要缓解大 输出成本,不等同于输入查表,也不必与权重绑定同时使用。
14 今天真正需要记住什么?#
- token id 是地址;
E[I]把[N,L]变成[N,L,D],数学上等价于 one-hot 乘表。 - 重复 id 对同一行的梯度做加法累积,未访问行在纯输入路径上为零。
- LM Head 用
[V,D]权重把 hidden 投到词表 logits;权重绑定令它与输入表共享 Parameter。 - 绑定节省 参数并让一行同时学习“怎样读”和“怎样被预测”,也带来 PAD 梯度与版本契约等工程细节。
15 思考题与小练习#
- 对 id
[2,2,3]和三个二维上游梯度,手算完整[V,D]梯度,并用nn.Embedding验证。 - 取 的共享表和一个 hidden,手算四个 logits、softmax 与目标 token 的交叉熵梯度。
- 比较 、 时绑定前后的参数、BF16 权重和 Adam 状态内存。
相关工作#
- Bengio et al., A Neural Probabilistic Language Model ↗,以可学习分布式词表示构造神经语言模型。
- Mikolov et al., Efficient Estimation of Word Representations in Vector Space ↗,高效学习词向量。
- Press & Wolf, Using the Output Embedding to Improve Language Models ↗,系统研究输出表示与权重绑定。
- Inan et al., Tying Word Vectors and Word Classifiers ↗,从损失框架解释输入输出共享。
- Grave et al., Efficient Softmax Approximation for GPUs ↗,面向大词表的 Adaptive Softmax。
16 下一篇预告#
现在文本已经经历 tokenizer、Embedding、Transformer 与 LM Head,形成完整 next-token 训练闭环。但不同来源语料该按什么比例进入训练、重复样本为何会造成记忆与评测污染,仍决定模型究竟学到什么。下一篇将研究预训练数据去重、数据混合权重与按 token 采样。