门槛附近分数突然堆积,断点设计还能信吗?密度检验与操纵诊断
从阈值两侧的运行变量密度跳跃解释排序检验,手算局部比例差并用 rddensity 检验与绘图。
上一篇解释了连续性断点设计为何要同时校正局部曲率偏差和标准误。再往前一步:如果考生、学校或平台能影响运行变量落在门槛哪一边,阈值两侧的对象可能不再近似可比。一个可检验的信号是运行变量在断点处的密度是否跳跃。本篇讲清密度检验能诊断什么,以及为什么“不显著”不是操纵不存在的证明;下一篇将把这些诊断放回 RDD 设计清单,讨论预定协变量连续性与图形证据如何组合。
01 排序为什么会破坏断点附近的可比性?#
令运行变量(running variable)为考试分数 ,制度门槛为 ,中心化分数为 。处理资格由 决定。如果学校得知阈值后能精确改分,临界线右侧的人可能更有资源、更积极或本来就更有利。即便结果曲线看起来平滑,阈值两侧的组成也可能不同。
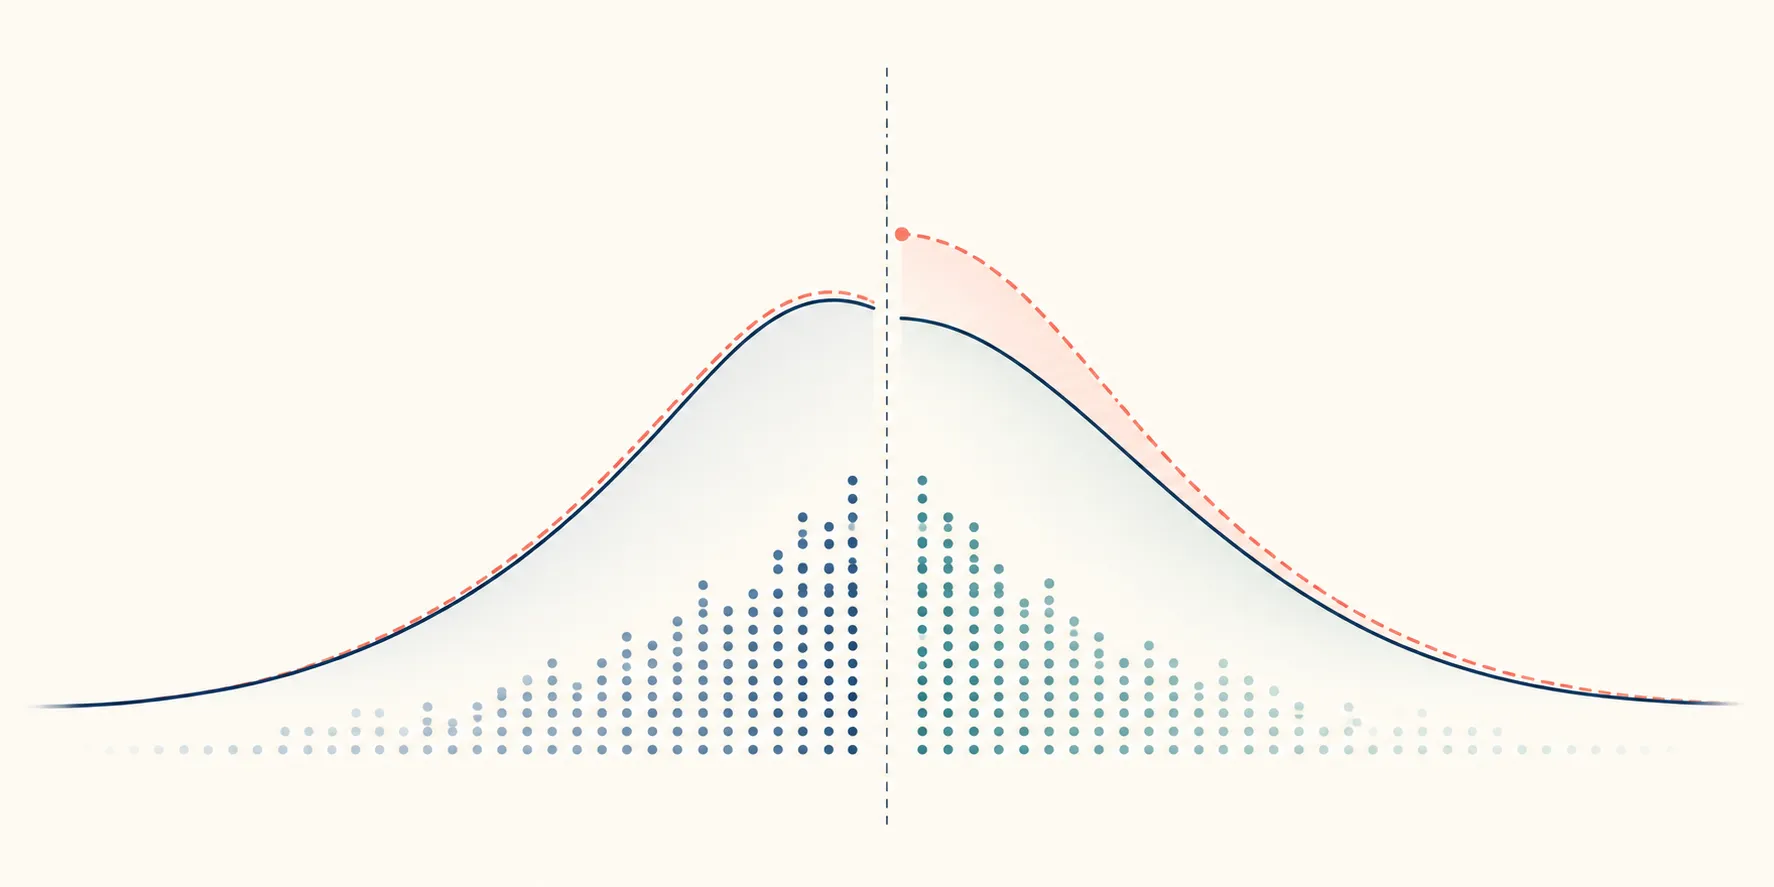
**密度不连续检验(density discontinuity test)**把注意力转向运行变量本身:比较阈值左、右的密度极限
直觉是:若单位不能精确选择门槛哪侧,阈值附近的运行变量分布不应在 突然多出一堆样本。但这个检验是排序/操纵的诊断,不直接估计处理效果,也不证明 RDD 的全部识别假设。
flowchart LR
  A[收集全部运行变量 X] --> B[固定制度阈值 c 与单位]
  B --> C[画直方图与局部密度曲线]
  C --> D[选局部带宽 h 并估 f(c-)、f(c+)]
  D --> E[偏差校正差值与稳健检验]
  E --> F{证据是否显示密度跳跃?}
  F -->|是| G[核查改分规则、取整、排序与数据流程]
  F -->|否| H[仍检查检验功效、质量点和其他协变量]
  G --> I[结合制度证据判断 RDD 可信度]
H --> I02 手算:局部两侧人数比例差#
设门槛为 70 分,在一个事先确定的对称小窗口 中观察 20 名考生:6 人位于门槛左侧,14 人位于右侧。若在这个窗口内把每个人落在左右侧的概率都近似为 ,则单侧比例估计为 ,与 0.5 相差 0.20。双侧二项检验会把“右侧至少 14 人”与“左侧至少 14 人”两端概率相加;对 ,约为 0.115。
这一步只是极小样本的直观筛查,不等于正式的密度断点估计。等宽窗口内样本比率不一定能区分“密度在阈值的极限跳跃”和“窗口内密度平缓变化”;窗口边界、取整和分数并列也会影响计数。正式检验会在阈值两侧局部估计密度曲线并对差值作偏差校正。若换一个窗口后 p 值大幅变化,应把这种敏感性报告出来,而非挑最小的那个。
| 观察到的现象 | 直观解释 | 下一步 |
|---|---|---|
| 右侧人数明显更多 | 可能有向上跨线的排序 | 查资格规则、改分权限与门槛信息何时公开 |
| 左右人数接近 | 没观察到明显堆积 | 检查功效、分数精度、其他协变量与制度材料 |
| 阈值处大量相同分数 | 运行变量存在质量点 | 不能把重复取值误当连续支撑;报告唯一分数数目 |
03 用 rddensity:估密度差、偏差校正检验并画图#
维护中的 rddensity 项目提供 Python、R、Stata 版本。Python API 的三个入口分别是 rddensity(密度不连续检验)、rdbwdensity(数据驱动带宽)和 rdplotdensity(密度图)。假设 df["score"] 是全部受规则影响与未受影响的分数,输入 是长度 的一维向量;阈值 必须与分数使用相同单位。
import numpy as np
import rddensity

X = df["score"].to_numpy(dtype=float)  # shape=(n,)
c = 70.0

# 检验默认包含偏差校正统计量;useall=True 也列出常规统计量供对照。
fit = rddensity.rddensity(X=X, c=c, useall=True)
print("density limits and difference:")
print(fit.hat)        # left, right, diff
print("robust test:")
print(fit.test)       # t_asy/t_jk, p_asy/p_jk
print("bandwidths:")
print(fit.h)          # left/right; may differ by side
print("local sample sizes:")
print(fit.n)           # full, left, right, eff_left, eff_right

# binomial windows are a complementary diagnostic, not the same test.
print(fit.bino)        # window lengths, side counts, binomial p-values

# 官方绘图接口基于同一个估计对象与运行变量。
density_plot = rddensity.rdplotdensity(fit, X=X)
print(density_plot)fit.hat["diff"] 是估计的右减左密度差,fit.test["p_jk"] 是基于 jackknife 标准误的偏差校正检验 p 值;p_asy 使用渐近 plug-in 标准误。默认局部密度估计阶数 ,默认核为三角核,默认带宽由 rdbwdensity 选择;左右带宽可以不同。fit.n 的 eff_left 与 eff_right 是局部窗口有效样本量,不等于全样本左右人数。重复运行变量值会被识别并触发质量点调整;不要把它当作无害的打印提示。
useall=True 会额外给出未校正的常规统计量,但当带宽按 MSE 规则选择时,常规检验可能不具有效覆盖性质;主要报告应使用 robust bias-corrected 结果。默认 bino_flag=True 也提供一组嵌套窗口的二项检验。它以窗口内左右概率为检验对象,是补充诊断,不应与局部多项式密度差 p 值混成一个结论。当前参数名、默认值和返回字段可在 官方 Python 源码 ↗ 与 官方示例 ↗核对。
04 检验显著,是否就能断定有人操纵?#
不能。密度跳跃和策略性操纵相容,但也可能来自其他过程:分数只记录整数导致阈值堆积;数据清洗或去重规则在两侧不同;阈值是事后才确定;制度规则造成分值离散;多个阈值或样本窗口被反复搜索。先查数据生成与制度流程,再解释统计量。
反过来,不拒绝密度连续也不等于证明没有操纵。检验可能因为样本少、运行变量离散、阈值附近独立取值太少或操纵幅度很小而功效不足。更隐蔽的是,单位可能根据未观测收益做排序,但总体密度变化不明显。因此要联合查看密度图、唯一取值数、分数取整规则、预定协变量在阈值处的跳跃,以及实际改分/审核流程。
| 结果或数据问题 | 能说明什么 | 不能推出什么 |
|---|---|---|
| robust 密度检验显著 | 观察到与连续密度不一致相冲突的证据 | 不能单凭它确定是哪种操纵、谁操纵或效果偏差方向 |
| p 值不显著 | 在当前样本、带宽与检验下证据不足 | 不能证明排序不存在或识别假设成立 |
| 直方图看起来平滑 | 粗分箱未展示明显跳跃 | 不能替代局部带宽选择和稳健推断 |
| 预定协变量也在阈值跳跃 | 可比性存在额外疑点 | 单项协变量检验也可能受多重搜索影响 |
如果阈值处确有确定性离散规则(如考试成绩取整),连续密度模型可能不适合当前运行变量。可以报告有限窗口的计数与分配机制、重新定义更精确的运行变量,或考虑上一课介绍的局部随机化框架;不能靠关闭质量点调整来“修复”数据。
键盘可展开:密度检验的提交前清单
用 Tab 聚焦摘要,按 Enter 或 Space 展开。确认全体候选样本进入了分数分布;阈值与分数单位无误;主结论取 robust bias-corrected 行;图中标出断点和左右带宽;报告唯一运行变量值与质量点;核查分数取整、人工调整和政策时间线;把“不显著”表述为证据不足,而不是无操纵证明。页面可窄屏阅读,并沿用站点深浅主题。
思考练习#
- 对称窗口内 20 人有 14 人位于门槛右侧,二项检验的零假设是什么?为什么这个 p 值不能直接替代局部密度差检验?
- 密度检验不显著,但分数只保留整数且阈值附近只有 3 个不同取值。你会怎样评价连续性近似与检验功效?
- 分数密度在阈值处显著下降,同时学校在当年更换了评分软件。列出两种可能机制,并说明需要哪些流程数据区分它们。
延伸阅读#
- McCrary (2008), Manipulation of the Running Variable in the Regression Discontinuity Design: A Density Test ↗ — 经典密度检验。
- Cattaneo, Jansson & Ma (2018), Manipulation Testing based on Density Discontinuity ↗ — 局部多项式密度不连续检验与软件实现。
- Cattaneo, Jansson & Ma (2020), Simple Local Polynomial Density Estimators ↗ — 局部多项式密度估计。
- Cattaneo, Jansson & Ma (2022), lpdensity: Local Polynomial Density Estimation and Inference ↗ — 密度估计、推断和绘图工具。
- Cattaneo, Frandsen & Titiunik (2015), Randomization Inference in the Regression Discontinuity Design ↗ — 局部窗口与二项随机化诊断的相关背景。
上一课处理“局部曲率会怎样扭曲断点区间”;本课处理“运行变量本身在阈值处是否异常”。密度检验提供可观测的排序线索,但因果结论仍要由制度证据、结果连续性和稳健推断共同支撑。