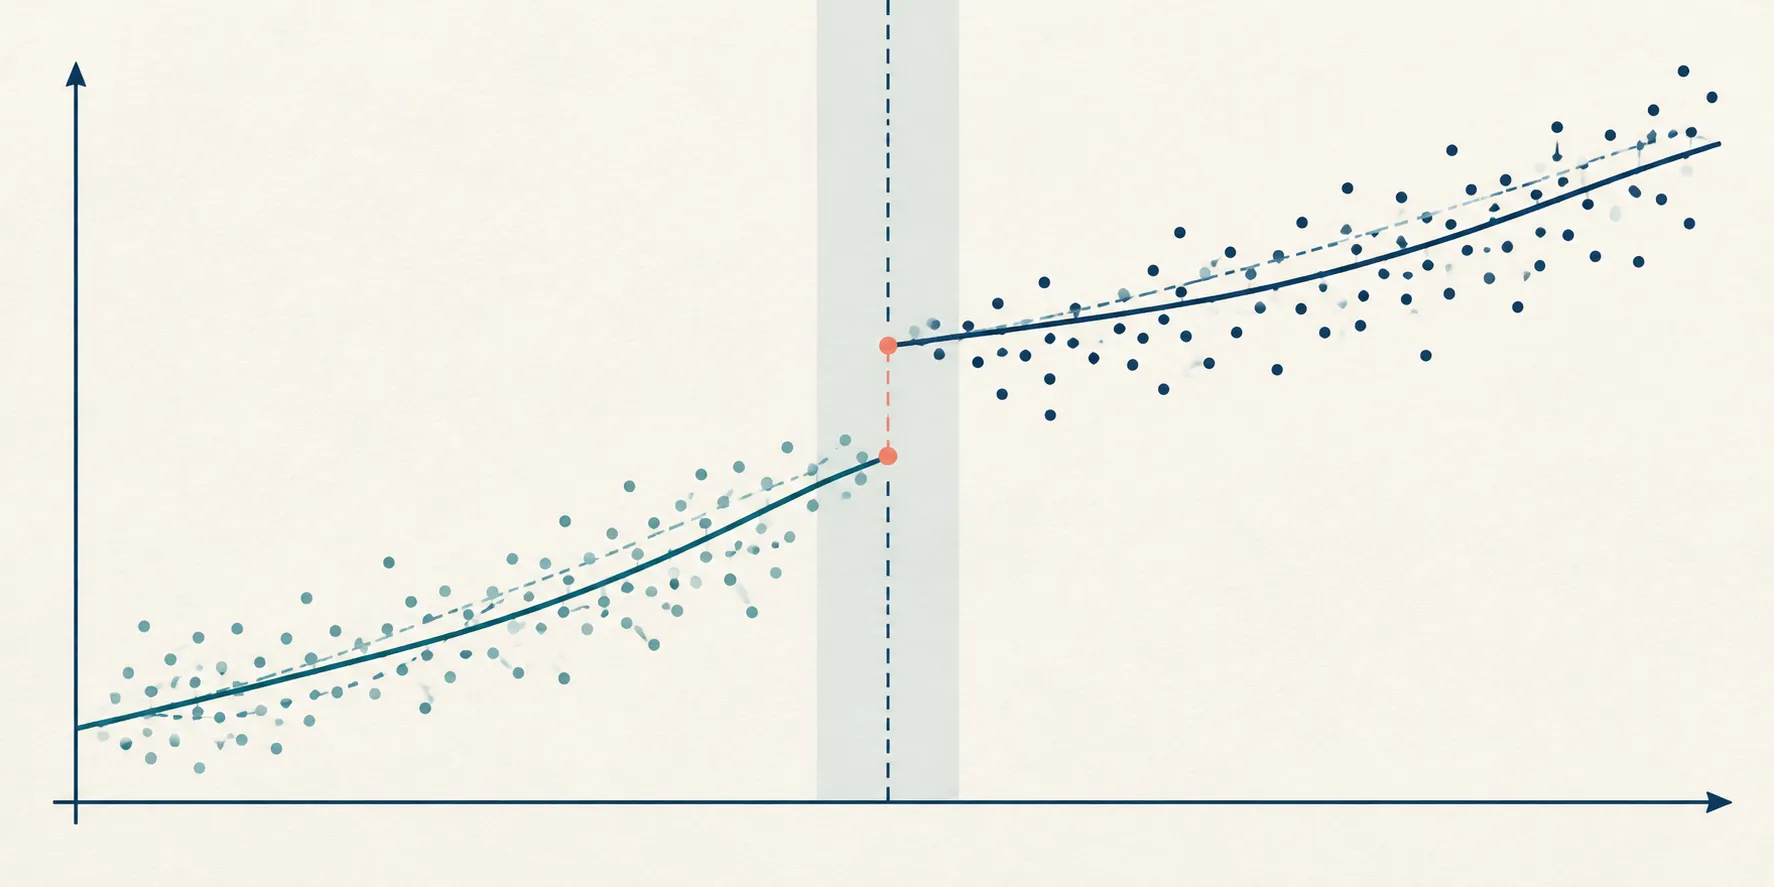
带宽越大样本越多,断点区间为何反而会失真?偏差校正与稳健推断
从局部线性回归的曲率偏差出发,推导回归断点的偏差校正与稳健标准误,并用 rdrobust 读取带宽和置信区间。
上一篇区分了断点附近的连续性推断与局部随机化推断。本篇沿连续性这条线继续追问:局部线性回归在阈值处估出的跳跃,为什么不能直接套一个普通标准误?带宽越宽,点越多、方差通常越小;但曲线在窗口内弯得越明显,直线近似的偏差也会变大。若偏差与标准误同量级,常规置信区间即使计算无误,也可能覆盖不到真实效应。下一篇将转向一个重要前提检查:运行变量在阈值附近是否出现异常堆积,以及密度检验能说明什么。
01 直线拟合为什么会偏?#
设运行变量以阈值为中心,;结果为 ,样本量为 。sharp 断点效应是两侧条件期望在 处的跳跃。**局部线性回归(local linear regression)**分别在左右窗口拟合直线,只把离阈值近的观测用于外推。每侧设计矩阵一行是 ,系数是截距和斜率,最后相减两侧截距。
带宽 决定纳入哪些观测以及核权重。局部线性主估计可写作
若真实趋势有曲率,局部直线不能完全复现曲线。对 ,主估计的领先偏差通常随 缩小,而方差大致随 缩小。带宽缩小会减少曲率偏差,却留下更少样本;带宽放大增加样本,却让直线拟合承担更大的弯曲误差。这是偏差—方差权衡(bias–variance trade-off),不能只看有效样本数决定 。
flowchart LR
  A[原始运行变量 R 与结果 Y] --> B[只看阈值附近的局部窗口 h]
  B --> C[左右分别拟合 p=1 局部线性]
  C --> D[原始跳跃 τ̂(h)]
  B --> E[q=2 局部多项式估计曲率偏差]
  E --> F[估计偏差 B̂(h,b)]
  D --> G[偏差校正 τ̂bc = τ̂ − B̂]
  F --> G
  G --> H[稳健标准误:含偏差估计的不确定性]
H --> I[稳健置信区间]02 偏差校正为什么还要换标准误?#
**稳健偏差校正(robust bias correction,RBC)**先用更高阶局部多项式估计主估计的领先偏差,再从主估计中扣除它。常见设置是主多项式阶数 、偏差估计阶数 :主回归仍是左右局部直线,额外的局部二次项用于估计曲率造成的偏移。偏差估计带宽记为 ,可以和主估计带宽 不同。
但 也是从样本估出来的随机量。若仍拿 的普通标准误配校正后的中心,就漏掉偏差估计的波动,也漏掉两项之间的协方差。RBC 标准误直接估计校正后线性组合的方差:
因此最终区间以校正后的跳跃为中心,使用 RBC 标准误:
它不是“把曲线拟合得更复杂后,普通区间自然就好了”。偏差校正和标准误修正是一对:前者移动中心,后者承认这个移动量本身也有不确定性。
03 手算一遍:中心移动,区间也变宽#
以下数字是为展示计算步骤而刻意设定的一组教学输出,不是一份实证数据。假设左右局部线性截距之差为 ;局部二次拟合估出的右侧偏差减左侧偏差为 ;普通标准误为 ,RBC 标准误为 。那么
用 作近似 95% 临界值,常规区间为 ;RBC 区间为 。这个例子不表示实际区间一定更宽或一定移向零;它展示两件不能混淆的事:校正项会改变中心,校正估计的不确定性会改变区间宽度。真实应用中,两种区间都由数据和方差估计共同决定。
04 用 rdrobust:把带宽选择、估计与区间读出来#
官方 rdrobust 项目同时提供 Python、R 和 Stata 实现;Python 入口包括 rdbwselect(选择带宽)、rdrobust(局部多项式估计与偏差校正推断)和 rdplot(探索性分箱图)。下面假设 df 已有 score 与 outcome 两列:输入各是一维、等长观测向量,输出对象保存左右带宽、估计表、标准误表、p 值和三类区间。p=1, q=2 明确指定局部线性主估计与局部二次偏差估计;三角核会降低窗口边缘点的权重。
import numpy as np
from rdrobust import rdbwselect, rdrobust

# 两个输入都是 shape=(n,);阈值 c 必须使用 score 的原始单位。
R = df["score"].to_numpy(dtype=float)
Y = df["outcome"].to_numpy(dtype=float)
c = 70.0

# 先显式查看数据驱动带宽。mserd 是 RD 跳跃的 MSE 最优方案。
bw = rdbwselect(y=Y, x=R, c=c, p=1, q=2,
                bwselect="mserd", all=True)
print(bw.bws)  # 每种选择器对应左右 h 与偏差带宽 b

# 同一套选择规则用于点估计和推断。
fit = rdrobust(y=Y, x=R, c=c, p=1, q=2,
               bwselect="mserd", all=True)
print(fit.Estimate)  # tau.us, tau.bc, se.us, se.rb
print(fit.bws)       # 行 h、b;左右列分别给出带宽
print(fit.ci)        # Conventional / Bias-Corrected / Robust
print(fit.pv)        # 第三行对应 Robust p-value

# 对主要报告值做显式命名,避免误把常规区间当作 RBC 区间。
tau_bc = float(fit.Estimate["tau.bc"].iloc[0])
se_rb = float(fit.Estimate["se.rb"].iloc[0])
ci_rb = fit.ci.iloc[2].to_numpy(dtype=float)  # [lower, upper]
print({"tau_bc": tau_bc, "se_rb": se_rb,
"robust_95_ci": ci_rb.tolist()})Estimate 中 tau.us 是未校正点估计,tau.bc 是偏差校正点估计,se.us 是常规标准误,se.rb 是 RBC 标准误。ci 与 pv 的第三行是 robust 结果;第一行 conventional、第二行 bias-corrected 使用常规标准误,不能只因为第二行名字带 “Bias-Corrected” 就把它当最终稳健区间。bws 记录左右两侧的 与 ;不对称的左右带宽并非错误,数据密度或曲率可以不同。
带宽选择器也对应不同目标。mserd 针对点估计的均方误差(Mean Squared Error,MSE);cerrd 则针对置信区间覆盖误差率(Coverage Error Rate,CER)优化。研究问题若重点是区间覆盖,应说明为何采用 CER 选择器;不要把自动选出的数字当成免解释的唯一答案。二者都不能取代制度设计、操纵诊断与敏感性分析。
05 哪些检查能发现用错了推断?#
| 现象 | 先检查 | 可能的问题 |
|---|---|---|
只报告 tau.us 和 se.us | tau.bc、se.rb、ci 第三行 | 用常规区间忽略曲率偏差 |
| 带宽稍变,估计符号就翻转 | 预先说明一组邻近带宽并报告曲线 | 局部模型对窗口敏感,单点结果不稳 |
| 阈值两侧有效样本数悬殊 | N_h、唯一运行变量值和左右带宽 | 离散分数或质量点使近似脆弱 |
| 数据在门槛处大量重复 | masspoints 诊断、分数精度和制度规则 | 公式把大量并列分数当成连续支撑 |
| 同一学校/城市内误差相关 | 设计的随机化或抽样层级 | 应考虑聚类方差;普通异方差稳健 SE 不够 |
局部多项式推断依赖阈值附近有足够的运行变量支撑。分数被取整、阈值点重复很多或某侧观测稀疏时,软件能返回数字并不代表连续近似可信。若处理是在学校或城市层级决定,方差也要尊重该分配/抽样层级;不能把个体记录数量直接等同于独立样本数。模糊断点还需要单独核对第一阶段及比率推断,不能拿 sharp RDD 的结果行代替。
与上一节的局部随机化不同,RBC 仍处在连续性框架:它改进局部多项式的偏差与区间覆盖,不会把阈值附近的数据变成随机分配。与高阶全局多项式不同,它只在阈值两侧局部拟合,窗口外远端观测不会决定阈值处曲线形状。
键盘可展开:结果表提交前核对
用 Tab 聚焦摘要,按 Enter 或 Space 展开。确认阈值与单位正确;主阶数 p 和偏差阶数 q 已报告;区间取 fit.ci 的 Robust 行;同时保留左右 h、b、带宽敏感性、唯一分数数目与处理分配层级。窄屏下可直接点按,原生 details 会随站点深浅色主题显示。
思考练习#
- ,偏差估计 。校正点估计是多少?为什么还不能沿用原标准误?
- 若使用更宽 后标准误下降、RBC 点估计却移动,应该如何报告这种权衡,才不变成挑显著性?
- 当运行变量只记录整数分数、阈值两侧都有大量重复值时,哪些连续性近似和方差计算需要额外审查?
延伸阅读#
- Calonico, Cattaneo & Titiunik (2014), Robust Nonparametric Confidence Intervals for Regression-Discontinuity Designs ↗ — 提出断点设计中的稳健偏差校正区间。
- Calonico, Cattaneo & Farrell (2018), On the Effect of Bias Estimation on Coverage Accuracy in Nonparametric Inference ↗ — 分析偏差估计对覆盖率的影响。
- Calonico, Cattaneo & Farrell (2020), Optimal Bandwidth Choice for Robust Bias Corrected Inference in Regression Discontinuity Designs ↗ — 讨论覆盖误差率最优带宽。
- Calonico, Cattaneo & Titiunik (2015), rdrobust: An R Package for Robust Nonparametric Inference in Regression-Discontinuity Designs ↗ — 软件实现与分析流程。
- rdpackages/rdrobust 官方项目与 Python 示例 ↗ —
rdrobust、rdbwselect、rdplot当前用法。
上一篇用有限窗口和可辩护的局部随机化分配做置换推断;本篇回到连续性假设,解释平滑偏差如何改变标准误与区间。下一篇将检查运行变量密度是否在门槛处异常变化,并说明密度检验的解释边界。