阈值附近的 8 名学生能当作一次小型随机试验吗?局部随机化推断
在明确局部随机化假设和窗口后,用穷举置换手算断点附近的精确检验,并辨析它与连续性 RDD 的区别。
上一篇把阈值资格当作工具变量,估计模糊断点的服从者局部效应。本篇讨论断点设计的另一种推断框架:如果能为阈值附近一个有限窗口辩护“处理标签在窗口内近似随机”,可以像小型随机试验那样枚举分配、做精确随机化检验。它需要比“潜在结果在阈值处连续”更强且不同的假设,不能因为样本靠近断点就自动成立。
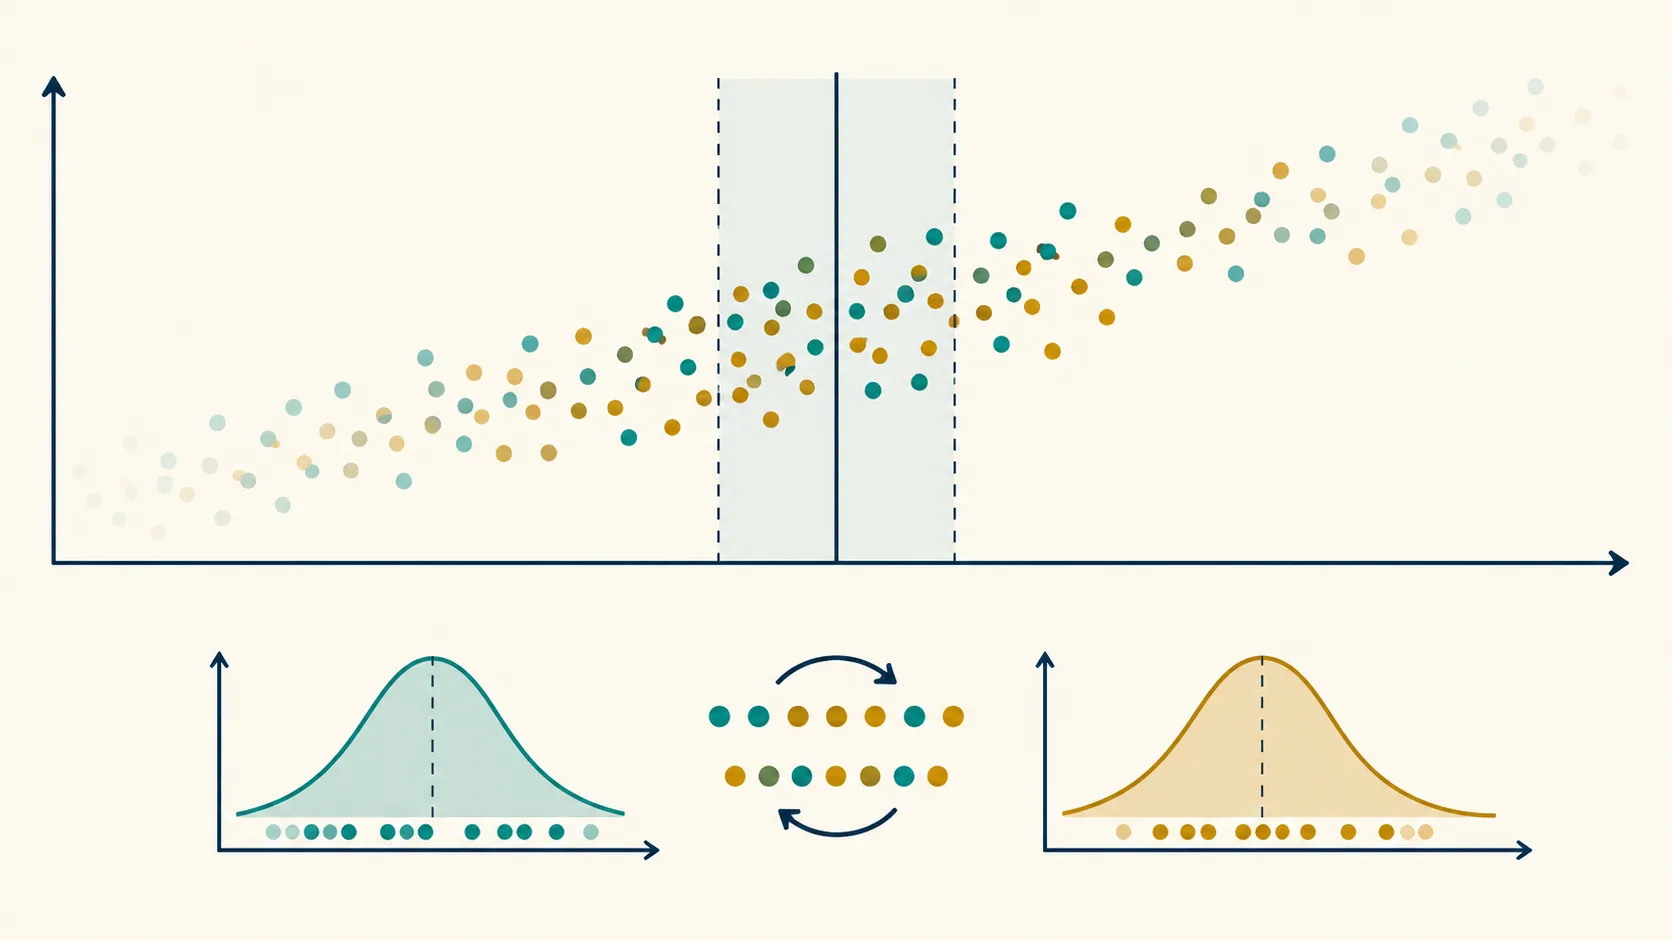
假设分数线为 ,处理由 决定。连续性框架用阈值两侧局部趋势外推;局部随机化(local randomization)框架则先定义窗口 ,再把窗口内观测视为满足某个分配机制的有限样本实验。设计可信度来自该窗口内可辩护的可交换性与平衡证据,不是置换程序本身。
flowchart LR
  A[先选阈值窗口 W] --> B[检查预定协变量平衡与样本数]
  B --> C{局部随机化假设可辩护?}
  C -->|否| D[回到连续性/局部多项式框架]
  C -->|是| E[固定处理人数,枚举允许分配]
  E --> F[每种分配重算均值差]
  F --> G[观察统计量在随机化分布中的尾部比例]
G --> H[报告精确检验及窗口敏感性]01 连续性框架与局部随机化不是同一套假设#
**连续性框架(continuity framework)**只要求无处理潜在结果的条件期望在阈值处平滑,通过左右极限差识别局部效应,再用局部多项式和带宽控制近似误差。上一篇的 sharp/fuzzy RDD 都沿这一视角解释。
局部随机化框架把窗口内单位看成一个有限总体,并声明处理标签按已知或可辩护的机制分配;常见教学简化是固定窗口内处理人数 ,在全部 种标签组合中等概率分配。运行变量阈值仍定义谁在处理侧,但“分数落在两侧的排列对潜在结果可交换”是额外实质假设。若某校能精确操纵临界分数,或临界线上下学生已系统不同,置换检验无法补救。
两种框架可以互相参照,但不能把局部随机化解释成“RDD 就是随机试验”。局部窗口选择本身也要预先说明依据:制度粒度、协变量平衡和对不同窗口的敏感性。不能不断缩小或扩大窗口,直到 。
02 手算:8 人中 4 人获资格,共有 70 种分配#
取阈值附近 8 名学生,4 人分数在线上、4 人在线下。窗口固定后观察到的成绩如下:
| 学生 | A | B | C | D | E | F | G | H |
|---|---|---|---|---|---|---|---|---|
| 结果分数 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 实际资格 | 0 | 0 | 0 | 0 | 1 | 1 | 1 | 1 |
处理侧均值为 10.5,对照侧均值为 6.5,观察差值 。若在局部随机化假设下固定 4 个处理名额,所有允许分配数为
每一种分配都重新算“被分到处理的 4 人均值 − 其余 4 人均值”。Fisher 尖锐零假设(sharp null)说每个人的处理效果都为 0;在此零假设下观测结果不变,精确双侧 值是满足 的允许分配比例。本例只有 2 种分配达到或超过 4,因此 。离散分配造成 值刻度不连续,因此小样本中可能出现的最小 值并不任意接近 0。
03 穷举置换的纯 Python 实现#
下面代码不调用黑盒检验。outcomes 是窗口内长度 的固定结果 [n],treated_count=m,observed_treated 是实际处理索引 [m]。每一种组合是一个候选标签向量 [n];返回观测均值差、允许分配数、极端分配数与双侧精确 值。它检验 sharp null,假定所有大小为 的分配等概率。
from itertools import combinations
from math import fsum

def mean_difference(values, treated_indices):
    treated_set = set(treated_indices)
    treated = [v for i, v in enumerate(values) if i in treated_set]
    control = [v for i, v in enumerate(values) if i not in treated_set]
    if not treated or not control:
        raise ValueError("处理组和对照组都必须非空")
    return fsum(treated)/len(treated) - fsum(control)/len(control)

def local_randomization_test(outcomes, observed_treated):
    n, m = len(outcomes), len(observed_treated)
    if n < 2 or not 0 < m < n:
        raise ValueError("需要非空窗口以及两组样本")
    if len(set(observed_treated)) != m or any(i < 0 or i >= n for i in observed_treated):
        raise ValueError("处理索引必须互异且位于 0..n-1")

    observed = mean_difference(outcomes, observed_treated)
    assignments = combinations(range(n), m)
    total = extreme = 0
    for assignment in assignments:
        statistic = mean_difference(outcomes, assignment)
        total += 1
        if abs(statistic) >= abs(observed) - 1e-12:
            extreme += 1
    return {"observed_difference": observed,
            "valid_assignments": total,
            "extreme_assignments": extreme,
            "two_sided_exact_p": extreme / total}

scores = [5, 6, 7, 8, 9, 10, 11, 12]
print(local_randomization_test(scores, [4, 5, 6, 7]))
# valid_assignments = 70; p-value is computed from all 70 allocations每次循环生成一个长度 的组合,并按索引分组算均值,故枚举复杂度约为 ;窗口稍大组合数就会爆炸。此教学实现适合很小的有限窗口;大窗口要用经过验证的专业实现或抽样近似,并准确记录其抽样误差。若实际分配机制不是固定人数等概率,例如分层配额或不等概率,枚举集合和权重就必须照真实机制改写。
04 精确检验能说什么,不能说什么?#
精确指的是:给定局部随机化分配机制、固定窗口与 Fisher sharp null,参考分布通过有限枚举得到,不依赖大样本正态近似。它不代表窗口选择没有偏差,也不自动检验平均效应为零。若效果因人而异,sharp null 与“平均处理效应为零”不是同一个假设;后者需要额外的估计量和推断构造。反演一系列常数加性效应检验可以构造区间,但解释仍依赖该效应模型。
窗口边界会改变样本、可比性和可检测效果。至少应预先列出一个主窗口及少量有设计理由的邻近窗口,报告每窗的 (n,m)、分配机制、协变量平衡、效应估计和检验结果。一个窄窗口虽可提高局部可比性,却可能只有少数允许分配、统计功效低;很宽窗口增加组合数与样本量,也更难辩护“局部可交换”。
| 方面 | 连续性 RDD | 局部随机化 RDD |
|---|---|---|
| 关键识别条件 | 潜在结果在阈值处连续 | 窗口内处理分配可按指定机制视为随机 |
| 主要估计 | 左右极限差/局部多项式 | 有限窗口实验统计量与随机化分布 |
| 推断重点 | 带宽、平滑度、偏差校正 | 窗口、分配机制、sharp null |
| 常见误用 | 高阶多项式穿越远端样本 | 把任意靠近阈值都说成随机 |
05 调试清单与失败场景#
- 窗口是结果导向选的吗? 若看过多个窗口再挑最显著者,名义精确 值不再反映整套搜索。
- 预定协变量也失衡吗? 年龄、前测分数或地区构成若呈系统差异,需解释机制或换回连续性框架。
- 分配机制固定人数吗? 若并非如此,
combinations的等权枚举计算的是错误的参考分布。 - 运行变量可操纵吗? 堆积、四舍五入、人工改分会削弱阈值两侧可比性;检查制度日志和分数分布。
- 推断对象写清了吗? Sharp null、常数效应区间和平均效应检验要区分;不要只报“精确 值”。
本方法在处理规则近似随机、窗口很窄且单位数有限时有吸引力;若连续运行变量平滑性更可信、窗口需要更宽,局部多项式及偏差校正通常更合适。二者都是设计框架,不能只靠换一种 值算法把观察数据变成随机数据。
键盘可展开:什么时候不要用“精确”作结论?
当窗口、可交换性或分配概率没有可信依据时,穷举只会精确回答错误的设计问题。Tab 聚焦摘要后按 Enter 或 Space 展开,页面不依赖悬停或颜色。
思考练习#
- 8 人中固定 4 人处理,为什么允许分配数是 70?若观察统计量只有 2 种分配达到或超过它,双侧精确 值是多少?
- 窗口内所有已测协变量平衡,是否证明局部随机化?还需要哪些制度与未测因素论证?
- Fisher sharp null 与“平均效果为零”有何不同?存在正负异质效果时可能发生什么?
延伸阅读#
- Cattaneo, Frandsen & Titiunik (2015), Randomization Inference in the Regression Discontinuity Design: An Application to Party Advantages in the U.S. Senate ↗ — 局部随机化框架下的有限样本推断。
- Cattaneo, Titiunik & Vazquez-Bare (2016), Inference in Regression Discontinuity Designs under Local Randomization ↗ — 局部随机化推断方法。
- Sekhon & Titiunik (2017), On Interpreting the Regression Discontinuity Design as a Local Experiment ↗ — 对“断点即局部实验”解释的条件与争论。
- Cattaneo & Titiunik (2022), Regression Discontinuity Designs ↗ — 连续性与局部随机化两类框架综述。