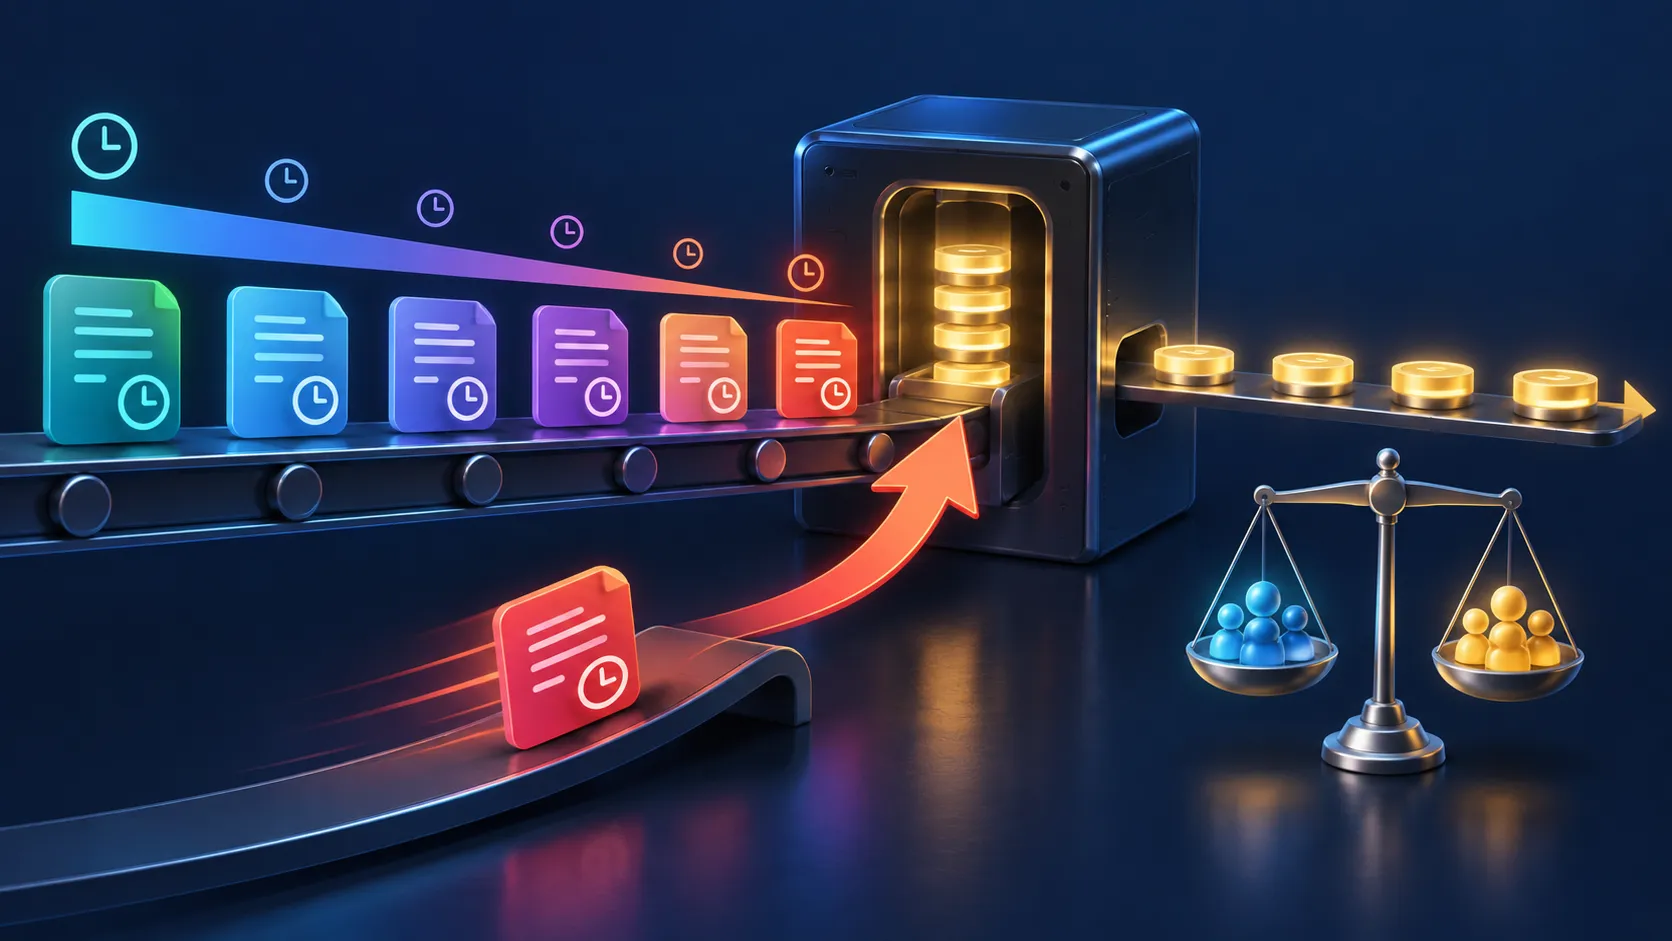
队列里谁该先生成?SLO-aware Scheduling 的剩余余量、抢占与公平性
从 FCFS 无法区分紧急程度出发,手算 deadline slack,用预测剩余服务时间排序请求,并讨论抢占成本、准入控制、aging 公平性与 vLLM priority 的实现边界。
上一篇用 Goodput 判断一组 Prefill/Decode 容量是否真的满足用户目标。但容量固定后,请求仍会同时挤进队列:先到先服务很容易解释,却不知道“谁再等 20 ms 就会违约”。
SLO-aware Scheduling(服务目标感知调度)把每个请求的剩余时延余量变成决策信号。它不等于“短请求永远优先”,也不等于给付费用户一个固定高优先级;核心是估计完成一项工作还要多久,再与它还能等待多久比较。
01 FCFS 究竟漏掉了什么?#
First-Come, First-Served(先到先服务,FCFS)只使用到达时间。设两个 Decode 请求都在等待:
| 请求 | 已等待 | 预计剩余输出 | E2E deadline 距现在 |
|---|---|---|---|
| A | 120 ms | 6 tokens | 80 ms |
| B | 200 ms | 40 tokens | 600 ms |
FCFS 会选 B,因为它更早到;但 A 只需很少工作且马上超时。另一方面,Shortest Job First(最短作业优先,SJF)永远选最短任务,也可能让一个长回答不断被新短请求插队。
调度器需要同时看到 deadline、剩余工作、批处理效率与公平性。
02 用 slack 把“着急”写成一个数#
对请求 ,令:
- :绝对截止时刻;
- :当前时刻;
- :从现在到完成的预测剩余服务时间;
- :slack(松弛时间,或剩余余量)。
ms 表示预测按时完成后还剩 100 ms; ms 表示即使立刻独占服务,预计也会晚 30 ms。Least Slack Time First(最小松弛时间优先,LSTF)选择 slack 最小的可行请求。
注意:deadline 是时钟上的目标,service time 是需要的计算,slack 才是两者相减后的风险。只按 deadline 排序的 Earliest Deadline First(最早截止时间优先,EDF)没有区分“还差 1 token”和“还差 1000 tokens”。
03 三个请求怎样手算?#
现在是 1000 ms。粗略估计 Decode 每 token 需 10 ms,暂不考虑 batching:
| 请求 | deadline | 剩余 token | slack | |
|---|---|---|---|---|
| A | 1120 ms | 4 | 40 ms | 80 ms |
| B | 1400 ms | 20 | 200 ms | 200 ms |
| C | 1180 ms | 15 | 150 ms | 30 ms |
LSTF 先选 C,而 SJF 会选 A、EDF 也会选 A。若 C 先运行一个 token,时间变为 1010 ms、剩余工作变为 140 ms,它的 slack 仍约为 30 ms:服务消耗时间的同时也减少剩余工作。
若 C 被搁置 10 ms,则 增加但 不变,slack 下降到 20 ms。这正是 slack 能持续反映排队风险的原因。
04 TTFT 与 TPOT 不是同一种 deadline#
LLM 请求至少有两种时钟:
flowchart LR
  A[到达 aᵢ] -->|排队 + Prefill| F[首 token]
  F -->|Decode step 1| T1[token 2]
  T1 -->|Decode step 2| T2[token 3]
  T2 --> E[EOS]
  A -. TTFT deadline .-> F
  F -. 每个 token 的 TPOT deadline .-> T1
  T1 -. 下一次 TPOT deadline .-> T2
A -. E2E deadline .-> EPrefill 排队主要威胁 Time To First Token(首 token 时延,TTFT);进入 Decode 后,每轮是否及时被调度决定 Time Per Output Token(每输出 token 时间,TPOT)。因此不能只给请求一个静态优先级:阶段变化后,deadline 与剩余工作都要重算。
对第 个输出 token,可把下一次流式 deadline 写成
调度器每轮应先保护即将错过下一个 token deadline 的 Decode,再用剩余 token budget 接纳 Prefill chunk。
05 批处理后,服务时间不再能逐请求相加#
若 A 单独一步耗时 8 ms,B 单独一步耗时 9 ms,一起 Decode 可能只需 11 ms,而不是 17 ms。服务时间是批组成 的函数:
所以真正的在线问题不是“取优先级最小的前 个”,而是选择一个批 ,使紧急请求按时、GPU 又不过度留空。一个可执行的启发式是:
- 先放入 slack 最小且可行的 Decode 请求;
- 用 profiler 预测加入候选后整批 step time;
- 若加入候选会让批中任何硬 deadline 失守,就跳过或缩小 Prefill chunk;
- 用剩余 token/KV budget 放入 aging 后的普通请求。
06 一个最小调度器伪代码#
schedule(now, waiting, running, token_budget):
    candidates = waiting ∪ running
    for r in candidates:
        r.remaining_ms = predict_remaining(r)
        r.slack_ms = next_deadline(r) - now - r.remaining_ms
        r.score = r.slack_ms - aging_credit(r.wait_ms)

    batch = []
    for r in sort_by_score(candidates):
        proposal = batch + [r]
        step_ms = profile(proposal)
        if fits_kv(proposal) and deadlines_hold(proposal, step_ms):
            batch = proposal
            token_budget -= scheduled_tokens(r)
        if token_budget == 0:
            break

return batch输入是请求状态、下一个 deadline、预测剩余时间与资源预算;输出是本轮执行的请求及每项 token 数。deadlines_hold 必须用加入请求后的整批 step time重算,不能沿用单请求耗时。
07 Python 中怎样把排序与保护分开?#
from dataclasses import dataclass

@dataclass(frozen=True)
class Request:
    request_id: str
    deadline_ms: float
    remaining_ms: float
    waited_ms: float
    tenant: str

def priority_key(
    r: Request,
    *,
    now_ms: float,
    aging_rate: float = 0.05,
) -> tuple[float, float]:
    slack = r.deadline_ms - now_ms - r.remaining_ms
    # 每等待 1 ms,排序分数额外减少 aging_rate ms
    protected_slack = slack - aging_rate * r.waited_ms
    return protected_slack, r.deadline_ms

queue = [
    Request("A", 1120, 40, 120, "chat"),
    Request("B", 1400, 200, 200, "batch"),
    Request("C", 1180, 150, 30, "chat"),
]
ordered = sorted(queue, key=lambda r: priority_key(r, now_ms=1000))
print([r.request_id for r in ordered])输出顺序会受 slack 和等待 aging 共同影响。这个例子只负责排序;KV 可行性、批耗时和抢占成本仍需在 scheduler core 中判断。
08 负 slack 的请求还要不要服务?#
负 slack 不代表请求毫无价值。预测可能偏保守;请求也可能只错过 E2E,却仍能满足 TPOT。策略必须显式区分:
| 情况 | 可选动作 | 风险 |
|---|---|---|
| 轻微负 slack,预测不确定 | 尽快服务 | 抢走可挽救请求的容量 |
| 确定无法满足硬 deadline | 快速失败或降级 | 用户收到错误或低质量结果 |
| 仍有流式 TPOT 价值 | 继续但降低 E2E gain | 指标口径更复杂 |
| 离线任务无硬 deadline | 移入低优先队列 | 长期饿死 |
Admission Control(准入控制)应在网关就拒绝、排队到别的副本或降级模型,而不是让注定违约的工作先占满 KV 再取消。
09 抢占什么时候值得?#
Iteration-level scheduling 允许在 token 边界换请求,但抢占并非免费:
只有被救请求减少的违约损失 大于暂停、KV 搬移/释放、重算和受害请求新增损失时才值得抢占。若 KV 能保留,成本主要是批重组;若必须 swap 或 recompute,短暂抢占可能造成更大的尾延迟。
工程上应设置 hysteresis(滞回):新请求的 score 至少好过当前请求一个阈值,才触发抢占,防止两者在边界附近来回抖动。
10 为什么最大化达标数会伤害长请求?#
若 100 ms 内可完成十个短请求或一个长请求,单纯最大化“达标请求数”总会选短请求。持续到达的短请求会让长请求 starvation(饥饿)。
三种常见保护可以组合:
- Aging:等待越久,排序 credit 越大;
- Class floor:每个租户/业务类保留最低 token share;
- Slowdown cap:限制 ,避免相对服务时间无限放大。
公平性不能只看平均等待。至少按 tenant、长度桶和 SLO 类别报告 p95/p99、最大等待、admission rate 与 goodput。
11 当前 vLLM priority 能做什么?#
当前 vLLM SchedulerConfig 的 policy 支持 fcfs 与 priority;priority 数值越小越先处理,同优先级按到达时间。请求队列和 KV 不足时的抢占也会考虑 priority。
vllm serve your-org/your-model \
--scheduling-policy priority外部控制面可将 deadline/slack 桶映射为整数 priority,例如 critical=-20, urgent=-10, normal=0。但这只是离散优先队列,不是完整的 slack scheduler:
- vLLM 不会替业务推导绝对 deadline;
- 静态 priority 不会随时间自动重算 slack;
- 预测剩余输出、跨租户公平与拒绝策略仍在外部;
- priority 频繁改变需要确认请求 API、版本与重排路径。
因此生产实现应保存 vLLM 版本,先验证所用 endpoint 是否传递 priority,再用 trace replay 检查排序、抢占和 KV 行为。
12 怎样调试一个“看似聪明”的调度器?#
每次决策至少记录:
request_id, tenant, phase, arrived_at, next_deadline
predicted_remaining_ms, slack_ms, aging_credit, final_score
scheduled_tokens, batch_step_pred_ms, batch_step_actual_ms
preempted_by, kv_action, finish_reason, slo_met最短调试路径:
- 用 3–5 个确定长度的合成请求重放,逐轮手算排序;
- 冻结 profiler,确认只改变 deadline 时顺序符合预期;
- 注入预测误差,检查 aging 与负 slack 策略;
- 再打开真实 batching/KV,比较预测和实际 step time 残差;
- 最后在相同 trace 上 A/B FCFS、priority 与 SLO-aware。
13 常见错误与失败场景#
| 错误 | 结果 | 修正 |
|---|---|---|
| 用相对 SLO 直接排序 | 忽略已经等待的时间 | 到达时转成绝对 deadline |
| 将输出上限当实际长度 | 长请求估计普遍过大 | 用分布预测并在线更新 |
| 只按 deadline 不估服务时间 | 大任务堵住近期限队列 | 使用 slack 或可行性测试 |
| 每轮无门槛抢占 | 队列抖动、KV 重算 | 加抢占成本与滞回 |
| 只优化总达标数 | 长请求/弱租户饥饿 | aging、份额与分桶指标 |
| profiler 只在低负载测 | 批耗时严重低估 | 覆盖 batch、上下文、硬件状态 |
即使公式正确,突发流量超过物理容量时也不可能让所有请求达标;预测分布漂移、时钟不同步、跨池网络抖动和模型冷启动都会使 slack 失真。调度只能分配违约,不能凭空制造容量。
14 今天真正需要记住什么?#
- deadline 表示还能等多久,剩余服务时间表示还要做多少工作,二者之差 slack 才表示违约风险。
- LLM 同时有 TTFT、逐 token TPOT 与 E2E 时钟,优先级应随阶段和生成进度更新。
- 批处理让服务时间取决于整个 batch;排序之后还必须做 deadline、KV 与 token budget 可行性检查。
- 抢占、准入与公平性是同一个系统问题;只最大化短期达标数会牺牲长请求和弱租户。
15 思考题与小练习#
- 当前时刻 200 ms,三个请求的
(deadline, remaining)分别为(300, 60)、(260, 10)、(500, 240)。分别写出 FCFS 信息不足之处、EDF/SJF/LSTF 的首选请求。 - 修改 Python 例子:每个 tenant 等待超过 500 ms 后获得额外 100 ms credit,并构造一个能证明长请求最终会被服务的队列。
- 设计一次抢占实验:分别模拟 KV 保留与 recompute,找出“抢占开始降低 Goodput”的成本阈值。
相关工作#
- Zhang et al., JITServe: SLO-aware LLM Serving with Imprecise Request Information ↗,在不精确信息下按服务收益与余量组织批次。
- Wu et al., FastServe: Fast Distributed Inference Serving for Large Language Models ↗,讨论 token 粒度抢占与多级反馈队列。
- Yu et al., Orca: A Distributed Serving System for Transformer-Based Generative Models ↗,奠定 iteration-level scheduling 与 selective batching。
- Zhong et al., DistServe: Disaggregating Prefill and Decoding for Goodput-optimized LLM Serving ↗,用 TTFT/TPOT SLO Goodput 驱动分离式服务。
- vLLM, SchedulerConfig 官方文档 ↗,列出当前 FCFS/priority policy 与调度配置。
16 下一篇预告#
Slack 公式里最危险的一项是 :EOS 尚未出现时,谁也不知道还会生成多少 token。下一篇将把点预测改成带不确定性的分位数预测,解释为何低估比高估更危险,以及怎样用覆盖率监控长度模型失效。