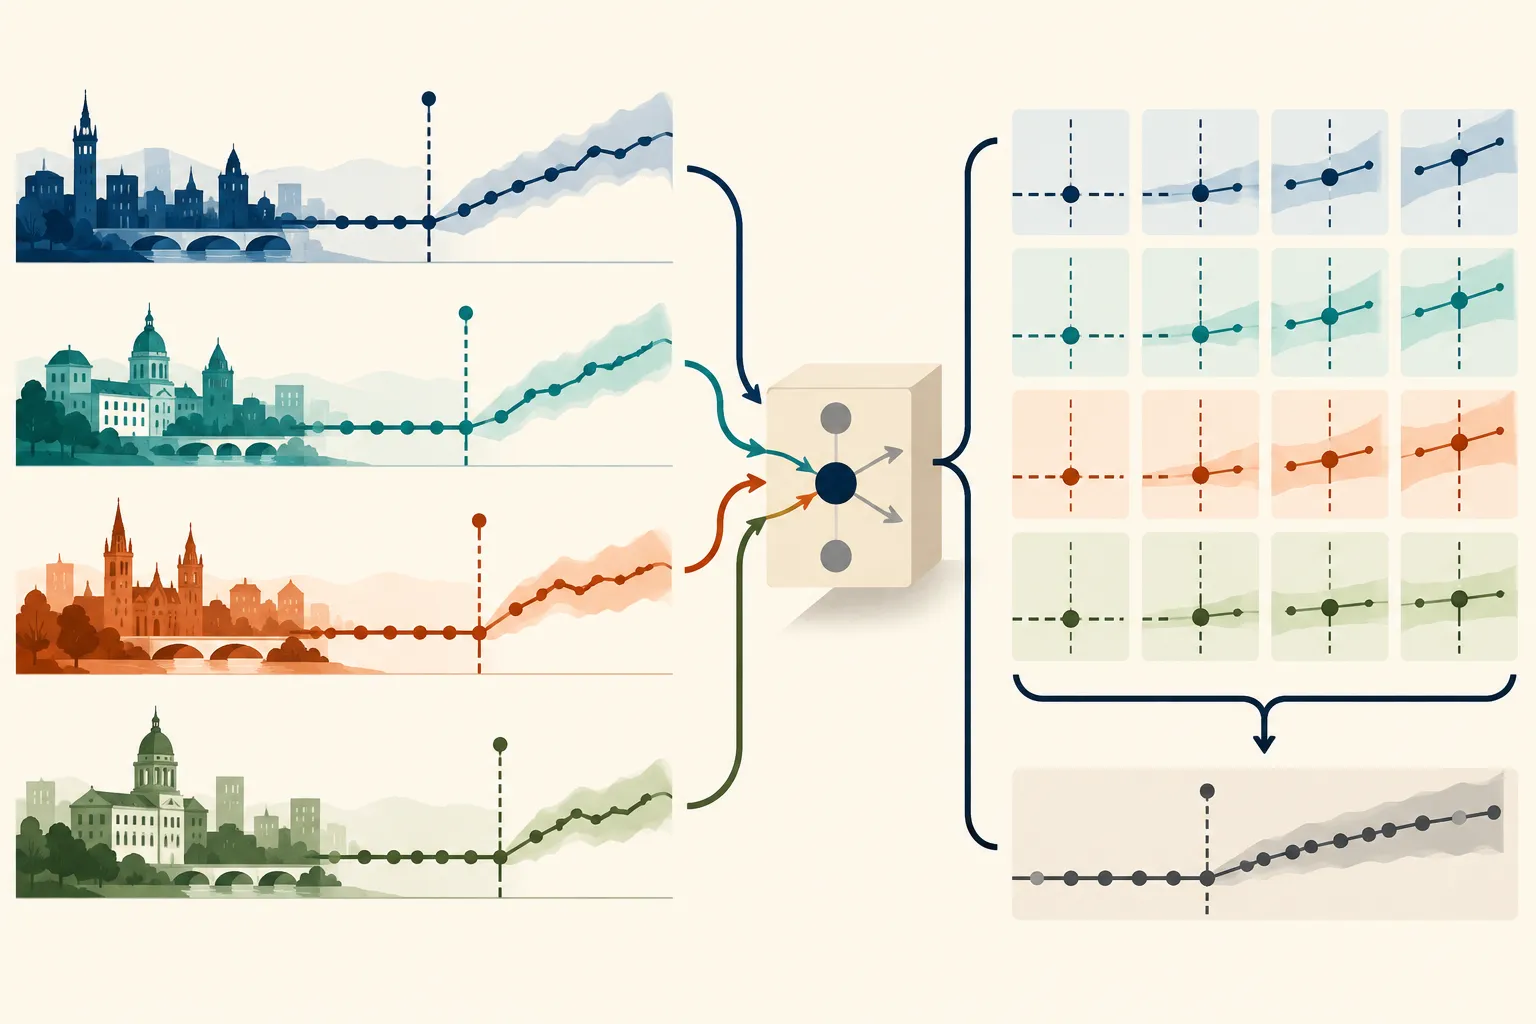
城市分批上线,传统双向固定效应为何会算出负效果?组别—时间 DiD
错时上线且效果随批次或暴露时长变化时,传统 TWFE 会混用已处理组作对照。逐个估计组别—时间 ATT,再显式汇总目标效应。
上一篇用交互固定效应(Interactive Fixed Effects,IFE)表示“共享冲击会按城市载荷不同而变化”,也提醒错时上线不能把已经处理的城市继续当对照。现在看这个问题本身:推荐模型按城市分批上线,早上线城市的效果会随使用时长增长,晚上线城市起初效果较小。若把所有城市和日期塞进一个双向固定效应(Two-Way Fixed Effects,TWFE)回归,软件会给出一个数字;这个数字却可能把早期已处理城市拿来比较晚期新处理城市,从而把正效果混成负的比较项。
本篇只讲组别—时间处理效应(group-time treatment effects):按首次处理批次 和日历时间 分别估计 ,每次只和从未或当时尚未处理的单位比较,再根据明确写出的目标权重汇总。下一篇可以讨论处理前趋势只近似成立时,如何给结论做敏感性界限。
01 已处理组当对照,为什么会改变量的符号?#
下表是按单位计的结果均值。早上线组从第 1 期后处理,效果从 10 增至 20;晚上线组从第 2 期后处理,初始效果为 5;第三组从未处理。
| 组 | 第 0 期 | 第 1 期 | 第 2 期 | 首次处理期 |
|---|---|---|---|---|
| 早上线 E | 100 | 111 | 122 | 1 |
| 晚上线 L | 80 | 81 | 87 | 2 |
| 从未上线 N | 60 | 61 | 62 | — |
假设未处理结果每期都增加 1。早上线组第 1 期的效果是 ;第 2 期效果是 。晚上线组刚处理后的变化是 ,早上线组同期已处理变化是 。若把前者减后者,比较项就是 。它为负不是因为新模型伤害了所有人,而是早上线组效果已长大,成了错误对照。
这个两组两期算式用来展示污染机制,不表示 TWFE 总体回归系数在本例恰为 。多组多期 TWFE 混合多个 2×2 比较,权重可能为负,目标也会随处理时点和效果异质性改变。因此,负系数不能直接读作总体平均处理效果。
flowchart LR
  A[整理每个单位首次处理期 G] --> B[对批次 g 和时间 t 单独构造比较]
  B --> C{截至 t 仍未处理}
  C --> D[尚未处理单位]
  C --> E[从未处理单位]
  D --> F[处理组变化 − 对照组变化]
  E --> F
  F --> G[得到 ATT(g,t),检查支持与平行趋势]
G --> H[按目标人群和时间权重汇总]02 组别—时间 ATT 在估计什么?#
令 表示单位 在第 期首次接受处理; 表示样本期内从未处理。 和 分别是单位在时期 未处理、已处理时的潜在结果。对 ,目标为:
处理后的 看不到。选择处理前基准 ,无协变量的两期变化估计量是:
第一项是批次 的变化,第二项是同一日历区间内“截至 仍未处理”单位的变化。识别依赖相应窗口内的平行趋势,以及没有提前反应、跨组干扰或只影响一组的同期指标变更。若需协变量调整,应明确条件化或双重稳健估计设计;加入任意控制变量不能修复错误的对照组。
数据维度要保持清楚:
- 结果面板 : 个城市为行, 个时期为列;每格是按一致指标口径聚合的结果。
- 首次处理向量 :每个单位一个批次。
- 效应表 :行是批次,列是日历期。 的格子没有处理效应,不能补成零。
- 汇总需另选权重 、:。
基准常取 ;也可预先定义更早的共同基准。不同基准会改变比较窗口和假设,需在看结果前决定。
03 手算三个批次—时间单元#
令第 0 期为共同基准,未处理时各组每期增加 1。早上线组效应依次为 10、20,晚上线组首期效应为 5:
| 组 | 第 0 期 | 第 1 期 | 第 2 期 | 首次处理期 |
|---|---|---|---|---|
| 早上线 E | 100 | 111 | 122 | 1 |
| 晚上线 L | 80 | 81 | 87 | 2 |
| 从未上线 N | 60 | 61 | 62 | — |
- 早上线在 :。
- 早上线在 :晚上线组已处理,只能用 N,故 。
- 晚上线在 :用尚未处理的 N,得到 。
若目标是这三个“批次 × 处理后时期”单元的等权平均,结果是 。若改为按处理单位数加权、只看上线首期,或按日历期汇总,答案不同。权重定义“谁的平均效果”,不是调显著性的旋钮。
04 可运行的纯 Python 面板实现#
输入是平衡面板 y()和首次处理期 adoption(长度 ,None 代表从未处理);输出每个可识别单元的 ATT、处理单位数和对照单位数。它使用单位等权均值,不估标准误。
for each adoption cohort g:
    choose a pre-treatment baseline b = g - 1
    for each post-treatment period t >= g:
        controls = units never treated or first treated after t
        if controls are empty: mark ATT(g,t) as unavailable
        else: ATT(g,t) = treated change(b -> t) - control change(b -> t)
aggregate only defined cells with predeclared cohort/time weights实现使用 Python 内置的 len 检查面板形状、enumerate 同时读取单位索引和上线期、sorted 固定批次遍历顺序,sum 计算组内均值。输出是字典列表;若某期没有有效对照,示例跳过该格,因此正式分析还要单独记录“不可估”单元及其原因,不能把缺失格补零。
def group_time_att(y, adoption):
    """Balanced panel: y[n][t], adoption[n] is first treated period or None."""
    n_units = len(y)
    if n_units == 0 or len(adoption) != n_units:
        raise ValueError("y must contain units and match adoption")
    n_periods = len(y[0])
    if any(len(row) != n_periods for row in y):
        raise ValueError("panel must be rectangular")

    cohorts = sorted({g for g in adoption if g is not None})
    cells = []
    for g in cohorts:
        baseline = g - 1
        if baseline < 0:
            raise ValueError("each cohort needs a pre-treatment period")
        treated = [i for i, gi in enumerate(adoption) if gi == g]
        for t in range(g, n_periods):
            controls = [
                i for i, gi in enumerate(adoption)
                if gi is None or gi > t
            ]
            if not controls:
                continue
            treated_change = sum(
                y[i][t] - y[i][baseline] for i in treated
            ) / len(treated)
            control_change = sum(
                y[i][t] - y[i][baseline] for i in controls
            ) / len(controls)
            cells.append({
                "cohort": g, "period": t,
                "n_treated": len(treated), "n_control": len(controls),
                "att": treated_change - control_change,
            })
    return cells

# 行为单位,列为 t=0,1,2;上线期分别为 1、2、从未。
y = [[100, 111, 122], [80, 81, 87], [60, 61, 62]]
adoption = [1, 2, None]
cells = group_time_att(y, adoption)
for cell in cells:
    print(cell)
# ATT: (1,1)=10, (1,2)=20, (2,2)=5baseline 固定为 。controls 只保留 或从未处理的单位,避免处理后结果泄漏进对照。真实数据应检查每个单位—时期是否观测齐全、首次处理时点是否来自真实生效日志、缺失是否改变样本构成,以及比率指标的分子/分母是否先正确聚合。单位数不等于独立随机化簇数;推断层级由处理如何分配决定。
事件时间 表示上线后经历的时期。可把同一 的 ATT 按批次等权或按处理单位数加权,但必须展示权重与批次构成。本例事件时间 0 的等批次平均是 ,事件时间 1 只有早上线组的 20;后段变化同时伴随样本批次变化,不能解读为同一批城市随时间增长的动态效果。
05 调试、推断与方法边界#
| 检查 | 常见错误 | 调试动作 |
|---|---|---|
| 首次处理期 | 用申请时间替代真实生效时间 | 对照流量、部署、回滚日志 |
| 对照集合 | 已处理单位仍被当作对照 | 对每个 打印对照 ID 和状态 |
| 处理前基准 | 各批次窗口不同且未说明 | 冻结规则并绘制每批次前趋势 |
| 汇总权重 | 把未定义格补 0 后求平均 | 只汇总可估格,报告权重与样本 |
| 标准误 | 把每个请求或日期当独立处理 | 按实际处理分配层级推断;簇少时谨慎 |
| 事件研究 lead | 不显著就宣称平行趋势成立 | 报区间、功效和敏感性,不把未拒绝当证明 |
若城市提前灰度、处理影响邻近城市、结果口径或用户构成随上线变化、上线时间由即将发生的结果冲击决定,以上估计都可能失效。若某批次在后期没有尚未处理或从未处理单位,该单元缺乏比较对象;所有单位最终处理时,长事件时间也不能靠外推凭空补出反事实。只有少数处理城市时,很多日记录并不会自动带来可靠的常规聚类推断。
组别—时间 ATT 与普通 TWFE 的差别在于先定义比较对象和目标参数。它并不自动消除混杂,仍依赖识别假设。合成控制、合成双重差分和 IFE 改变反事实构造方式;分批处理时依然要说明每批次、每时期有哪些未处理信息可用。
键盘可展开:分批上线分析提交前检查
按 Tab 聚焦摘要,再按 Enter 或 Space 展开。逐批核对首次生效期、处理前基准、当期未处理对照、处理前趋势、每格样本数和推断聚类层级;事件时间图标出批次构成;报告总体效果按城市、处理单位还是批次—时期加权。
思考练习#
- 某批次上线前后分别增长 8,同期仍未处理组增长 3。ATT 是多少?对照在结果期前一天开始 10% 流量灰度,还能视作未处理吗?
- 事件时间 只含最早两个批次,而 含五个批次。曲线的时间变化和批次构成变化如何区分?
- 4 个城市集群各有 10 万请求,处理在城市层随机。标准误应把哪一级当独立信息?若仅两个处理城市,常规聚类推断面临什么限制?
延伸阅读#
- Callaway & Sant’Anna, Difference-in-Differences with Multiple Time Periods (Journal of Econometrics, 2021) ↗ — 组别—时间处理效应、聚合和推断。
- Goodman-Bacon, Difference-in-Differences with Variation in Treatment Timing (Journal of Econometrics, 2021) ↗ — 分解不同处理时点下 TWFE 的 2×2 比较。
- Sun & Abraham, Estimating Dynamic Treatment Effects in Event Studies with Heterogeneous Treatment Effects (Journal of Econometrics, 2021) ↗ — 异质效果如何污染传统事件研究 lead/lag 系数。
- de Chaisemartin & D’Haultfoeuille, Two-Way Fixed Effects Estimators with Heterogeneous Treatment Effects (American Economic Review, 2020) ↗ — TWFE 异质处理效果下的权重和解释。
上一篇从共享潜在因子重建反事实;本篇按上线批次拆开比较,避免已处理组替未处理组充当对照。两者都要说明哪些单位—时间格承载了未处理反事实,拟合得像不能替代识别假设。