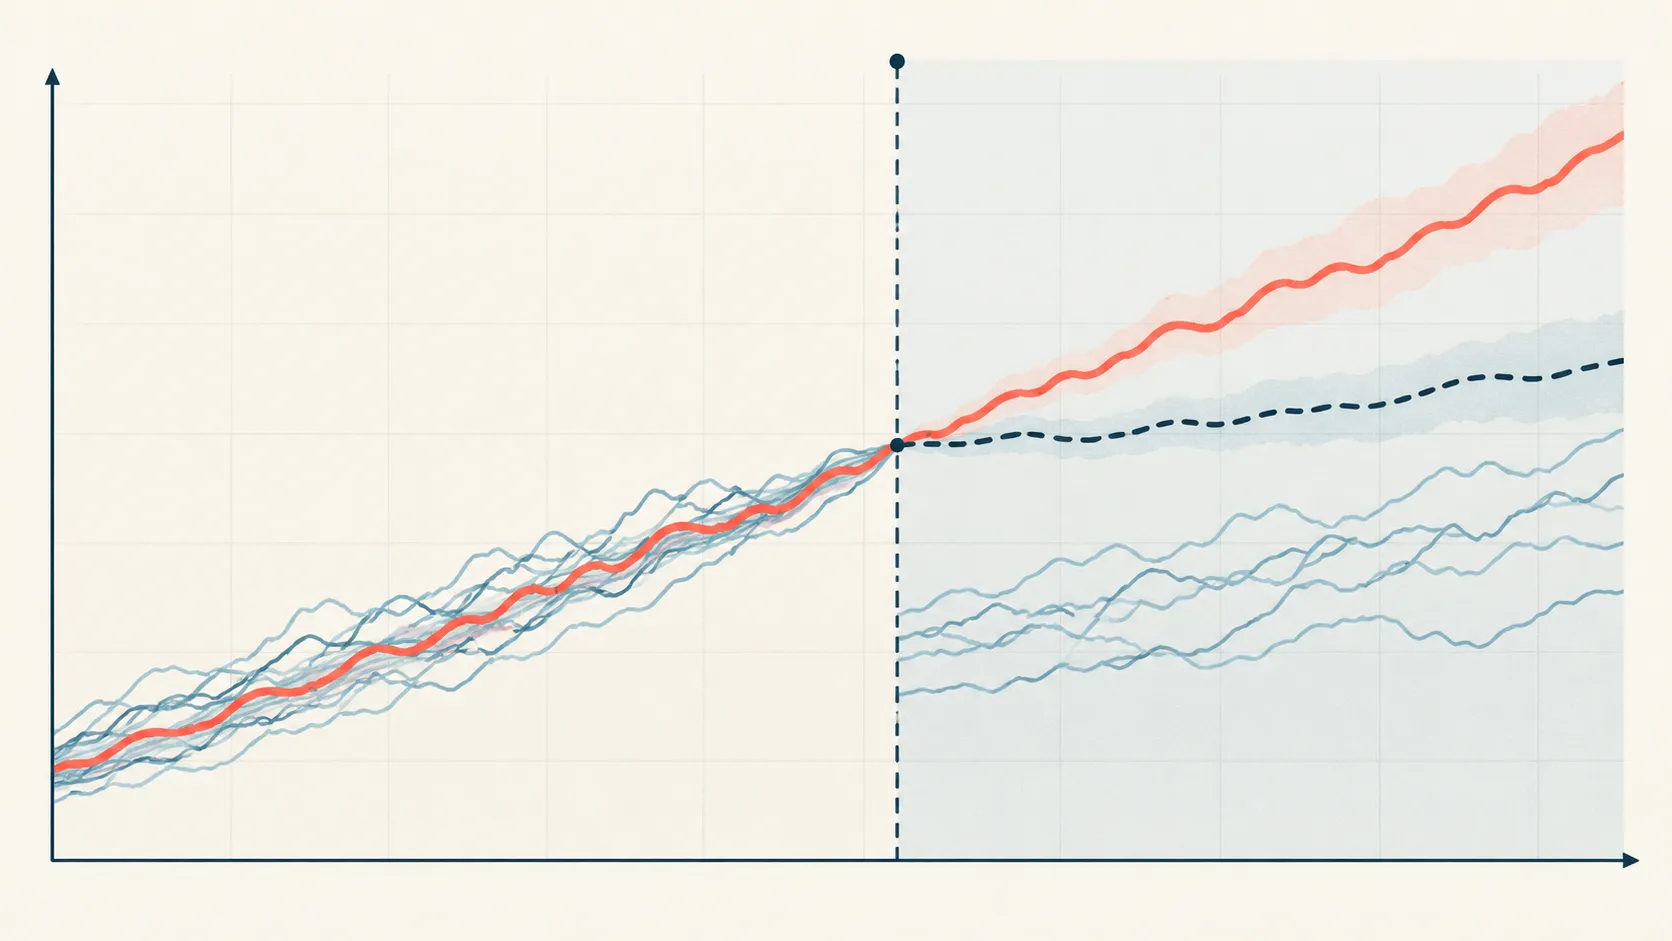
只有一座城市上线,怎样从多个对照城市拼出反事实?合成控制法
把多个未处理城市加权成一个处理前走势相似的合成市场,用受约束权重构造上线后的反事实;手算权重、SciPy 实现和安慰剂检验。
上一篇用双重差分(Difference-in-Differences,DiD)借助一个可比市场的同期变化构造反事实。如果只有一个城市上线新模型,而单个对照城市走势不够像,能否把多个未上线城市组合起来?合成控制法(Synthetic Control Method,SCM)给每个供体城市一个非负权重,让权重和为 1,再用这组权重组成“合成城市”。关键要求是合成体在干预前能复现处理城市的结果轨迹与重要预测变量;干预后两者差距才可作为处理效果的估计。下一篇可继续讨论:当处理单位不止一个、上线时间错开时,如何扩展这类反事实方法。
01 为什么一个对照城市不够?#
设一个推荐模型只在城市 A 上线,观察指标是每万次请求的有效点击数。城市 B 的用户结构像 A,却有不同的长期增长;城市 C 增长趋势接近 A,却用户结构差异很大。直接挑 B 或 C,反事实会依赖一次脆弱的选择。SCM 用多个未处理城市的凸组合(convex combination,即非负且总和为 1 的加权平均)寻找贴近处理城市的比较对象。
flowchart LR
  T[处理城市:干预前结果轨迹与特征] --> FIT[只用干预前数据拟合供体权重]
  D1[供体城市 A] --> FIT
  D2[供体城市 B] --> FIT
  D3[供体城市 C] --> FIT
  FIT --> W[非负权重且总和为 1]
  W --> SYN[合成城市:各供体结果的加权和]
  SYN --> GAP[干预后:处理城市 − 合成城市]
T --> GAP令 为最后一个干预前时期, 为总时期数, 为供体城市数。供体结果矩阵记为 :每行是一个时期,每列是一座城市;处理城市结果为 ;权重 。在干预前拟合:
干预后 的合成反事实是 ,处理效果差距为 。下标 0 表示“没有处理”的潜在结果;它不是零值。
02 手算:两座供体如何拼出处理城市?#
先看两个供体、四个干预前周的例子。指标单位为每千次请求的有效点击数:
| 周 | 供体 A | 供体 B | 处理城市 | |
|---|---|---|---|---|
| 1 | 8 | 12 | 10 | 10 |
| 2 | 10 | 14 | 12 | 12 |
| 3 | 12 | 16 | 14 | 14 |
| 4 | 14 | 18 | 16 | 16 |
干预前每周都有 ,所以权重 完全重现处理城市。干预后若 A 为 15、B 为 21,合成城市为 。处理城市实际观测为 24,则当期 gap 是 。这里的 6 只有在“供体未受新模型影响、处理前拟合代表了处理后的未处理关系”等识别假设成立时,才可解释成因果效果。
SCM 不是把最像的一周当邻居,也不是在干预后重新调权重;若用处理后的结果选权重,就把效果本身泄漏进反事实。权重只由干预前信息确定,之后固定地作用于每个供体城市的时间序列。
03 SciPy:显式求解单纯形上的权重#
下面代码以完整的干预前结果轨迹做拟合,输入 treated_pre(形状 )和 donors_pre(形状 ),输出权重(形状 )、干预后合成反事实与 gap。它用 SciPy 官方 minimize 的 SLSQP 方法处理盒约束与权重和约束;示例刻意采用可手算数据,预期得到约 0.5、0.5。
import numpy as np
from scipy.optimize import minimize

# 行为周,列为供体;这里只用 4 个干预前周,shape=(T0=4, J=2)
donors_pre = np.array([
    [8.0, 12.0],
    [10.0, 14.0],
    [12.0, 16.0],
    [14.0, 18.0],
])
treated_pre = np.array([10.0, 12.0, 14.0, 16.0])
J = donors_pre.shape[1]

# w 的 shape=(J,),残差向量 shape=(T0,)
def objective(w):
    residual = treated_pre - donors_pre @ w
    return float(residual @ residual)

result = minimize(
    objective,
    x0=np.full(J, 1.0 / J),
    method="SLSQP",
    bounds=[(0.0, 1.0)] * J,
    constraints=[{"type": "eq", "fun": lambda w: w.sum() - 1.0}],
    options={"ftol": 1e-12, "maxiter": 1000},
)
if not result.success:
    raise RuntimeError(f"SCM weight optimization failed: {result.message}")
weights = result.x

# 干预后数据按“周 × 供体”排列,shape=(T1-T0, J)
donors_post = np.array([[15.0, 21.0], [16.0, 22.0]])
treated_post = np.array([24.0, 25.0])
synthetic_post = donors_post @ weights  # shape=(T1-T0,)
gap = treated_post - synthetic_post

print("weights:", weights)
print("synthetic:", synthetic_post)
print("gap:", gap)
# weights: [0.5 0.5];synthetic: [18. 19.];gap: [6. 6.]minimize(fun, x0, method, bounds, constraints, options) 从初值 x0 搜索目标函数的局部最小值;SLSQP 支持等式/不等式约束。result.x 是候选权重,result.success 与 result.message 用于判断优化器是否正常结束。调用成功不等于因果设计有效,还应显式检查权重和、最小权重、处理前拟合误差和不同初值下的稳定性。上例两列供体轨迹共线,权重可能不唯一但合成轨迹仍相同;真实场景中不要把某个唯一数字权重误当成识别条件。
若有多个协变量,标准 SCM 常将处理前结果滞后值和协变量压成预测矩阵 、,并最小化加权距离 。 是预测项数, 是预测项重要性矩阵,通常为非负对角权重。选取 本身也会过拟合;应仅在处理前窗口用预先说明的验证策略确定,而不是看到干预后 gap 后回头调参。这里的最小实现直接匹配结果路径,不额外估计 ,因此更容易审计。
04 处理前拟合好,处理后才值得看#
评估前先把每座供体的权重、处理城市与合成城市的完整时间轨迹画出来,并报告处理前均方根预测误差(Root Mean Squared Prediction Error,RMSPE):
处理前误差大,意味着构造的合成城市不像目标城市,干预后差距难解释。误差小也不是因果性的证明:未知冲击可能只发生在处理城市;供体可能被新模型的跨城溢出影响;处理前偶然拟合也可能在处理后自然发散。
可做供体安慰剂(in-space placebo):轮流把每个未处理城市假装成处理城市,用同一套规则重新拟合,比较各城市“处理后 gap 相对处理前 RMSPE”的大小。若处理城市的变化并不比大多数供体的伪效果突出,因果证据较弱。也可做伪上线时间(in-time placebo),把日期提前到真实干预前;若假日期也出现类似 gap,可能存在趋势错配或拟合不稳。安慰剂是相对证据,不会自动变成随机化实验的精确 p 值,尤其供体数很少或城市之间不具可交换性时。
| 看到的现象 | 首要检查 | 可能结论 |
|---|---|---|
| 干预前 RMSPE 很大 | 供体池、窗口、单位和指标口径 | 不应把 gap 当效果报告 |
| 权重几乎全压在一座城市 | 该城市特殊冲击、单点外推 | 结论对单个供体敏感 |
| 多个供体权重不稳定 | 供体预测变量共线 | 权重解释不稳;轨迹拟合或许仍稳定 |
| 伪上线日也有明显 gap | 趋势变化、季节性、窗口选择 | 反事实动态关系可能不稳定 |
| 处理城市 gap 大但供体安慰剂也常见 | 供体异质性、处理前拟合质量 | 效果不够异常,证据有限 |
| 供体城市接收了处理流量 | 干扰或溢出 | 供体不再代表未处理状态 |
05 和 DiD、回归及增强 SCM 的边界#
DiD 通常用一个或多个对照组的共同变化扣除处理组变化,识别依赖平行趋势;SCM 显式挑出非负、和为 1 的供体组合,使合成体尽量匹配处理前结果和预测变量。SCM 可把多个对照拼成一个透明的反事实,但依然需要处理后关系稳定、没有差异同期冲击、供体未受干扰等条件。两者都不能只靠处理前拟合证明未观测反事实正确。
普通回归可用负权重或外推来达到数值拟合,SCM 的凸组合限制提升可解释性,但也可能无法匹配目标:若处理城市位于供体可行范围之外,优化只能选边界上的“最不差”组合。增强合成控制(Augmented SCM)会用结果模型修正不完全拟合造成的偏差;广义合成控制用交互固定效应刻画随时间变化的潜在因子,适用于更丰富的面板结构。它们扩展了模型能力,也带来额外的估计假设与调参,不应把名称相似的方法混作一个算法。
工程上要先冻结分析单位、结果定义、干预时间、供体池和处理前窗口;校验时间戳、缺失周、城市 ID、供体污染与数据版本;仅用处理前数据拟合;保存权重、优化器状态、输入摘要与代码版本;然后生成 gap 轨迹与安慰剂图。若某城市改了埋点或接收跨城流量,先修复数据或排除供体并记录理由,不要通过反复调权重把坏拟合“调成显著”。
键盘可展开:合成控制发布前检查
按 Tab 聚焦此项,按 Enter 或 Space 展开。确认结果口径和干预时点冻结;供体在整个研究窗口未接受处理或溢出;权重只用干预前信息拟合;报告处理前拟合误差、最大权重和安慰剂;保留替代供体池与窗口的敏感性结果;明确说明供体池之外不能外推的限制。
思考练习#
- 供体 A、B 的干预前指标依次为 与 ,处理城市为 。求凸组合权重。若干预后 A=15、B=21、处理城市=24,估计 gap 是多少?
- 若某城市权重为 0.92,其他供体合计 0.08,结论最可能对什么风险敏感?设计一个可报告的敏感性检查。
- 干预前 RMSPE 很低,但处理城市在上线同周还改变了埋点口径。为什么优化无法修复这个问题?你需要怎样重建指标或收窄结论?
延伸阅读#
- Abadie & Gardeazabal, The Economic Costs of Conflict: A Case Study of the Basque Country (AER, 2003) ↗ — 早期合成对照应用。
- Abadie, Diamond & Hainmueller, Synthetic Control Methods for Comparative Case Studies (JASA, 2010) ↗ — 经典 SCM 形式化与加州控烟案例。
- Abadie, Using Synthetic Controls: Feasibility, Data Requirements, and Methodological Aspects (JEL, 2021) ↗ — 讨论方法适用条件与失败情形。
- Ben-Michael, Feller & Rothstein, The Augmented Synthetic Control Method (JASA, 2021) ↗ — 以结果模型修正不完全拟合。
- Xu, Generalized Synthetic Control Method (Political Analysis, 2017) ↗ — 交互固定效应下的面板反事实方法。
上一篇从一个对照市场的共同变化构造 DiD 反事实;本篇把多个未处理市场压成一个合成对照。两种方法都依赖非随机的反事实假设,拟合图和安慰剂是诊断工具,不是因果识别的自动证明。