供体城市和处理前周次都不理想,怎样同时加权?合成双重差分
把合成控制的供体权重与双重差分的时间校正结合起来,逐步理解 Synthetic DiD 的双重加权、手算和 NumPy/SciPy 实现。
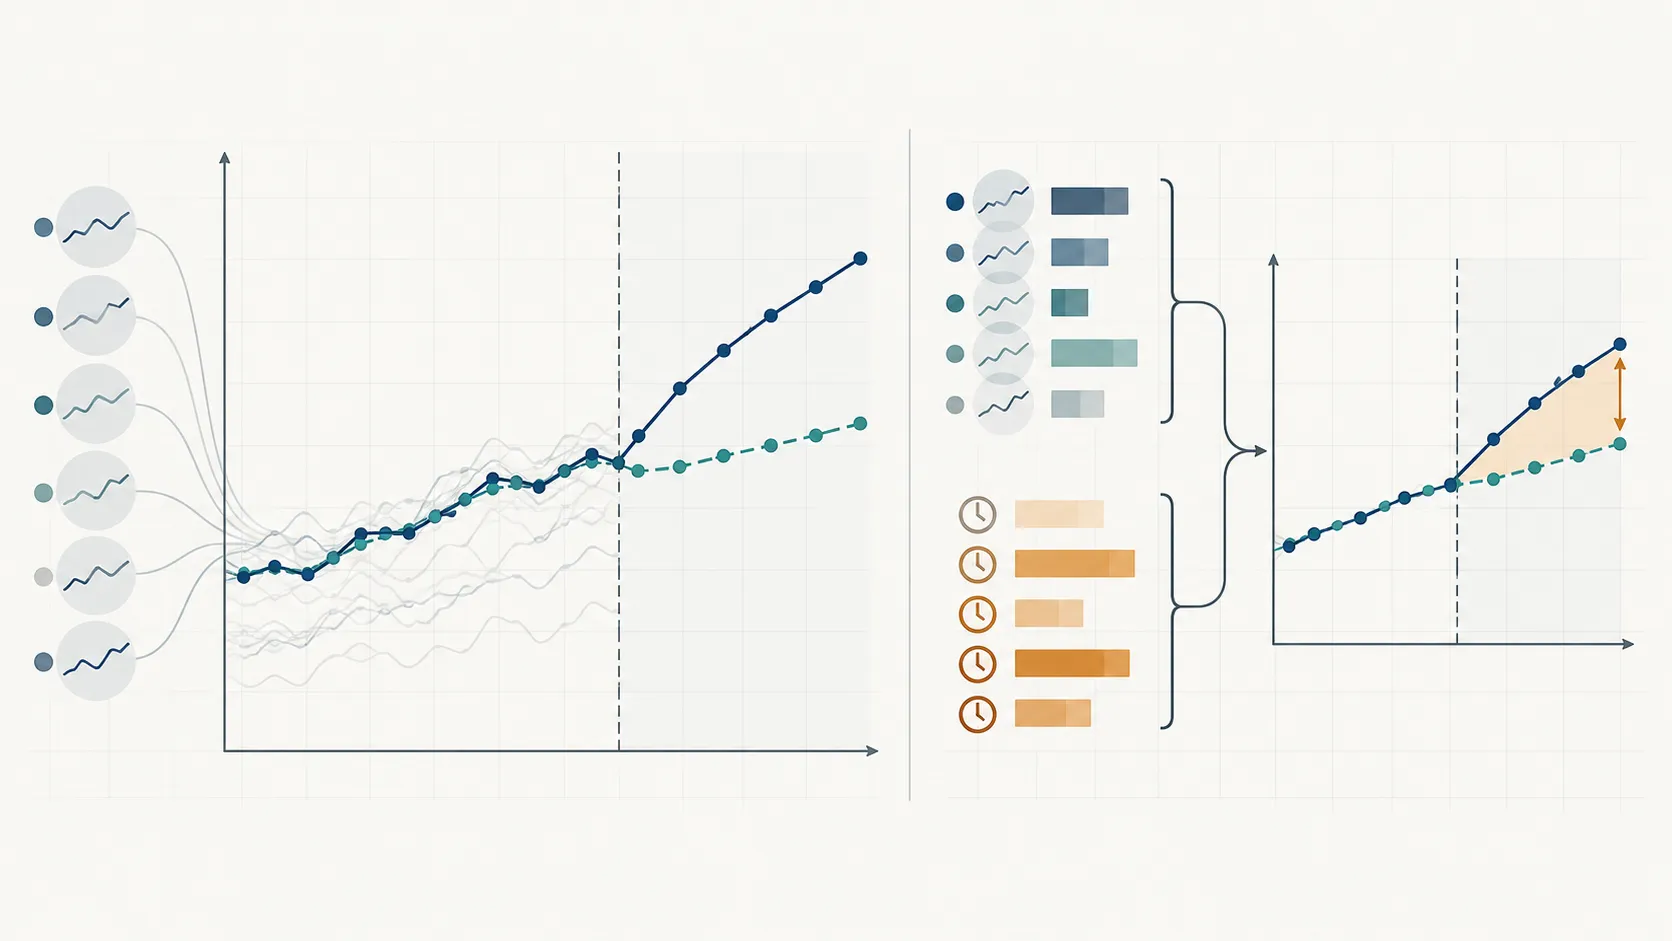
上一篇用合成控制法(Synthetic Control Method,SCM)把多个未处理城市加权成一个合成城市;它避免押注单一对照,但供体池若有共同趋势错配,单靠单位权重仍会偏。双重差分(Difference-in-Differences,DiD)通过处理前后变化扣除共同时间冲击,却通常依赖处理组与对照组的平行趋势。本篇讲合成双重差分(Synthetic Difference-in-Differences,SDID):在控制单位和处理前时间两侧都学习权重,再做差分。下一篇继续放宽“共同冲击只有一个加法项”的假设,用交互固定效应刻画多单位、错时处理下的共享潜在变化。
01 两个老问题,两个方向的权重#
设有 个单位、 个时期,结果矩阵为 ,行对应城市/门店,列对应周。处理指示矩阵 ;简单展示时,前 行是一直未处理的供体,后 行是一起进入处理的单位,处理从 期开始。SDID 学两组凸权重:单位权重 给供体城市加权,时间权重 给处理前周次加权;两者非负且分别和为 1。
flowchart LR
  Y[单位 × 时间结果面板 Y] --> A[仅用处理前结果拟合供体权重 ω]
  Y --> B[仅用未处理单位拟合处理前时间权重 λ]
  A --> C[处理组与加权供体的前后变化]
  B --> C
  C --> D[加权 DiD:处理效果 τ]
D --> E[按单位和时间聚类做推断]对一组共同处理单位,易读的加权差分形式是:
这里 是处理单位在时期 的平均; 是其处理后平均; 对每个供体先对处理后时期取平均。第一括号测处理组按 定义的变化,第二括号测合成供体的对应变化,最后相减。完整估计通常可写成单位权重、时间权重与处理交互项共同进入的加权最小二乘;这里先看平衡面板、共同处理时点下的直观版本。
单位权重让供体在处理前水平和走势上靠近处理组;时间权重强调最能预测供体处理后水平的处理前时期。时间权重只用未处理单位拟合,即使某些供体处理后已观测到结果,也不能把处理组处理后结果送进权重拟合。对多个处理批次,应按估计目标明确风险集和时间权重,不能将不同批次简单摊平成一个共同上线时点。
02 手算:同时扣掉单位差异与时间漂移#
有两个未处理城市 A、B 和一个处理城市,处理前两周、处理后两周的指标如下,单位为每千请求的有效点击数:
| 单位 | 周 1 | 周 2 | 周 3 | 周 4 |
|---|---|---|---|---|
| 对照 A | 8 | 10 | 9 | 9 |
| 对照 B | 12 | 14 | 13 | 13 |
| 处理城市 | 10 | 12 | 14 | 16 |
两个供体等权,,合成供体的四周均值为 。两周处理前结果完整匹配;两座控制城市的处理后均值分别为 9 和 13,与两期平均的处理前值对应,因此本例时间权重为 。处理城市从处理前加权均值 11 升到处理后均值 15,变化为 4;合成供体从 11 升到 11,变化为 0。SDID 差为 。若处理城市在处理前整体比对照高 3,单看处理后水平会多出这 3;差分先抵消不随时间变化的水平差。
手算让单位清楚:每个均值仍以“城市”为聚合单位,不是把请求数当独立实验样本;对不同基线的城市,只有单位与时间两侧的差分权重都按预先定义的目标构造时,这个 4 才能被解释为处理效果。
03 用 NumPy 与 SciPy 拟合两组权重#
以下示例输入 Y(单位 × 时间,形状 )与 n_control,输出单位权重(长度 )、时间权重(长度 )和 SDID 点估计。为保持例子短,单位权重目标是“处理组处理前时间均值”,时间权重目标是“供体处理后平均水平”;优化目标包含可消去的自由截距,只匹配形状而允许固定水平差;两项都加一个小的二次正则,避免权重全压在噪声单位/时期。生产估计应遵循论文的完整目标与方差程序,且正则参数只能按处理前验证规则选择。
import numpy as np
from scipy.optimize import minimize

# 行=单位 [对照 A, 对照 B, 处理城市];列=周。shape=(3, 4)
Y = np.array([
    [8.0, 10.0, 9.0, 9.0],
    [12.0, 14.0, 13.0, 13.0],
    [10.0, 12.0, 14.0, 16.0],
])
n_control, T0 = 2, 2
Y0_pre = Y[:n_control, :T0]       # (N0=2, T0=2)
Y0_post = Y[:n_control, T0:]      # (N0=2, Tpost=2)
Y1_pre = Y[n_control:, :T0].mean(axis=0)  # (T0=2,)
Y1_post = Y[n_control:, T0:].mean()       # scalar

# 凸单纯形上的最小二乘;目标含可消去的自由截距。
def simplex_weights(target, candidates, ridge=1e-8):
    k = candidates.shape[1]
    def loss(w):
        residual = target - candidates @ w
        # 消去自由截距:只匹配形状,允许固定的水平差。
        residual = residual - residual.mean()
        return float(residual @ residual + ridge * (w @ w))
    result = minimize(
        loss, np.full(k, 1.0 / k), method="SLSQP",
        bounds=[(0.0, 1.0)] * k,
        constraints=[{"type": "eq", "fun": lambda w: w.sum() - 1.0}],
        options={"ftol": 1e-12, "maxiter": 1000},
    )
    if not result.success:
        raise RuntimeError(result.message)
    return result.x

# ω: 匹配处理组与供体在处理前的走势;截距吸收水平差。
omega = simplex_weights(Y1_pre, Y0_pre.T)
# λ: 匹配控制单位处理前加权时期与处理后均值;截距吸收水平差。
# target shape=(N0,), candidates shape=(N0, T0)
lam = simplex_weights(Y0_post.mean(axis=1), Y0_pre)

tr_pre = float(lam @ Y1_pre)
tr_post = Y1_post
co_pre = float(omega @ Y0_pre @ lam)
co_post = float(omega @ Y0_post.mean(axis=1))
tau = (tr_post - tr_pre) - (co_post - co_pre)
print("omega", omega, "lambda", lam, "tau", tau)
# omega≈[0.5, 0.5], lambda≈[0.5, 0.5], tau≈4.0矩阵乘法的维度可以逐项验算:omega (N0,) @ Y0_pre (N0,T0) 得到供体加权的处理前序列 ;再乘 lam (T0,) 得处理前标量。Y0_post.mean(axis=1) 对时间轴求均值,输出每个供体的处理后均值 。scipy.optimize.minimize 的 SLSQP 接受目标函数、边界、等式约束和停止选项;必须看 success,并另验权重和、非负性与预测误差。SciPy 官方当前接口和约束形式见 SLSQP 文档 ↗。
上面代码中的单位权重目标简化为匹配处理前时间均值;论文实现会根据模型规格用完整面板结构学习单位权重,并给权重目标加与误差尺度有关的正则项。这段代码是可审计的教学最小版本,不应冒充成熟 SDID 软件包,也没有估计不确定性。
04 检查假设、权重与推断层级#
- 检查处理前拟合:报告加权处理前差距、单位权重与时间权重图。权重很集中时,逐个删去最大权重供体重算敏感性。
- 确认处理时序:示例要求共同处理起点。若单位错时上线,先定义 cohort-specific 风险集和 estimand;传统双向固定效应可能把已处理单位当成后处理对照。
- 处理缺失和分母:固定单位、周次和指标口径。比例指标先加总分子与分母再求比率,避免小城市被自动等权。
- 谨慎做推断:SDID 点估计本身不提供标准误。原论文讨论按单位和时间方向的 jackknife、placebo 与 bootstrap 等推断方式;做法要匹配单位数量、处理分配层级和时间依赖。单个处理城市、极少供体时,常规聚类稳健标准误并不能凭空创造随机化。
- 冻结数据版本:保存面板快照、缺失规则、处理时点、权重、优化器状态、代码 commit 和敏感性结果。若供体受到跨城流量溢出,优化出的权重无法把它“洗成”未处理状态。
| 诊断 | 常见原因 | 应对 |
|---|---|---|
| 单位权重集中在一个城市 | 供体结构差异、目标在凸包边缘 | 删一供体敏感性;检查是否只能外推 |
| 时间权重压在临近上线的一周 | 季节/埋点突变或时间窗口太短 | 固定规则做伪上线日和窗口敏感性 |
| 权重随正则极小变化 | 候选轨迹共线、样本少 | 报告预测轨迹而非过度解读权重 |
| 处理前拟合差、处理后差很大 | 供体池不可比或指标口径变动 | 先修数据或放弃因果解读 |
| 估计很稳定但只有几个处理单位 | 单位数不足以支持推断 | 把不确定性作为主要结果,避免显著性承诺 |
键盘可展开:拟合得像,为什么仍可能不是因果效果?
优化只说明所选供体和时期在给定目标下贴近处理组。若处理组同期有独有促销、供体被处理溢出、处理前关系在上线后改变,潜在反事实仍会错。用 Tab 聚焦摘要,按 Enter 或 Space 展开;窄屏可点按。
和 SCM、DiD、交互固定效应的区别#
| 方法 | 权重/结构 | 典型适用问题 | 主要限制 |
|---|---|---|---|
| DiD | 单位固定效应、时间固定效应 | 有可比对照且平行趋势可信 | 组间趋势偏离会带来偏差 |
| SCM | 供体单位凸权重 | 一个/少数处理单位,处理前可拟合 | 不单独校正共同时间偏移;处理单位需在供体凸包附近 |
| SDID | 供体权重 + 处理前时间权重 | 单位与时期两侧都需数据驱动加权 | 共同处理时点最清晰;权重与推断仍需设计说明 |
| 交互固定效应 | 单位载荷 × 时间因子 | 多单位、潜在冲击随时间改变 | 因子数、缺失模式与处理前长度影响识别 |
SDID 的双重权重不会消除同期混杂,也不等于先跑 SCM 再跑 DiD;权重是共同估计对象,目标函数和推断要整体交代。下一篇将讨论当共同冲击随单位载荷变化时,怎样用交互固定效应构造潜在反事实。
思考练习#
- 若处理组加权前后变化为 7.2,合成供体变化为 2.7,SDID 点估计是多少?如果把单位顺序误排导致供体权重落到处理城市,会出现什么泄漏?
- 某供体权重为 0.95;分别移除此城市并重估、保留但将其结果滞后一周,两个分析各在检查什么风险?
- 三座城市在不同周上线新模型。为什么不能直接把所有“上线后”单元合并套用共同处理时点公式?如何定义每个时点的未处理供体?
延伸阅读#
- Arkhangelsky, Athey, Hirshberg, Imbens & Wager, Synthetic Difference-in-Differences (AER, 2021) ↗ — 提出双重加权估计及其推断。
- Abadie, Diamond & Hainmueller, Synthetic Control Methods for Comparative Case Studies (JASA, 2010) ↗ — 经典合成控制方法。
- Ben-Michael, Feller & Rothstein, The Augmented Synthetic Control Method (JASA, 2021) ↗ — 通过结果模型修正不完全处理前拟合。
- Xu, Generalized Synthetic Control Method (Political Analysis, 2017) ↗ — 用交互固定效应估计面板反事实。
上一篇把处理城市与加权供体组成一个反事实;本篇再加上处理前时期权重,缓解单位和时间两侧的错配。学习路线从单处理单位的加权比较走向共享潜在因子模型:下一篇看这些“共同因子”怎样成为错时处理面板中的低秩数据流。