一次回答慢了 2 秒,时间究竟丢在哪?LLM Request Tracing 的 Span、关键路径与采样
从一个端到端慢请求出发,构造跨网关、排队、Prefill、Decode、工具与流式传输的时间线,手算关键路径并用 OpenTelemetry 落地安全采样。
上一篇的 Shadow Evaluation 会同时经过网关、队列、模型、检索与工具。若候选版端到端慢了 2 秒,只看一条 latency=2.8s 日志,无法区分排队拥塞、长 Prompt、慢工具,还是最后一段流式传输。
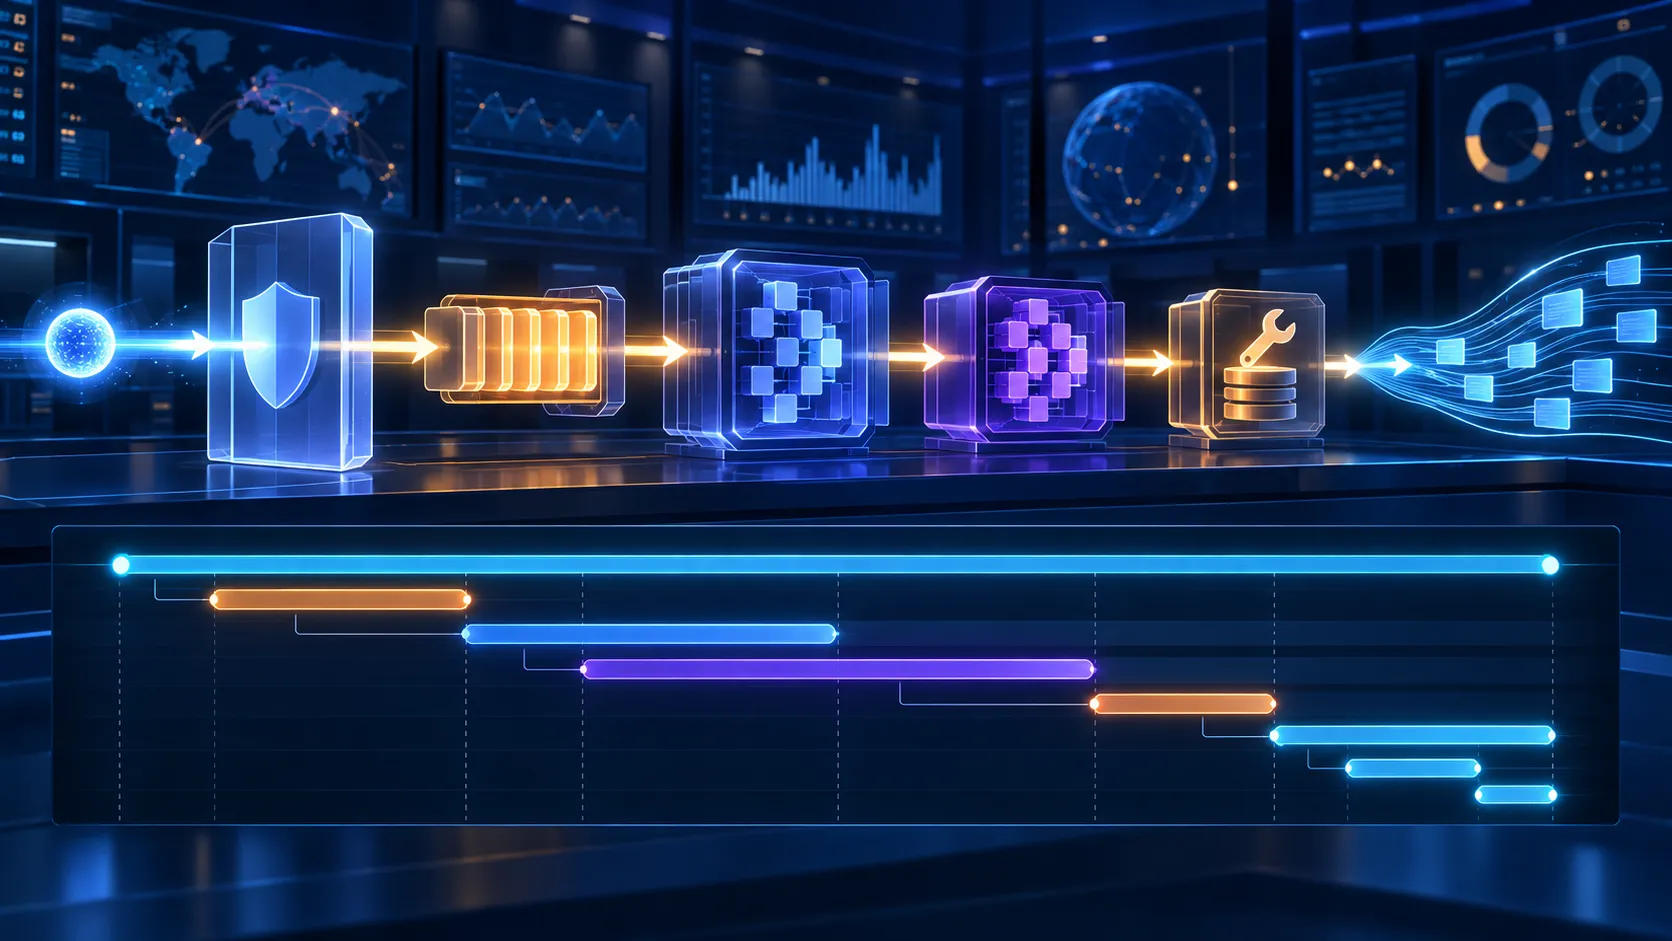
Distributed Tracing(分布式追踪)为一次请求建立共同的 trace_id,再把每个有明确起止时间的操作表示为 Span(跨度)。本篇只讲四件事:上下文传播、LLM 阶段划分、关键路径和安全采样。
01 Trace 不是“更多日志”,而是一棵带时间的因果树#
flowchart LR
  U[Client] --> G[Gateway span]
  G --> Q[Queue span]
  Q --> P[Prefill span]
  P --> D1[Decode span]
  D1 --> T[Tool span]
  T --> D2[Resume decode span]
  D2 --> S[Stream span]
  G -. traceparent .-> Q
  Q -. context .-> P
D1 -. tool context .-> T一条 Span 至少有:
trace_id:把跨服务操作连成一次请求;span_id与parent_span_id:表达父子关系;- 开始时间和持续时间;
- 低基数属性,例如服务、模型版本、操作类型与状态;
- 事件(Event),例如首 token、重试和异常。
请求 ID 只能帮助搜索日志;它没有标准父子结构、采样语义和跨进程上下文。Trace 也不等于 Python profiler:前者解释服务间等待与因果,后者解释一个进程内部函数或 kernel 消耗。
02 LLM 请求应该切成哪些 Span?#
最小但有用的层次是:
| Span | 输入/输出 | 主要回答 |
|---|---|---|
llm.request | 请求 → 完成/失败 | 用户端到端经历了什么 |
queue.wait | 入队 → 获得执行槽 | 容量是否不足 |
model.prefill | [B,L] token → 首步 logits/KV | TTFT 是否被长输入拖慢 |
model.decode | KV + 新 token → 输出 token 流 | TPOT 是否异常 |
tool.execute | 工具名 + 脱敏参数 → 结果 | 外部依赖是否在关键路径 |
response.stream | 首字节 → 末字节 | 客户端或网络是否慢 |
不要给每个 token 建 Span:一次 2000-token 回答会制造 2000 个对象。逐 token 时延适合 Histogram(直方图)或少量事件;Span 留给有业务意义、带持续时间且能独立失败的阶段。
03 数据与张量怎样进入追踪属性?#
设输入 token 为
Prefill 后每层 KV Cache 近似为
Decode 第 步通常输入新 token ,输出 logits 。追踪系统不应保存这些张量本身,而只记录可聚合的形状和计数:input_tokens=L、output_tokens=T、batch_size=B、kv_bytes、model_revision。
Prompt、输出、检索文档与工具参数常含个人信息或密钥。即使 OpenTelemetry 允许 opt-in 内容属性,也应默认关闭;需要调试时使用短 TTL、严格授权和脱敏后的独立存储,而不是把正文塞进 Span。
04 极小手算:为什么端到端时间不是 Span 求和?#
一次请求的时间如下:
| 操作 | 区间(ms) | 时长 |
|---|---|---|
| Gateway | 0–30 | 30 |
| Queue | 30–110 | 80 |
| Prefill | 110–230 | 120 |
| Decode A | 230–390 | 160 |
| Tool | 390–630 | 240 |
| Decode B | 630–810 | 180 |
| Stream | 260–850 | 590 |
所有 Span 时长相加为 ms,但用户只等了 ms,因为 Stream 与 Decode/Tool 重叠。端到端时长由根 Span 决定;Critical Path(关键路径)是从开始到结束、任何缩短都可能降低端到端延迟的依赖链。
若工具执行必须结束后才能继续 Decode B,则同步关键链为
最后一个流式字节在 850 ms 到达,所以当前尾部 40 ms 仍由流式收尾决定。优化一个与关键路径完全重叠的异步审计 Span,不会让用户更快。
请求关键路径实验室
改变排队或工具耗时,观察端到端延迟为何不是所有 span 的简单相加。
05 TTFT、TPOT 与 E2E 必须能从同一时间线复算#
设接收请求时刻为 ,首 token 到达网关为 ,最后 token 完成为 ,输出 token 数为 :
Trace 中应记录原始边界时间或相应事件,使指标能复算。不要把 TTFT + T×TPOT 当作严格恒等式:批调度、工具暂停、客户端背压与最后一包刷新都会破坏它。
06 跨进程上下文怎样保持同一条 Trace?#
HTTP 服务通常传播 W3C traceparent:
00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01
│  └──────────── trace-id ────────────┘ └─ parent ─┘ └ sampled
└ version队列边界更容易断链。Producer 注入 carrier,Consumer 提取后以远程上下文为 parent;若一条批消息包含多个独立请求,不要随便挑一个做父节点,可用 Span Link 表示“此 batch 由这些 trace 共同导致”。
gateway:
  start SERVER span
  inject trace context into queue envelope

worker:
  extract context
  start CONSUMER span with extracted parent
  start queue.wait and model spans beneath it

tool client:
inject current context into outbound request异步任务若在原请求结束后独立执行,用 link 往往比伪造父子持续时间更准确。
07 用当前 OpenTelemetry Python API 落地#
官方当前文档将 Trace 与 Metrics 标为 Stable,并建议应用安装 API + SDK、生产环境使用 BatchSpanProcessor 和 OTLP Exporter,经 Collector 输出。下面省略业务实现,只展示边界:
from contextlib import contextmanager
from time import perf_counter

from opentelemetry import trace
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter
from opentelemetry.sdk.resources import Resource, SERVICE_NAME
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.trace import Status, StatusCode

provider = TracerProvider(
    resource=Resource.create({SERVICE_NAME: "llm-worker"})
)
provider.add_span_processor(
    BatchSpanProcessor(OTLPSpanExporter(endpoint="http://otel:4318/v1/traces"))
)
trace.set_tracer_provider(provider)
tracer = trace.get_tracer("example.llm-serving", "1.0.0")


@contextmanager
def stage(name: str, **attributes: int | str | bool):
    with tracer.start_as_current_span(name, attributes=attributes) as span:
        started = perf_counter()
        try:
            yield span
        except Exception as error:
            span.record_exception(error)
            span.set_status(Status(StatusCode.ERROR))
            raise
        finally:
            span.set_attribute("example.stage.duration_ms", (perf_counter() - started) * 1000)


def generate(token_ids: list[int], model_revision: str) -> list[int]:
    with tracer.start_as_current_span("llm.request") as root:
        root.set_attributes({
            "gen_ai.operation.name": "chat",
            "gen_ai.request.model": model_revision,
            "gen_ai.usage.input_tokens": len(token_ids),
        })
        with stage("example.queue.wait", **{"example.queue.name": "decode"}):
            lease = acquire_slot()
        with stage("example.model.prefill", **{"example.input_tokens": len(token_ids)}):
            state = prefill(token_ids, lease)
        with stage("example.model.decode") as decode_span:
            output = decode(state)
            decode_span.add_event("first_token")
            decode_span.set_attribute("gen_ai.usage.output_tokens", len(output))
return outputBatchSpanProcessor 把导出移出请求热路径,但内存队列、批大小和 shutdown flush 仍需验证。应用不要在每次请求中重新初始化 TracerProvider。
08 属性、事件和 Span 怎样选择?#
- 有持续时间、能独立失败:Span,例如工具 RPC。
- 描述整个操作、适合筛选:Attribute,例如模型 revision。
- 某个时点发生、可能重复:Event,例如 retry 或 first_token。
- 高频数值分布:Metric,例如每 token 延迟。
Span 名必须低基数:tool.execute 是好名字,tool.execute user-9281 weather-Beijing 会让索引爆炸。动态值放属性,并且先判断是否应该采集。
09 Head Sampling 与 Tail Sampling 有何不同?#
Head Sampling(头部采样)在 Trace 开始时决定是否保留,成本低,却还不知道最终是否慢或失败。Tail Sampling(尾部采样)在 Collector 看到完整或接近完整的 Trace 后决定,能保留错误与高延迟样本,但需要缓存未决 Trace。
一个实用策略是:
keep if error = true
keep if e2e_ms > 5000
keep if tenant_tier = "test" and debug_allowed
otherwise keep deterministic 1%确定性按 trace_id 采样能让整条链做一致决定。不要让每个服务独立随机 1%,否则有 6 个服务时保留完整链的概率仅为 。
10 成本与高基数怎样估算?#
若每请求平均 9 个 Span、每 Span 序列化后约 1.2 KB,请求率为 800 QPS,全量日写入近似为
5% 采样仍约 37 GB/day,且索引、复制和保留会进一步放大。先定义“哪些问题必须能回答”,再决定 Span 和属性;追踪不是越细越好。
需要单请求定位的 trace_id 可高基数但不应拿来做指标标签。模型版本、区域、状态、任务类型适合聚合;用户 ID、Prompt hash、会话 ID 不适合进入 metrics dimensions。
11 最短调试路径#
| 现象 | 常见原因 | 首先检查 |
|---|---|---|
| Trace 到 worker 断了 | 队列信封未传播 context | producer inject / consumer extract |
| 父 Span 比子 Span 先结束 | 异步生命周期建模错误 | parent、link 与 await 边界 |
| E2E 小于子 Span 求和 | 并发与嵌套,通常正常 | 时间区间而非时长总和 |
| TTFT 高、Prefill 正常 | queue、路由或网络等待 | 根、queue、stream 的边界 |
| 只缺慢请求 | head sampling 丢掉了结果信息 | tail policy 与 Collector 缓冲 |
| 存储突然暴涨 | token/user 放进 span name 或标签 | cardinality top-N |
| Trace 泄露 Prompt | 内容属性默认开启 | SDK 配置、processor 过滤、TTL |
先验证时钟、上下文和边界,再解释性能。错误的父子关系会画出很漂亮但完全虚假的瀑布图。
12 失败场景与局限#
- Trace 告诉你“慢在哪一段”,不自动解释 CUDA kernel 为什么慢;还需 profiler。
- 被丢弃的 Trace 无法用于事后单请求调查,采样永远是信息损失。
- Tail Sampling 可能因 Collector 内存不足而先丢最长、最有价值的 Trace。
- 时钟漂移会让跨主机时间线出现负间隔;优先用持续时间并监控 NTP。
- 客户端断开不一定代表模型失败;错误语义必须区分取消、超时和服务错误。
- 内容默认不采集会降低可复现性,但隐私与安全优先于调试便利。
13 Trace、Metric、Log 与 Profile 的边界#
| 信号 | 擅长回答 | 不擅长回答 |
|---|---|---|
| Metric | 系统是否整体异常 | 哪一次请求发生了什么 |
| Trace | 单请求的因果与关键路径 | 函数/Kernel 细节 |
| Log | 某时点的丰富上下文 | 自动恢复跨服务结构 |
| Profile | CPU/GPU 时间花在哪里 | 跨服务排队与用户体验 |
成熟系统通常从 Metric 发现 p99 异常,借 exemplar 或 trace_id 跳到 Trace,再对异常 Span 的进程做 Profile,而不是让一种信号承担所有工作。
14 今天真正需要记住什么?#
- 同一
trace_id和正确的 parent/link 关系,才把网关、队列、模型与工具连成可解释时间线。 - 端到端延迟看关键路径,不看 Span 时长总和;重叠工作不能重复计算。
- LLM Trace 记录形状、token 数、版本与阶段,不默认记录 Prompt 和输出正文。
- Span 名与指标标签必须低基数;错误和慢请求适合 Tail Sampling,其余请求做一致性概率采样。
15 思考题与小练习#
- 某请求的检索 200 ms 与安全检查 150 ms 并行,之后 Prefill 300 ms、Decode 700 ms。忽略其他开销,手算关键路径;若把安全检查降到 20 ms,E2E 是否改变?
- 设计一个批调度 Span:一批含 8 个独立请求时,应该选择单一 parent 还是 8 个 links?哪些属性仍可低基数聚合?
- 将示例代码扩展为“错误必留、E2E 超 5 秒必留、其余 2%”的 Collector tail policy,并估算 1000 QPS、每请求 10 KB 时的日存储量。
相关工作#
- Sigelman et al., Dapper, a Large-Scale Distributed Systems Tracing Infrastructure ↗,奠定低开销采样与跨服务 Trace 的经典设计。
- Fonseca et al., X-Trace: A Pervasive Network Tracing Framework ↗,讨论跨层传播因果标识。
- Dean & Barroso, The Tail at Scale ↗,解释为什么平均延迟无法代表大规模在线服务体验。
- OpenTelemetry, Python Instrumentation ↗ 与 Exporters ↗,给出当前 Tracer、状态、异常、BatchSpanProcessor 与 OTLP 用法。
- OpenTelemetry, GenAI Semantic Conventions ↗,提供仍在演进的 GenAI span、metric 与 event 约定。
16 下一篇预告#
Tracing 能解释已经采到的一次慢请求,但线上回答质量常没有即时标签,也不会以异常堆栈的形式失败。下一篇将进入 LLM Online Quality Drift:如何用参考窗口、任务切片和 CUSUM 累积微小回退,又怎样区分模型漂移、流量变化与评测器漂移。