不让用户看见新版回答,怎样用真实流量先验收?LLM Shadow Evaluation 的镜像、配对与副作用隔离
从离线集与线上分布错位出发,设计隐私安全的请求镜像、确定性重放、逐请求配对比较、容量预算与副作用隔离。
上一篇用真实用户上的小比例 Canary 流量回答“何时可以扩量”。但高风险模型、工具调用代理或隐私敏感业务常常连 1% 的错误输出都不愿直接交给用户;另一方面,离线评测集又无法复现今天真实的 prompt 长度、语言、检索结果和并发形状。
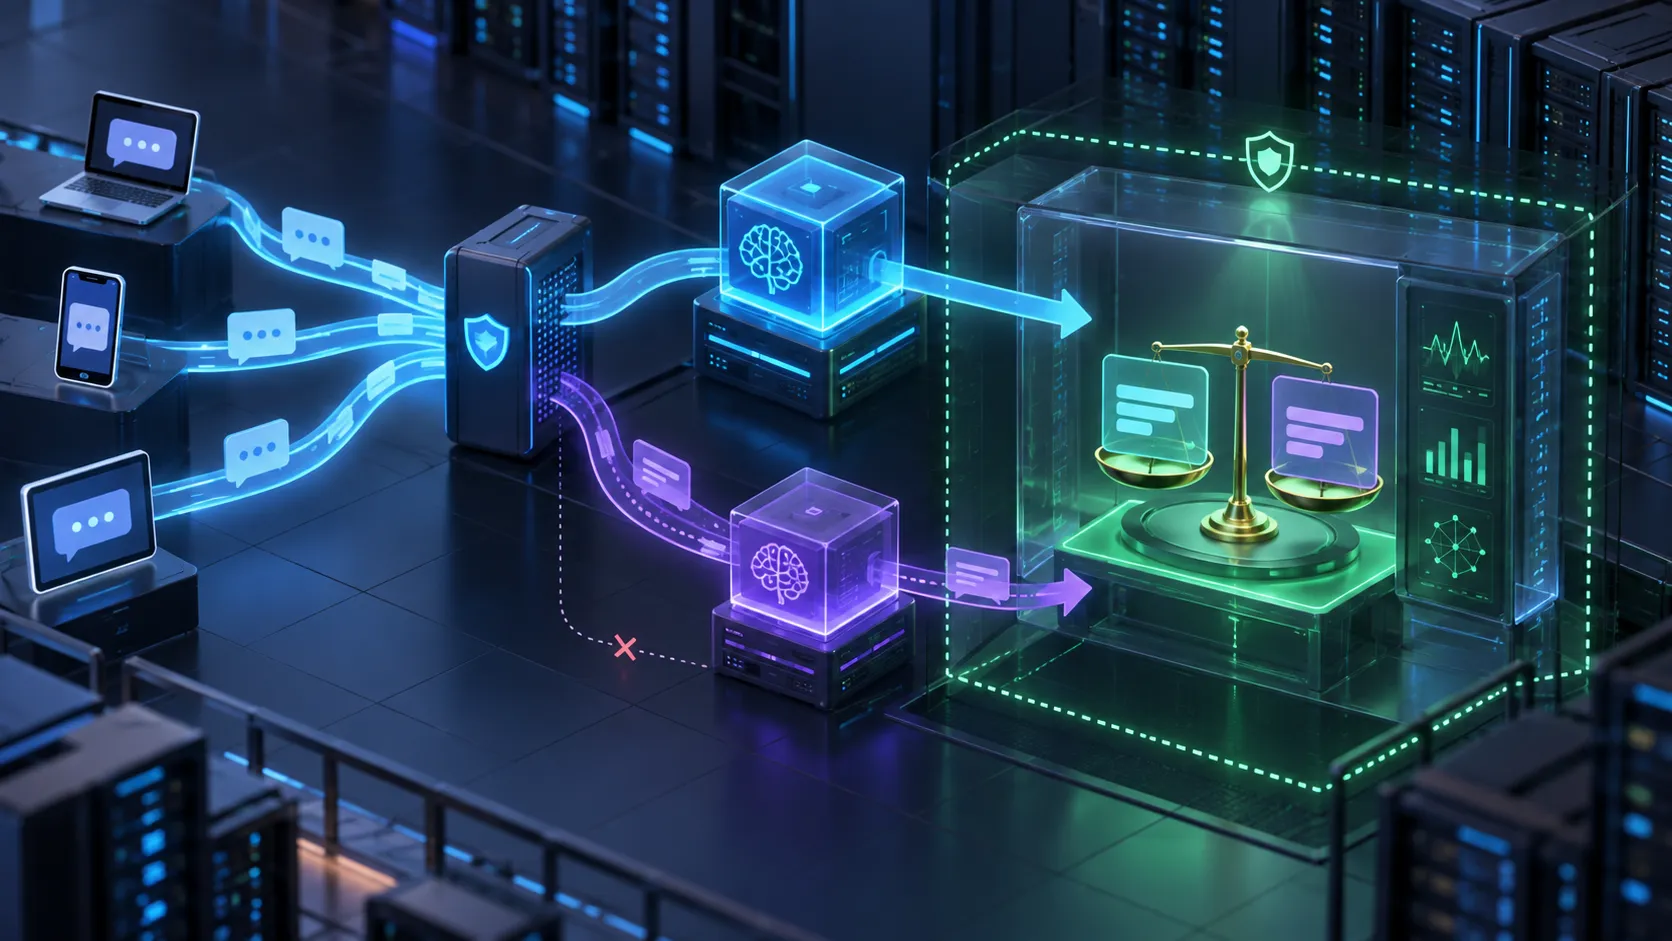
Shadow Evaluation(影子评测)把一份真实请求复制给候选版本,却只把稳定版响应返回用户。候选输出进入隔离的评测管道,用来比较质量、延迟和资源,而不能触发业务副作用。本篇只讲四件事:安全镜像、可复现执行、配对比较和容量/隐私边界。
01 Shadow 的核心契约:读同样的输入,不产生用户可见效果#
sequenceDiagram
  participant U as User
  participant G as Gateway
  participant S as Stable v0
  participant Q as Shadow Queue
  participant C as Candidate v1
  participant E as Evaluator
  U->>G: prompt + context
  par 用户路径
    G->>S: production request
    S-->>G: stable response
    G-->>U: only this response
  and 影子路径
    G-->>Q: sanitized envelope
    Q->>C: replay, side effects disabled
    C-->>E: candidate response + trace
    S-->>E: stable response + trace
    E->>E: paired comparison
end这里的“不产生效果”至少包括:
- 候选响应不能返回用户,也不能写入会话历史;
- 不发送邮件、付款、工单、数据库写入或外部 API 调用;
- 不更新生产缓存、用户画像、长期记忆或推荐状态;
- 不把 shadow 事件计入真实账单、限额和业务转化;
- 失败和排队不能反压稳定版主链路。
因此 Shadow 不是在网关里同步 await 两次模型。主请求只负责尽力投递一个有界、可丢弃的影子信封;队列满时丢 Shadow,也不能拖慢用户。
02 一条可审计的请求信封包含什么?#
{
  "shadow_id": "01K…",
  "captured_at": "2026-09-20T12:30:00Z",
  "stable_digest": "sha256:…",
  "candidate_digest": "sha256:…",
  "tokenizer_digest": "sha256:…",
  "sanitized_messages": [
    { "role": "system", "content_ref": "policy:v17" },
    { "role": "user", "content_ref": "encrypted:blob-id" }
  ],
  "sampling": { "temperature": 0.0, "max_tokens": 256, "seed": 42 },
  "tool_mode": "recorded-readonly",
  "expires_at": "2026-09-21T12:30:00Z"
}关键输入不是只有 prompt 文本,还包括系统提示版本、tokenizer、检索快照、工具返回、采样参数、最大长度和模型 digest。否则“同一问题”会因外部知识或随机性变化,比较的就不只是模型版本。
信封应有短 TTL、访问审计、租户允许标志和数据分类。若原请求不允许二次处理,必须在网关直接排除,而不是先落盘再删除。
03 数据流与张量:两次推理哪里必须相同?#
设清洗并 tokenize 后的输入为
其中 是批大小、 是 padding 后长度, 是 attention mask。稳定版和候选版分别产生第 步 logits:
若词表或 tokenizer 变了, 与 甚至可能不同,不能逐维比较 logits;应比较解码后的任务结果、序列级 log-probability 或映射后的共享 token。若 tokenizer 相同且使用 teacher forcing,可比较同一参考序列 的 token loss:
temperature=0 有助于复现,但不保证所有 GPU kernel、量化实现和并行归约逐 bit 确定。比较协议要容忍合理数值抖动,同时固定真正能固定的输入。
04 为什么配对比较比两个独立均值更灵敏?#
同一请求 在稳定版与候选版上的质量分数分别为 ,先计算逐请求差值
配对均值的标准误为
其中 是差值的样本标准差。由于两版本面对完全相同的请求,请求难度这部分共同噪声会在相减时抵消。
极小手算例子#
四条请求的分数如下:
| 请求 | 稳定版 | 候选版 | 差值 |
|---|---|---|---|
| 短问答 | 0.82 | 0.86 | +0.04 |
| 长文总结 | 0.74 | 0.77 | +0.03 |
| 代码修复 | 0.68 | 0.59 | -0.09 |
| 检索回答 | 0.79 | 0.83 | +0.04 |
总体平均差为 ,几乎持平;但代码切片回退 0.09。Shadow 的价值不只是给一个总分,而是以相同输入暴露“哪些请求翻转了胜负”。
配对 Shadow 评测实验室
同一批请求同时喂给稳定版和候选版;切换样本,观察逐请求差值如何抵消难度噪声。
05 质量比较不能只靠一个 LLM Judge#
评测应按任务选择信号:
| 任务 | 首选确定性信号 | 辅助模型信号 |
|---|---|---|
| 结构化 JSON | schema、字段与约束验证 | 内容相关性 |
| 代码生成 | 编译、单测、静态检查 | 可读性与解释质量 |
| RAG 问答 | 引用存在、证据蕴含、拒答规则 | 完整性与表达 |
| 摘要 | 关键事实覆盖、数字一致性 | 连贯、冗余、风格 |
| 安全策略 | 明确规则与红队断言 | 边界案例分级 |
Pairwise Judge(成对裁判)应随机交换 A/B 位置,避免位置偏差;隐藏模型名称,避免品牌偏差;对平局单独编码,而不是强迫二选一。裁判模型、提示词、温度与版本都必须进入评测记录。
06 工具调用怎样阻断副作用?#
Shadow Agent 若真的调用 send_email 或 charge_card,事故会发生在用户看不到的路径上。工具层应把操作分成三类:
- 纯读且可复制:使用拍摄时缓存的检索/数据库只读结果;
- 不稳定读:记录 production 的返回并重放,避免两次调用看到不同世界;
- 写操作:只验证参数 schema 和策略,返回模拟 receipt,永不触达生产系统。
shadow_tool_call(name, arguments):
    policy = registry[name]
    if policy.mode == "recorded-readonly":
        return encrypted_recording.lookup(call_fingerprint)
    if policy.mode == "simulate-write":
        validate_schema(arguments)
        return {"status": "simulated", "effect_id": null}
raise ShadowPolicyViolation(name)网络层再加一道 egress allowlist,防止应用逻辑配置错误绕过 mock。安全依赖分层防御,而不是相信一个 shadow=true 布尔值传遍所有服务。
07 在线镜像与离线重放有什么区别?#
| 模式 | 优点 | 局限 |
|---|---|---|
| 在线同步镜像 | 同时段、同外部状态 | 最易影响主链路,成本峰值重合 |
| 在线异步队列 | 与主链路解耦,可限速 | 候选执行有时间偏移 |
| 脱敏后离线重放 | 可反复比较多个版本 | 状态陈旧、保留数据风险 |
| 合成/固定评测集 | 可复现、易做回归门禁 | 与实时分布存在差距 |
实践中通常组合:固定集负责每次提交的快速回归,离线重放覆盖真实长尾,在线异步 Shadow 验证当前流量与并发。三者证据不同,不能互相冒充。
08 用 Python 计算配对差值与分层翻转#
下面的实现输入逐请求的稳定/候选分数与切片,输出总体均值差、近似区间及各切片差值。缺少任一侧结果的请求不应偷偷填 0,而要单独报告配对完成率。
from collections import defaultdict
from dataclasses import dataclass
from math import sqrt


@dataclass(frozen=True)
class Pair:
    request_id: str
    slice_name: str
    stable_score: float
    candidate_score: float


def paired_report(rows: list[Pair]) -> dict[str, object]:
    if len(rows) < 2:
        raise ValueError("need at least two complete pairs")

    differences = [row.candidate_score - row.stable_score for row in rows]
    mean = sum(differences) / len(differences)
    variance = sum((value - mean) ** 2 for value in differences) / (len(rows) - 1)
    standard_error = sqrt(variance / len(rows))

    buckets: dict[str, list[float]] = defaultdict(list)
    for row, difference in zip(rows, differences, strict=True):
        buckets[row.slice_name].append(difference)

    return {
        "pairs": len(rows),
        "mean_difference": mean,
        "approx_95_interval": (
            mean - 1.96 * standard_error,
            mean + 1.96 * standard_error,
        ),
        "slice_means": {
            name: sum(values) / len(values) for name, values in buckets.items()
        },
}对文中的四条数据,mean_difference 为 0.005,代码切片为 -0.09。样本只有四条,区间只用于演示;正式报告还要给每层样本数、缺失原因和预注册阈值。
09 延迟比较为什么不能直接看 Shadow 的墙钟时间?#
Shadow 常被低优先级队列延后,还可能与稳定版争抢 GPU。它测到的端到端时间包含排队策略:
若要比较模型执行效率,应在候选服务内部记录 Prefill、Decode、token 数和 batch 形状;若要做容量演练,则保留真实到达节奏,但必须给 Shadow 独立资源池或明确的优先级上限。
假设线上稳定池使用 8 张 GPU、平均利用率 65%。把 100% 请求同步双跑并不意味着“还有 35% 就够了”:候选版本的 batch、KV 长度和 output 分布会形成新峰值。安全预算应近似为
其中 是采样比例, 是请求率, 是候选版平均 GPU 秒/请求, 是允许的每 GPU 忙碌率。先从 0.1% 或固定 QPS 开始,并让队列有硬上限。
10 一个安全的采样与降载流程#
capture(request):
    if not tenant_allows_shadow(request.tenant): DROP
    if data_classification(request) > allowed_level: DROP
    if deterministic_hash(request.conversation_id) >= sample_rate: DROP

    envelope = sanitize_and_encrypt(request)
    if shadow_queue.try_push(envelope) == false:
        metric("shadow_dropped", reason="queue_full")
    return  # 永不等待候选结果

worker():
    while gpu_budget_available():
        envelope = pop_before_ttl()
run_candidate(envelope, tools="isolated")确定性采样能稳定覆盖同一会话,也便于改变采样率。还应对长输入、低频语言和高风险任务做有上限的分层过采样;最终汇总时使用相应权重恢复线上分布。
11 隐私、保留与访问控制#
- 目的限制:采集前定义用途,不能把 Shadow 日志顺手变成训练集。
- 最小化:能保存 token 数就不保存文本;需要文本时字段级脱敏、加密与短 TTL。
- 租户隔离:缓存、队列、对象存储和评测结果都带租户边界,禁止跨租户配对。
- 删除传播:用户删除请求要能定位原始信封、候选输出、裁判结果和派生索引。
- 访问审计:谁读取过明文、为了哪个实验、何时过期,都进入不可篡改审计。
- 区域约束:请求不能因为 Shadow 评测被复制到未经授权的区域或供应商。
若无法满足原数据契约,就使用合成流量或只保存不可逆统计特征。技术上能镜像不代表合规上可以镜像。
12 最短调试路径#
| 现象 | 常见原因 | 首先检查 |
|---|---|---|
| 配对完成率低 | TTL 太短、队列满、候选超时 | drop 原因、队列年龄、按长度分层完成率 |
| 候选答案事实不同 | 检索或工具结果未冻结 | 外部调用 fingerprint、快照版本 |
| 候选延迟异常高 | 低优先级排队,不是模型变慢 | capture/model queue 与执行分段 |
| 总分持平但投诉风险高 | 关键切片被总体均值稀释 | 任务、租户、语言、长度切片 |
| Shadow 影响线上 TTFT | 共用 GPU/缓存/网络且无隔离 | 资源池、优先级、带宽与 eviction |
| 工具产生真实写入 | mock 覆盖不全或 egress 未封锁 | 工具注册表、网络审计、幂等键 |
| Judge 大量偏向候选 | A/B 位置或文风偏差 | 随机换位、盲化、人工一致率 |
先验证输入是否真的成对,再比较输出。若两个版本看到的检索文档不同,所谓“模型质量差异”没有可识别性。
13 失败场景与局限#
- Shadow 看不到用户读完答案后的点击、追问、复制和满意度,不能替代真实 Canary 或 A/B Test。
- 候选输出不进入后续会话,因此多轮行为、记忆写入和闭环代理效果无法完整复现。
- 录制工具结果提高可比性,却可能掩盖候选版不同工具选择本应带来的收益或风险。
- 双跑成本可能接近一份额外线上负载;采样过低又看不到稀有切片。
- 脱敏可能改变 tokenizer 长度与语义,使性能和质量测量偏离原始请求。
- 非确定生成会扩大配对方差;需要多 seed 时,成本按 seed 数增长。
14 Shadow、日志重放与负载测试有什么区别?#
| 方法 | 输入来源 | 时间结构 | 主要回答 |
|---|---|---|---|
| Shadow | 当前真实请求 | 在线或近在线 | 当前分布下行为是否回归 |
| 日志重放 | 历史脱敏请求 | 可加速/可重复 | 多版本在固定样本上谁更好 |
| 合成压测 | 人工生成请求与节奏 | 可控极限场景 | 容量拐点、过载和恢复是否符合预期 |
日志重放适合可重复实验,合成压测适合打到极限,Shadow 最接近此刻分布。一个成熟发布门禁通常依次使用三者,再进入小流量 Canary。
15 今天真正需要记住什么?#
- Shadow 的第一契约是主链路不等待、候选输出不返回、任何写副作用都被隔离。
- 可比性需要固定模型/tokenizer/system prompt、采样参数和外部工具结果;只复制用户文本远远不够。
- 对同一请求计算逐对差值能抵消难度噪声,但总体均值仍必须配合预注册切片。
- Shadow 同时消耗 GPU、网络与存储;有界队列、独立资源和隐私 TTL 都是正确性的一部分。
16 思考题与小练习#
- 设计一个支付客服 Agent 的 Shadow 工具注册表:列出哪些调用可重放、哪些必须模拟、哪些完全禁止,并说明网络层如何兜底。
- 某 Shadow 队列每秒进入 8 个请求,候选池每秒处理 6 个,TTL 为 10 分钟。忽略波动,多久会积压 1200 条?到 TTL 时每秒会丢多少?
- 扩展上面的 Python:显式接收缺失 pair,输出总体与各切片的配对完成率;当任一关键切片低于 95% 时拒绝给出发布结论。
相关工作#
- Kohavi et al., Online Controlled Experiments at Large Scale ↗,解释对照、分层与可信实验工程。
- Ribeiro et al., CheckList: Beyond Accuracy for Behavioral Testing of NLP Models ↗,展示按能力与测试类型组织 NLP 行为评测的方法。
- Liang et al., Holistic Evaluation of Language Models ↗,讨论语言模型跨场景、指标与风险的系统评测。
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena ↗,研究成对模型评判及位置等偏差。
- Sculley et al., Hidden Technical Debt in Machine Learning Systems ↗,说明数据依赖、反馈回路与系统边界为何会积累隐性风险。
17 下一篇预告#
Shadow 与 Canary 都会产生大量跨网关、调度器、模型和工具的事件。下一篇将进入 LLM Request Tracing:怎样用同一个请求时间线定位排队、Prefill、Decode、工具调用与流式传输中的真正瓶颈,同时控制高基数与敏感数据。