-
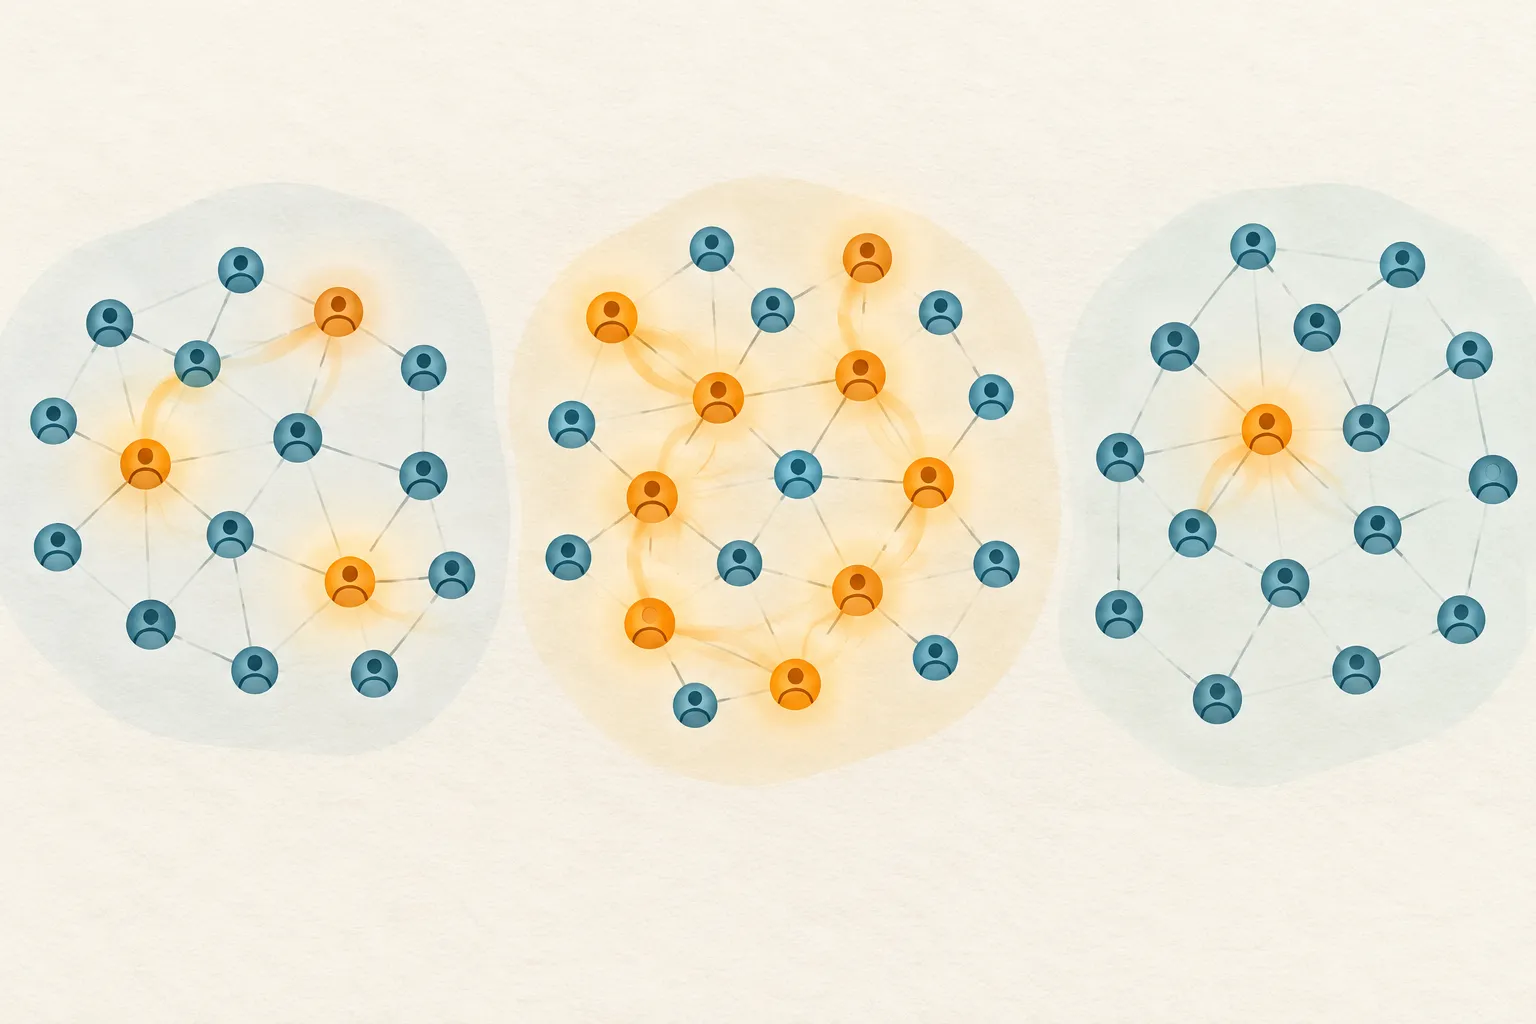 怎样区分自己的处理与邻居溢出?两阶段饱和度随机化
先随机社群的处理比例,再随机社群内个人;用手算概率拆开直接效果与溢出效果。
15 分钟 中文 -
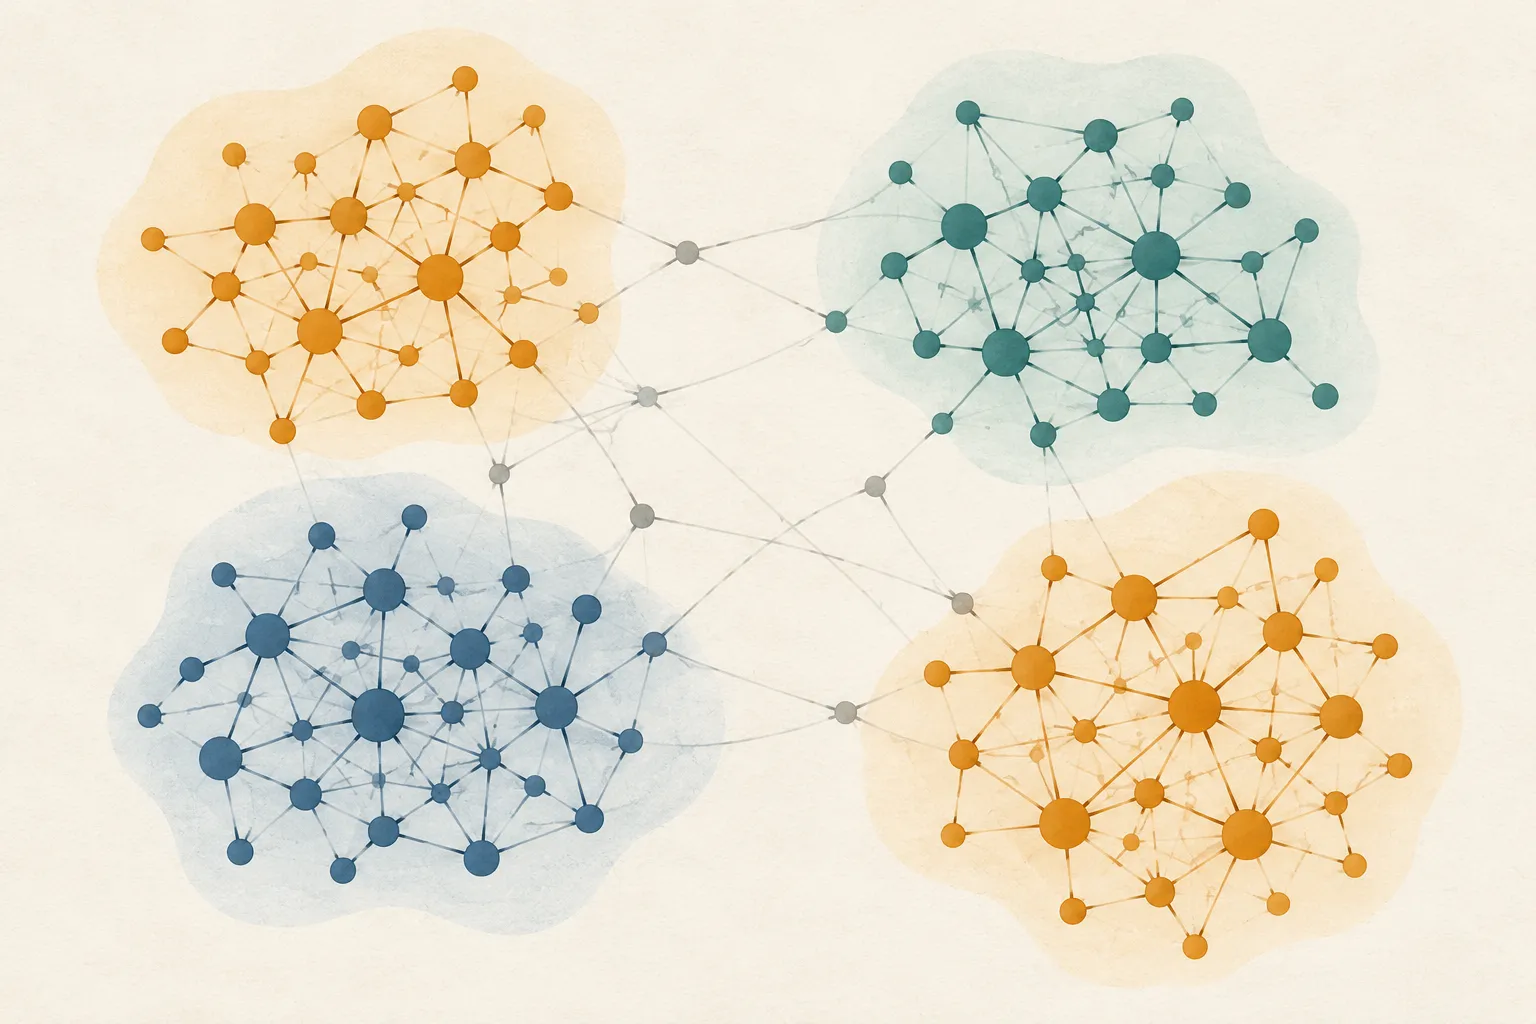 实验网络怎样分簇,才能少切断真实传播?图划分与边界泄漏
手算加权切边率,理解因果实验中的图分簇目标、规模约束和残余跨簇干扰。
15 分钟 中文 -
 处理会沿用户关系传播,怎样定义实验暴露?干扰下的 Exposure Mapping
当同事、顾客或模型服务的用户互相影响时,用暴露映射把自己的分配与邻居处理分开,并按真实随机方案计算可识别效果。
19 分钟 中文 -
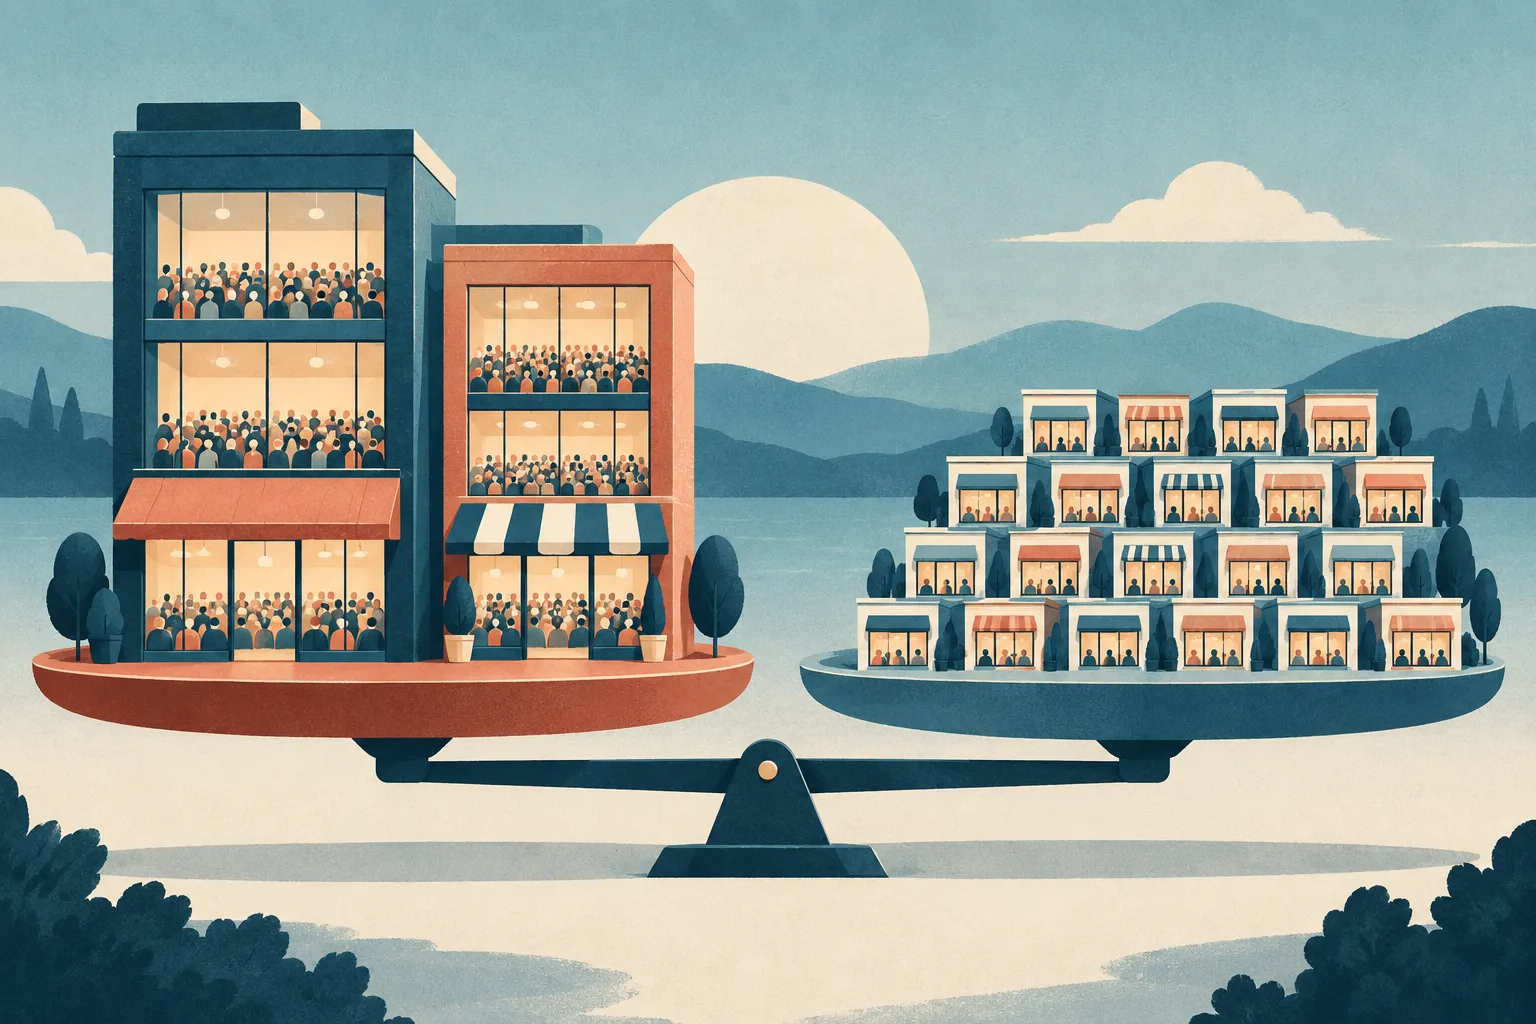 门店大小差很多,实验到底在平均谁?簇大小不等与加权估计目标
从同一组门店的用户平均与门店平均出发,拆解簇大小不等时的估计目标、聚合权重、推断与审计。
18 分钟 中文 -
 门店只有 12 家,怎样先配成 6 对再随机?配对簇实验的效应估计
把基线相近的门店配成对,在每对内随机处理与对照;推导配对差、自由度和设计一致的精确检验。
12 分钟 中文 -
 只有 8 家门店,怎样判断实验结果可信?簇随机试验的小样本推断
用户数很大也不等于独立样本很多。用簇级均值、自由度与精确随机化检验,说明小簇数实验怎样报告不确定性。
13 分钟 中文 -
 同一门店的用户互相影响,怎样做簇随机化?ICC 与设计效应
从家庭、门店和学校里的用户互相影响出发,推导簇随机化的组内相关与设计效应,用手算和纯 Python 重算实验人数。
15 分钟 中文 -
 实验中途能不能停?用预先分配的显著性预算设计序贯检验
把固定样本量和多次查看放进同一设计,用两次手算查看与纯 Python z 检验说明何时可以提前停止。
14 分钟 中文
返回