-
 预填充为何会拖慢正在生成的请求?Disaggregated Prefill/Decode 的 KV 传输与资源隔离
从 Prefill–Decode 干扰出发,追踪请求跨 P/D 实例的数据流,手算 KV 体积与传输下限,说清分离为何改善尾延迟却不自动提升吞吐。
13 分钟 中文 -
 相同长文档为何每次都要重算?Automatic Prefix Caching 的块哈希与安全隔离
从重复 prefill 出发,手算块级最长前缀命中,追踪 KV 引用与淘汰,解释链式哈希、完整块粒度、多租户隔离及当前 vLLM 配置。
18 分钟 中文 -
 生成 4 个 Token 为何不一定要跑 4 次大模型?Speculative Decoding 的提议、验证与接受
从自回归解码的串行瓶颈出发,手算 draft–verify 接受过程,推导精确采样修正,追踪张量形状,并给出可检查实现、指标与失败边界。
16 分钟 中文 -
 一个长 Prompt 为何让所有流式输出停顿?Chunked Prefill 的 Token 预算
从 prefill 阻塞 decode 的延迟尖峰出发,手算 token budget 下的分块调度,解释 KV 递增、优先级、容量保护与当前 vLLM 配置验证。
14 分钟 中文 -
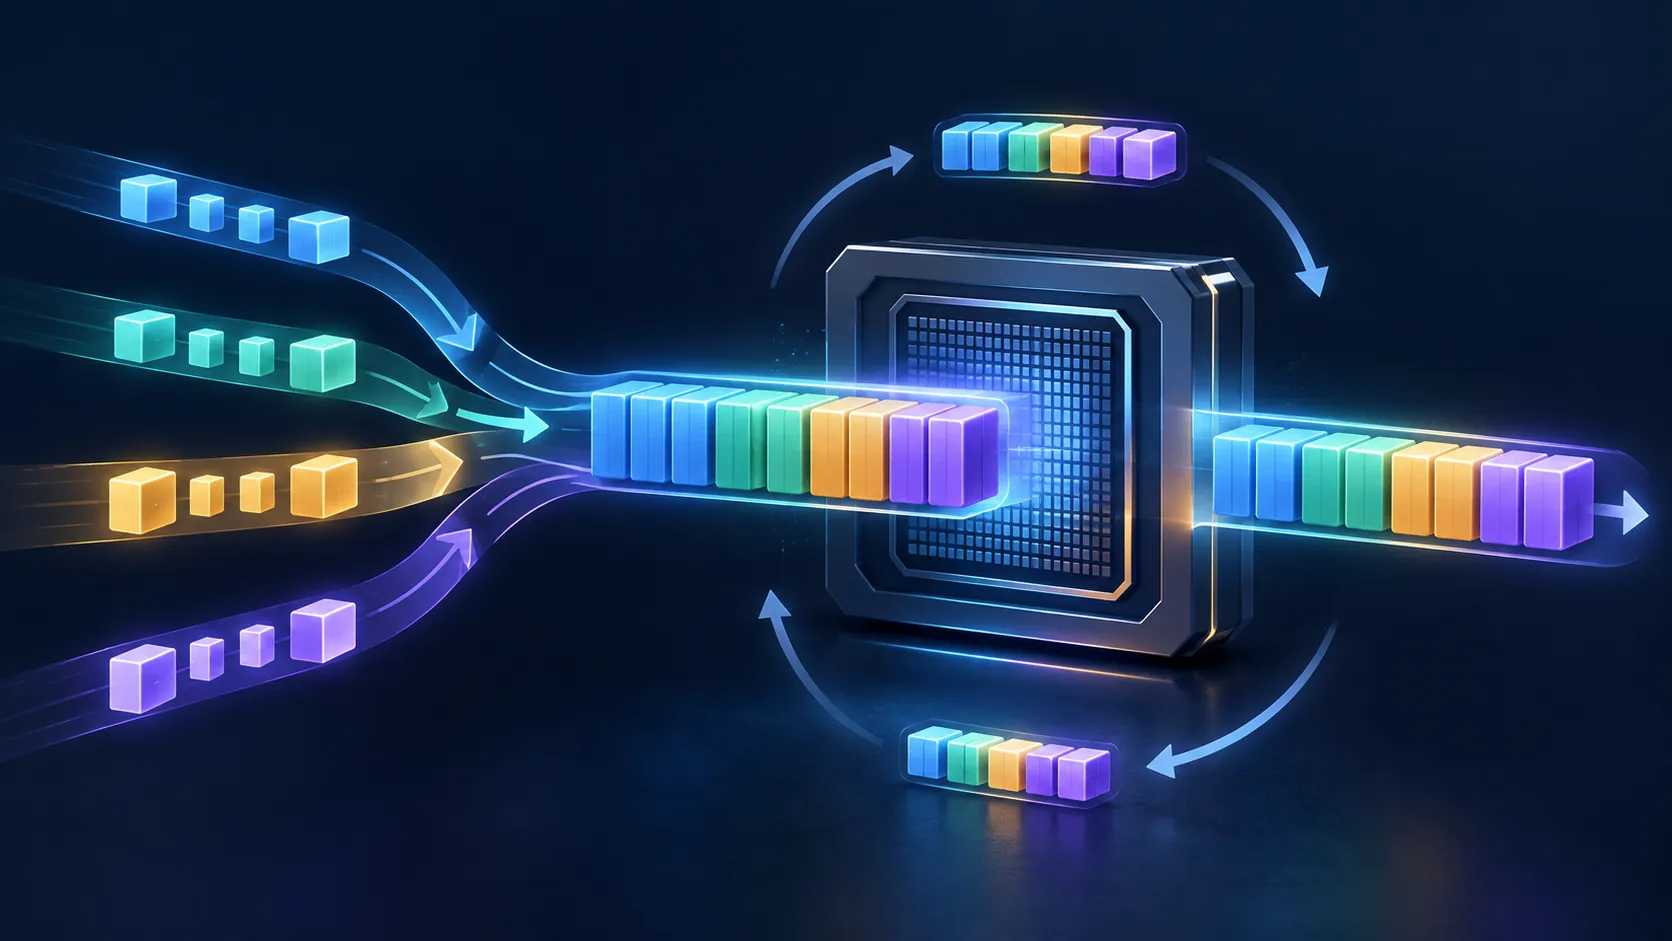 请求不断到达时为何还要等整批结束?Continuous Batching 的逐轮调度
从静态批处理的尾部空洞出发,手算逐迭代请求替换,解释 prefill/decode 混合、token 预算、KV 容量、延迟指标与可验证的 vLLM 配置。
15 分钟 中文 -
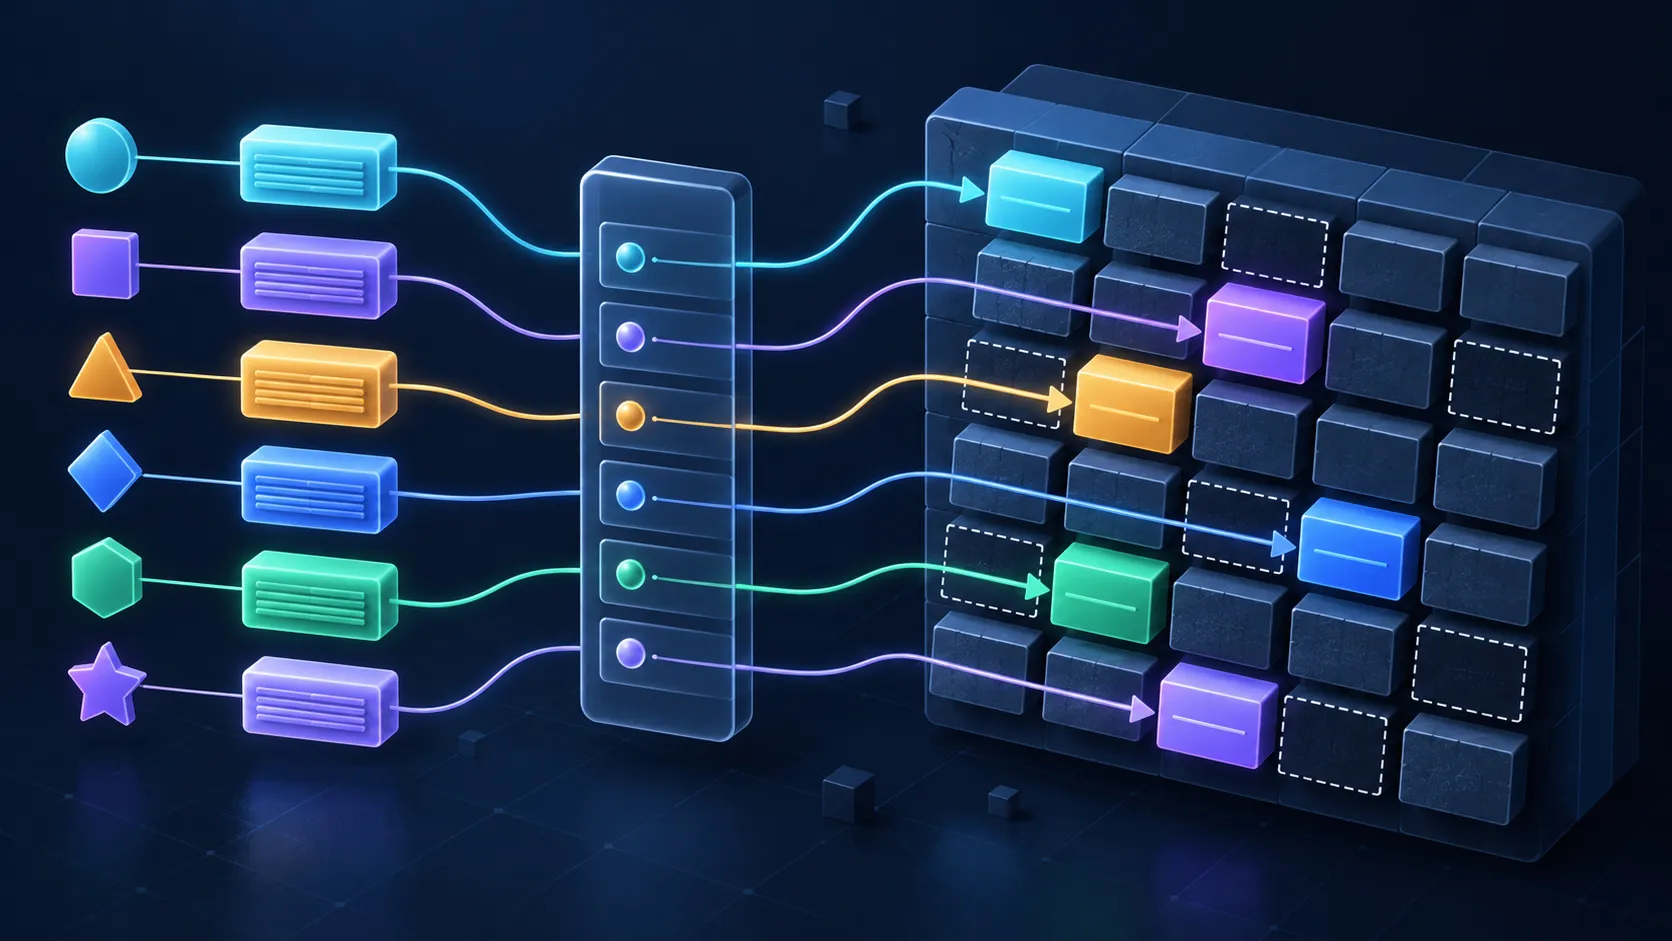 KV Cache 还有空间为何新请求却进不来?PagedAttention 的块表与碎片控制
从变长生成的显存碎片出发,手算逻辑块到物理块的映射,解释 PagedAttention 的动态增长、Copy-on-Write、调度契约与服务端验证。
16 分钟 中文
返回