-
 命中缓存却排队更久怎么办?Load-aware Routing 的亲和—负载权衡
从热门前缀制造单副本热点出发,手算缓存收益与相对负载评分,解释 β 阈值、冷副本溢出、陈旧指标和可验证调参。
17 分钟 中文 -
 同一段前缀该送到哪张卡?KV Cache-aware Routing 的命中定位与副本亲和
从轮询打散前缀缓存出发,手算最长块命中,把请求 token、KV 事件索引与副本选择串成可验证的 KV 缓存感知路由。
16 分钟 中文 -
 EOS 还没出现,怎样估计剩余生成量?输出长度的分位数预测与不确定性保护
从点预测低估导致错误调度出发,用分位数覆盖区间表达输出长度不确定性,手算 pinball loss,并实现可校准、可回退、可在线更新的长度预测器。
16 分钟 中文 -
 队列里谁该先生成?SLO-aware Scheduling 的剩余余量、抢占与公平性
从 FCFS 无法区分紧急程度出发,手算 deadline slack,用预测剩余服务时间排序请求,并讨论抢占成本、准入控制、aging 公平性与 vLLM priority 的实现边界。
15 分钟 中文 -
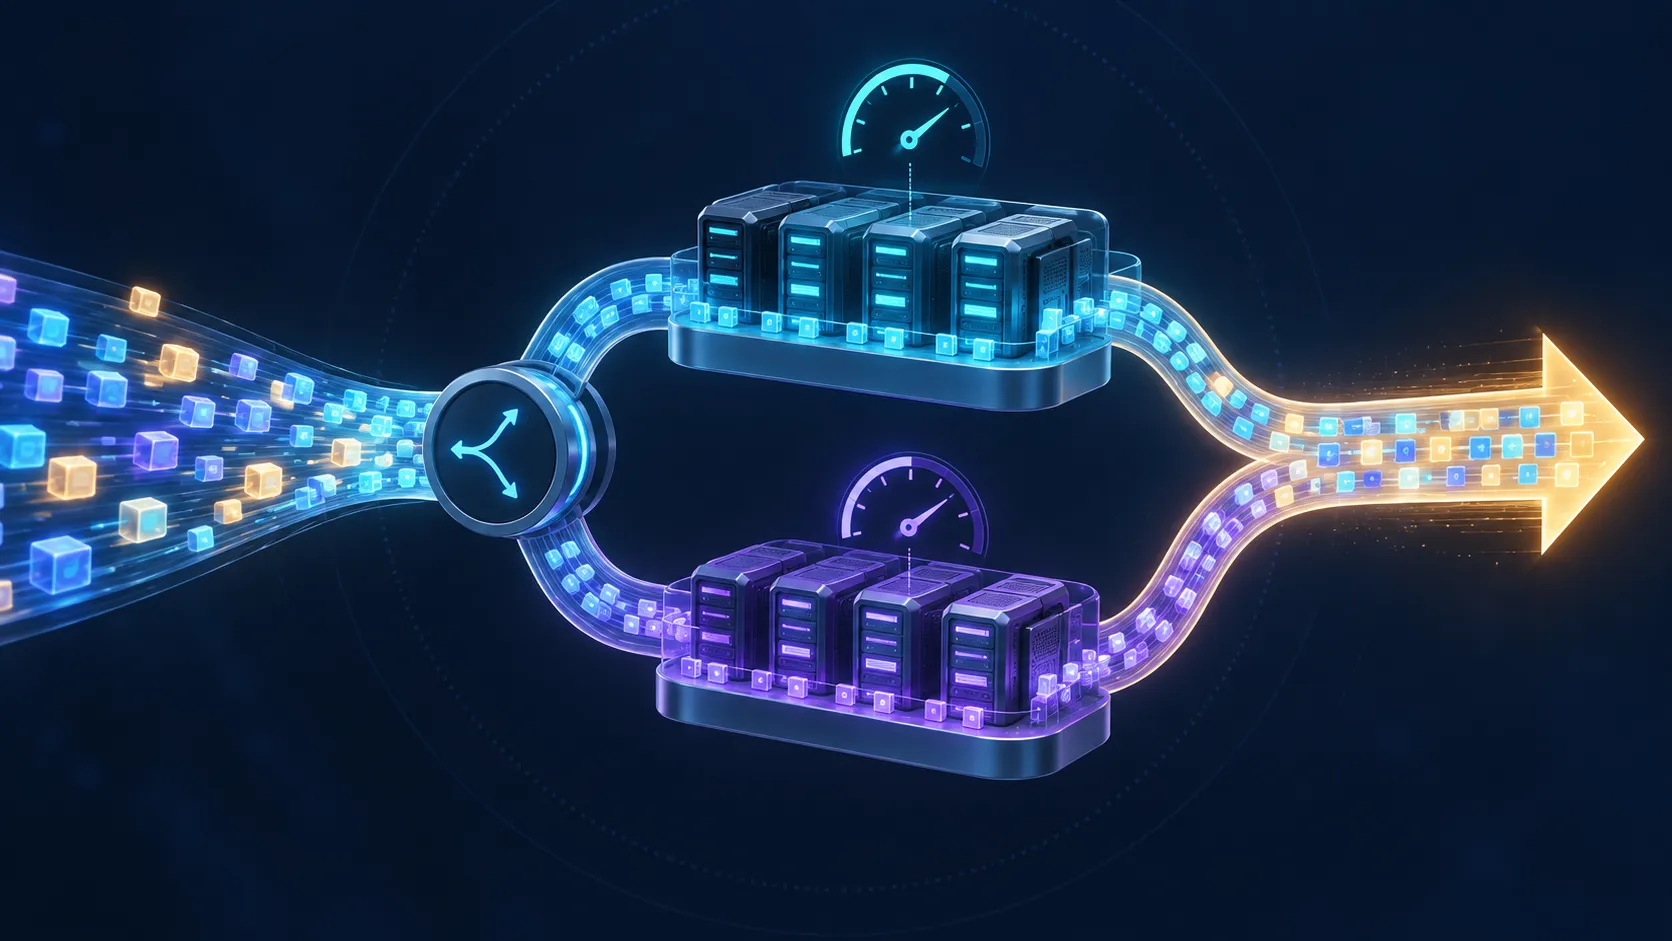 吞吐更高为何用户却更慢?用 SLO Goodput 为 Prefill/Decode 池配比
从吞吐与延迟目标的冲突出发,手算 SLO Goodput,用 token service demand 估算 P/D 容量,并通过负载扫描、分桶与排队指标找出可持续的流量边界。
14 分钟 中文 -
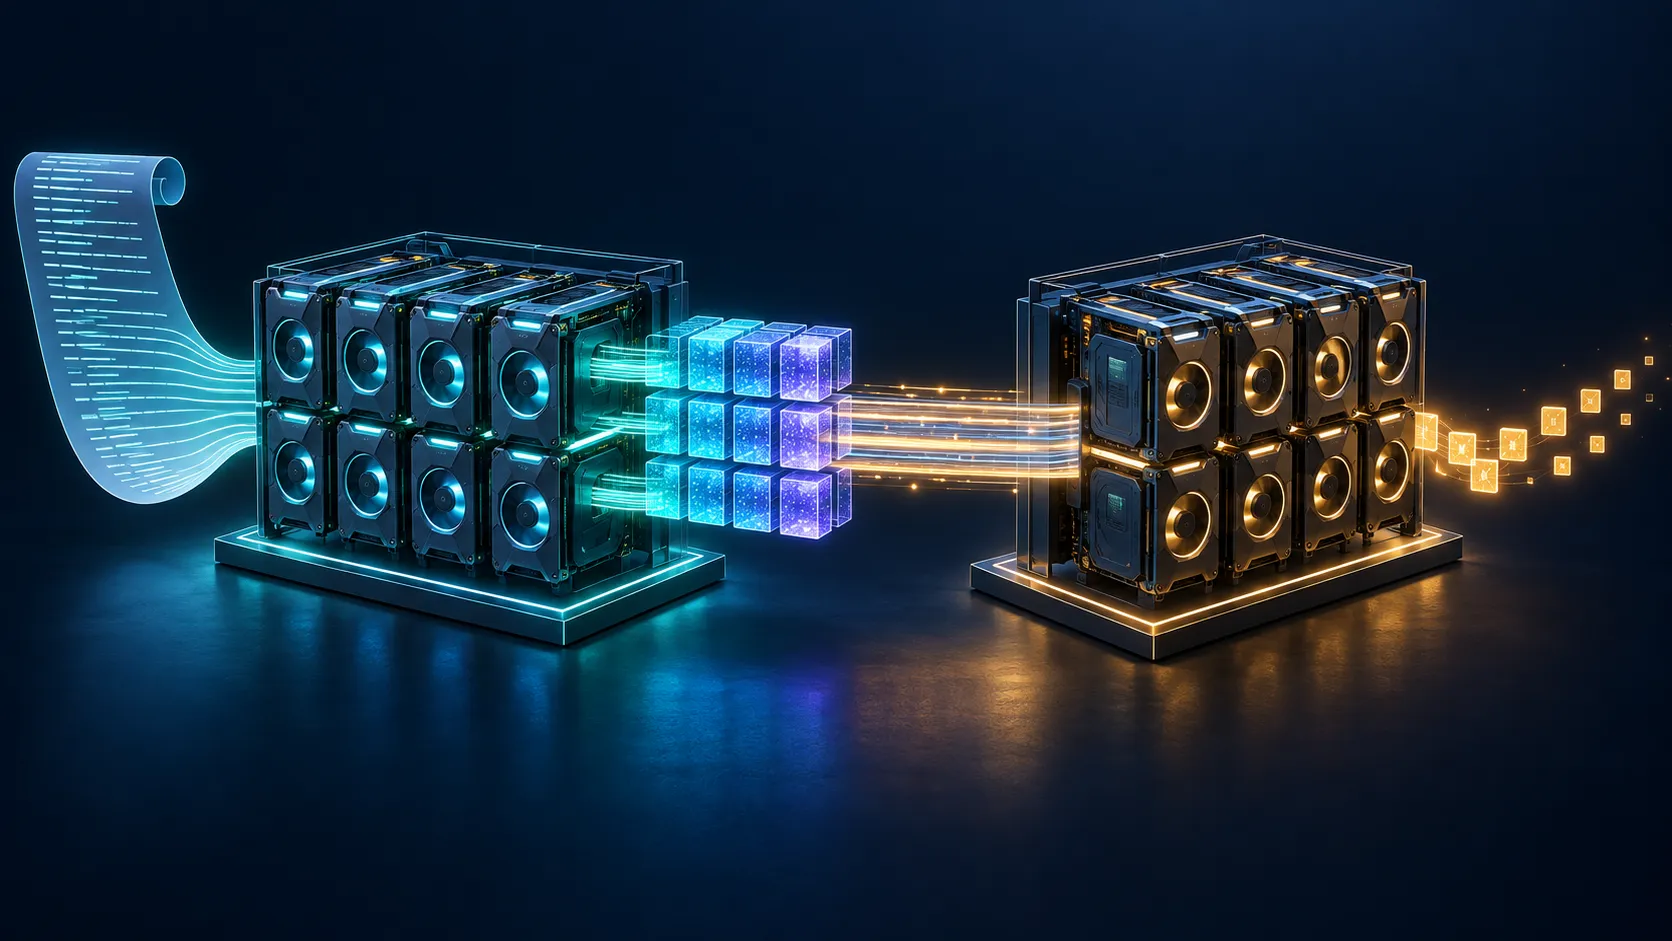 预填充为何会拖慢正在生成的请求?Disaggregated Prefill/Decode 的 KV 传输与资源隔离
从 Prefill–Decode 干扰出发,追踪请求跨 P/D 实例的数据流,手算 KV 体积与传输下限,说清分离为何改善尾延迟却不自动提升吞吐。
13 分钟 中文 -
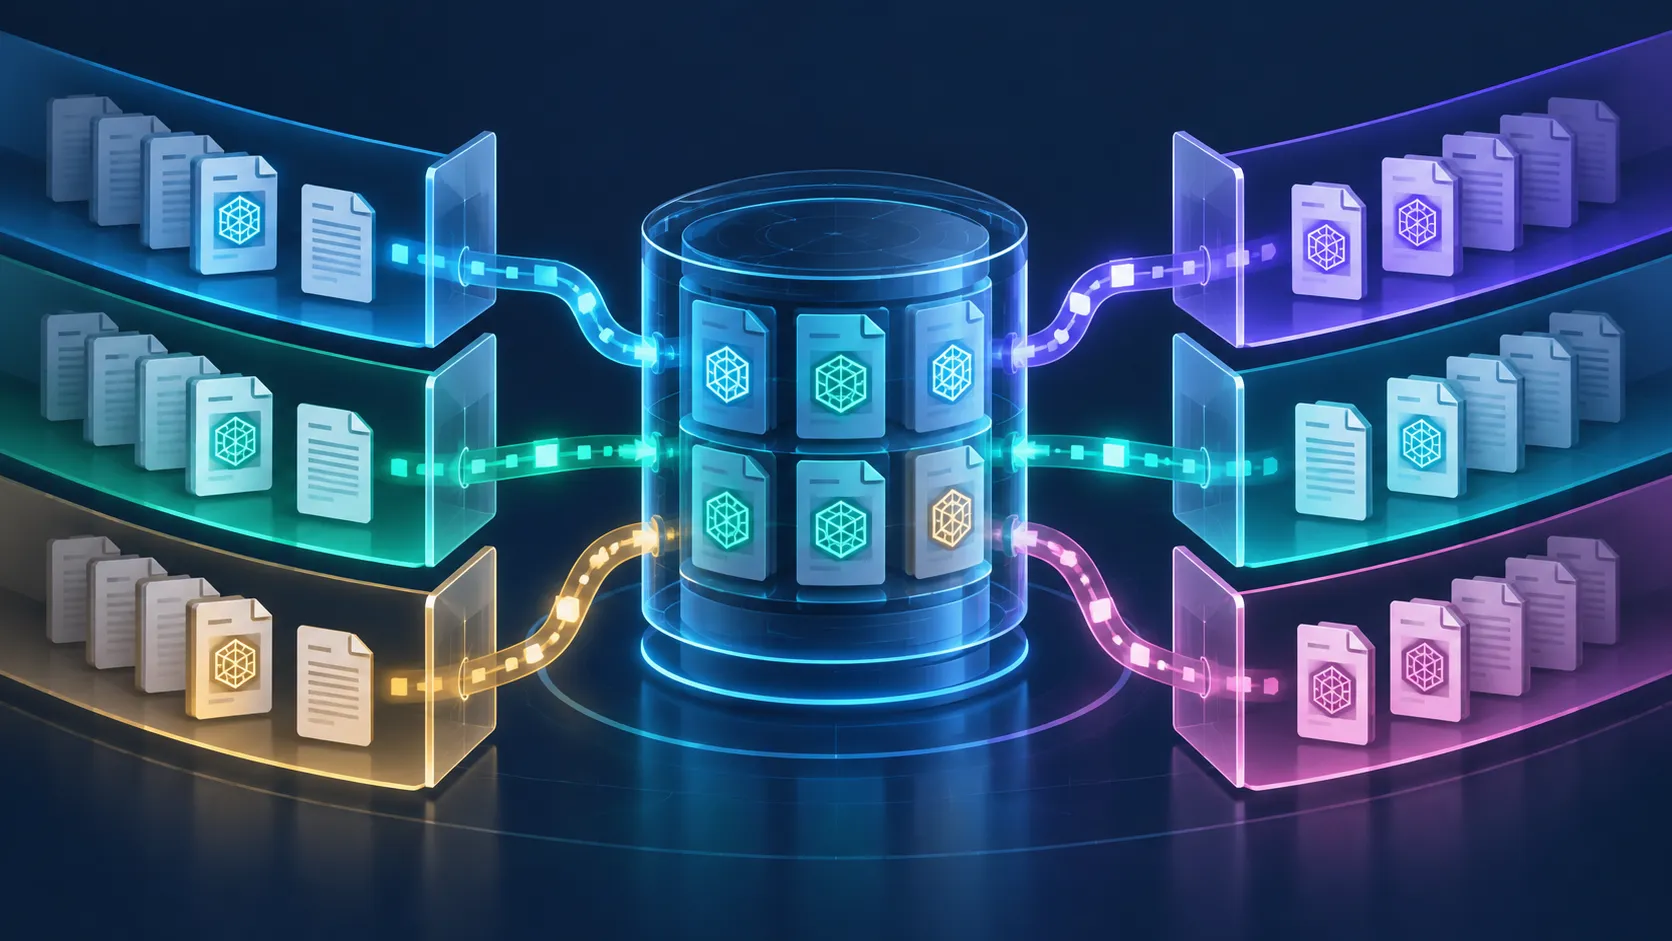 相同长文档为何每次都要重算?Automatic Prefix Caching 的块哈希与安全隔离
从重复 prefill 出发,手算块级最长前缀命中,追踪 KV 引用与淘汰,解释链式哈希、完整块粒度、多租户隔离及当前 vLLM 配置。
18 分钟 中文 -
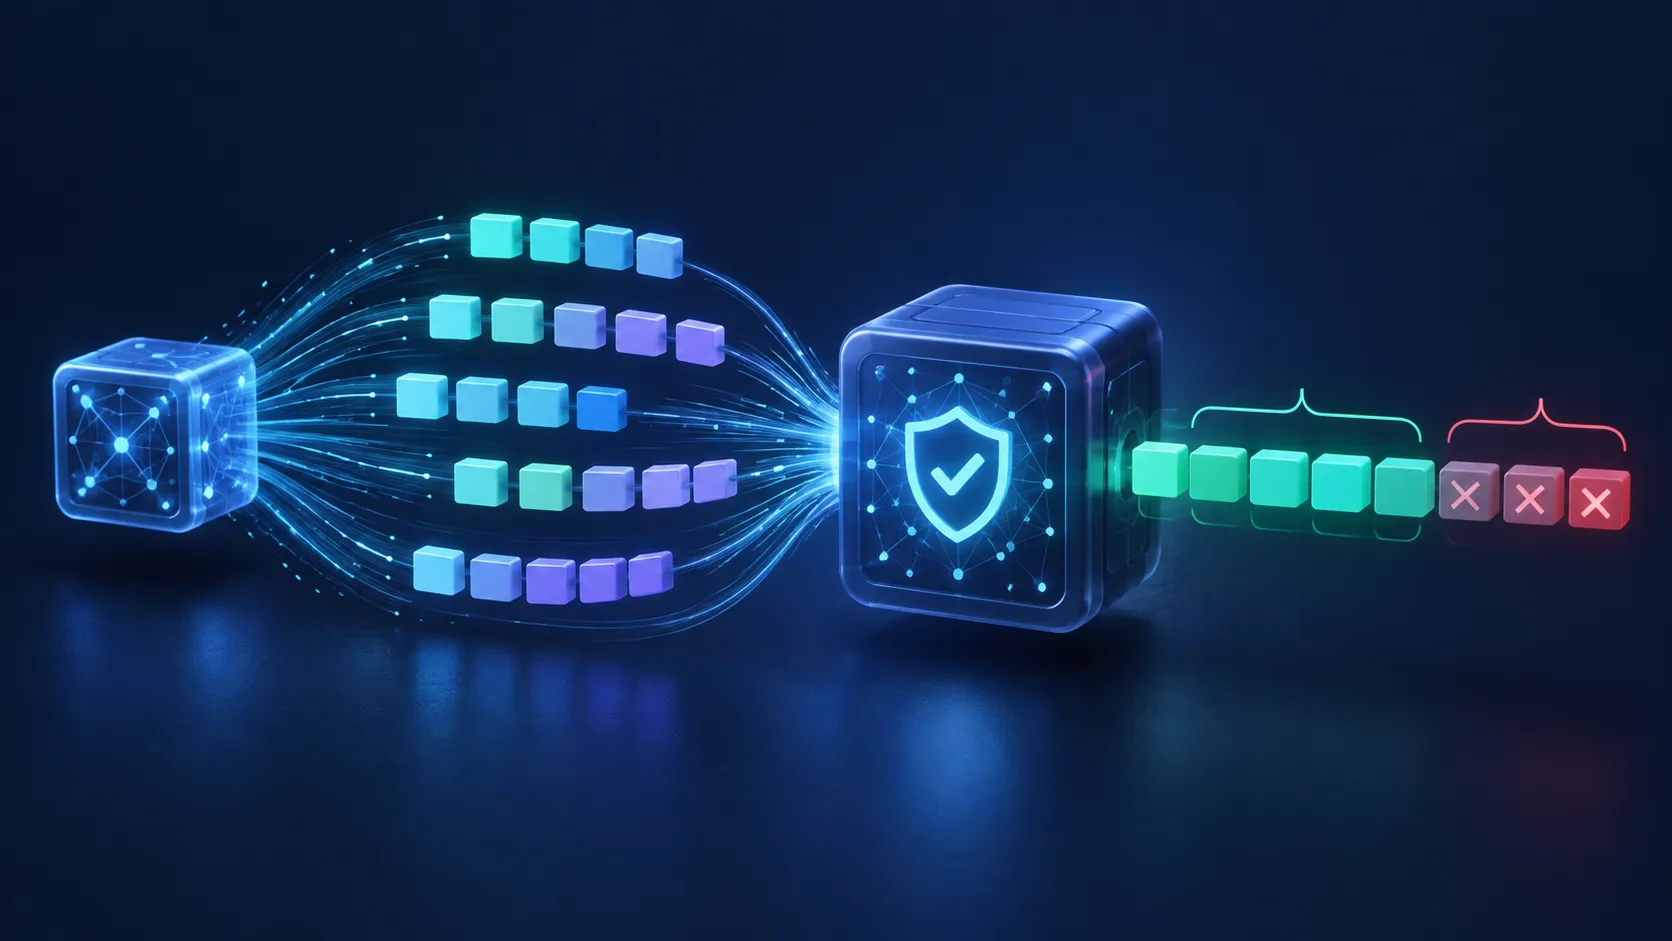 生成 4 个 Token 为何不一定要跑 4 次大模型?Speculative Decoding 的提议、验证与接受
从自回归解码的串行瓶颈出发,手算 draft–verify 接受过程,推导精确采样修正,追踪张量形状,并给出可检查实现、指标与失败边界。
16 分钟 中文
返回